

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: masa netto saszetki
40 różnych saszetek; jeden odczyt masy netto na saszetkę. Saszetki wylosowano z jednej partii produkcyjnej i zważono po uwzględnieniu tary.
Pobierz przykładowe dane (CSV, angielskie nagłówki)To ten sam przykład, który znajduje się w Help. Zaimportuj CSV, aby wykonać kolejne kroki, lub użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Means: One-Sample (t). Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Zaimportuj przykładowe dane
Pobierz powyższy plik CSV i zaimportuj go do arkusza. Wybierz Comma jako separator pól, Dot jako separator dziesiętny oraz First row contains column names.
3. Przypisz kolumnę wejściową
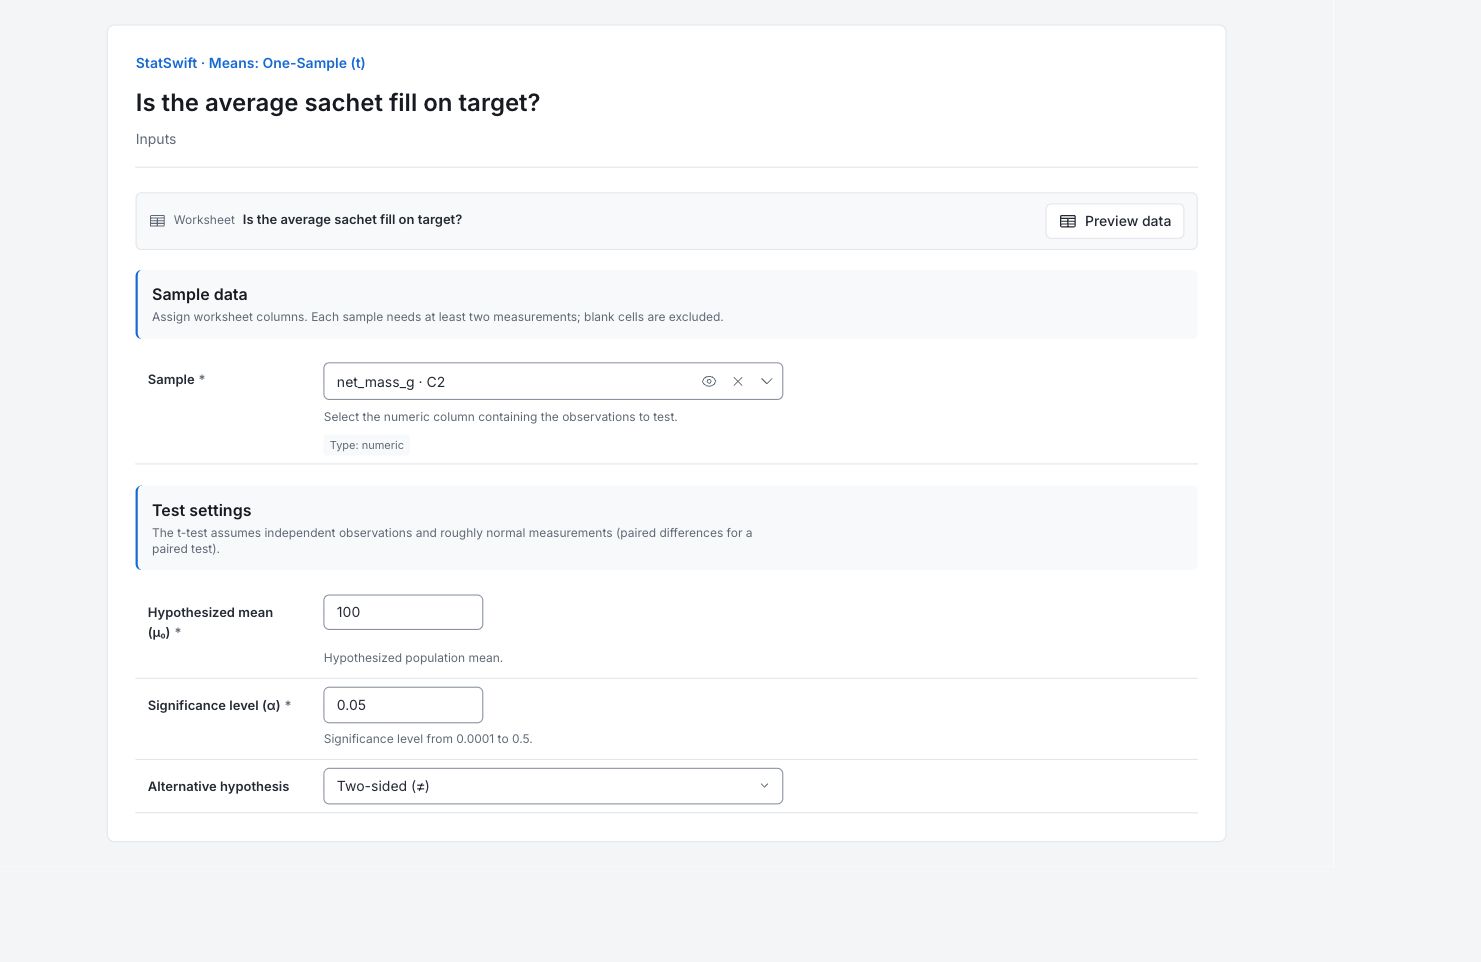
Na karcie Inputs otwórz Sample i wybierz net_mass_g.
4. Ustaw porównanie
Wpisz 100 w Hypothesized mean (μ₀) i 0.05 w Significance level (α). Wybierz Two-sided (≠) w Alternative hypothesis.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Określ pytanie
Każdy z 40 odczytów to masa netto innej saszetki. Test porównuje średnią populacji ze 100 g; nie ocenia każdej saszetki względem specyfikacji.
Odczytaj oszacowaną różnicę
Saszetki mają średnio 100.582 g, czyli 0.582 g powyżej celu. Różnica średnich to średnia próby minus cel, więc dodatnia wartość oznacza przeciętny nadmiar napełnienia.
Odczytaj przedział i test
Przedział 95% dla średniej minus cel wynosi 0.086–1.078 g. Pozostaje powyżej zera, a dwustronna wartość p wynosi 0.02253. Istnieją przesłanki przeciętnego nadmiaru napełnienia na poziomie 5%, przy niezależnych saszetkach i odpowiednim modelu testu t. Przedział opisuje średni nadmiar, a nie indywidualne masy.
Zdecyduj, czy nadmiar ma znaczenie
Porównaj wielkość i niepewność nadmiaru z uzgodnionym naddatkiem napełnienia i kosztem materiału. Sprawdź sposób próbkowania saszetek przed zmianą ustawień napełniarki.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Test t dla jednej próby
Statystyka t porównuje różnicę średnich z jej błędem standardowym. Stopnie swobody wynoszą 39, z 40 saszetek. Średnia docelowa wynosi 100 g. Alfa 0.05 i dwustronna alternatywa dokumentują test; poziom ufności wynosi 95%. Dolna i górna granica CI ograniczają średnią minus cel w g. Wartość p testuje średnią równą celowi przy założeniach testu; nie jest prawdopodobieństwem prawdziwości celu.
| Statystyka | Wartość |
|---|---|
| Statystyka t | 2.37565 |
| Stopnie swobody | 39 |
| wartość p | 0.0225278 |
| Różnica średnich | 0.582 |
| Błąd standardowy | 0.244985 |
| Średnia docelowa (μ₀) | 100 |
| Alfa | 0.05 |
| Hipoteza alternatywna | two-sided |
| Poziom ufności (%) | 95 |
| Dolna granica PU | 0.0864703 |
| Górna granica PU | 1.07753 |
- Odrzuć H₀ (μ = 100.0) przy α=0.05 (p=0.0225)
- H₀: μ = 100.0
- H₁: μ ≠ 100.0
7. Utwórz raport
Zachowaj pełną tabelę One-sample t-test, cel, kierunek różnicy, przedział ufności i kontekst próbkowania. Wyjaśnij, że przedział dotyczy średniej, a nie zgodności pojedynczych saszetek. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.