

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: ファームウェアのスキャン時間
24枚のラベルを、それぞれ両方のファームウェアで一回ずつ評価します。24行のペアで、スキャン時間の測定値は48個です。読み取りに用いるファームウェアの順序は、ラベル間で均等に割り付け、ランダム化しています。
例のデータをダウンロード(CSV、列名は英語)Help で使用している例と同じです。CSVをインポートして手順に沿って操作するか、Helpの Open example in a practice copy を使用して入力値をあらかじめ設定します。
1. ワークスペースを作成
サイドバーで Basic Statistics を開き、Means: Two-Sample (t) を選択します。分析を作成して名前を付け、New blank worksheet を選択してから Create analysis を選択します。
2. 例のデータをインポート
上のCSVをダウンロードし、ワークシートにインポートします。区切り文字は Comma、小数点記号は Dot を選択し、First row contains column names を指定します。
3. 入力列を割り当て
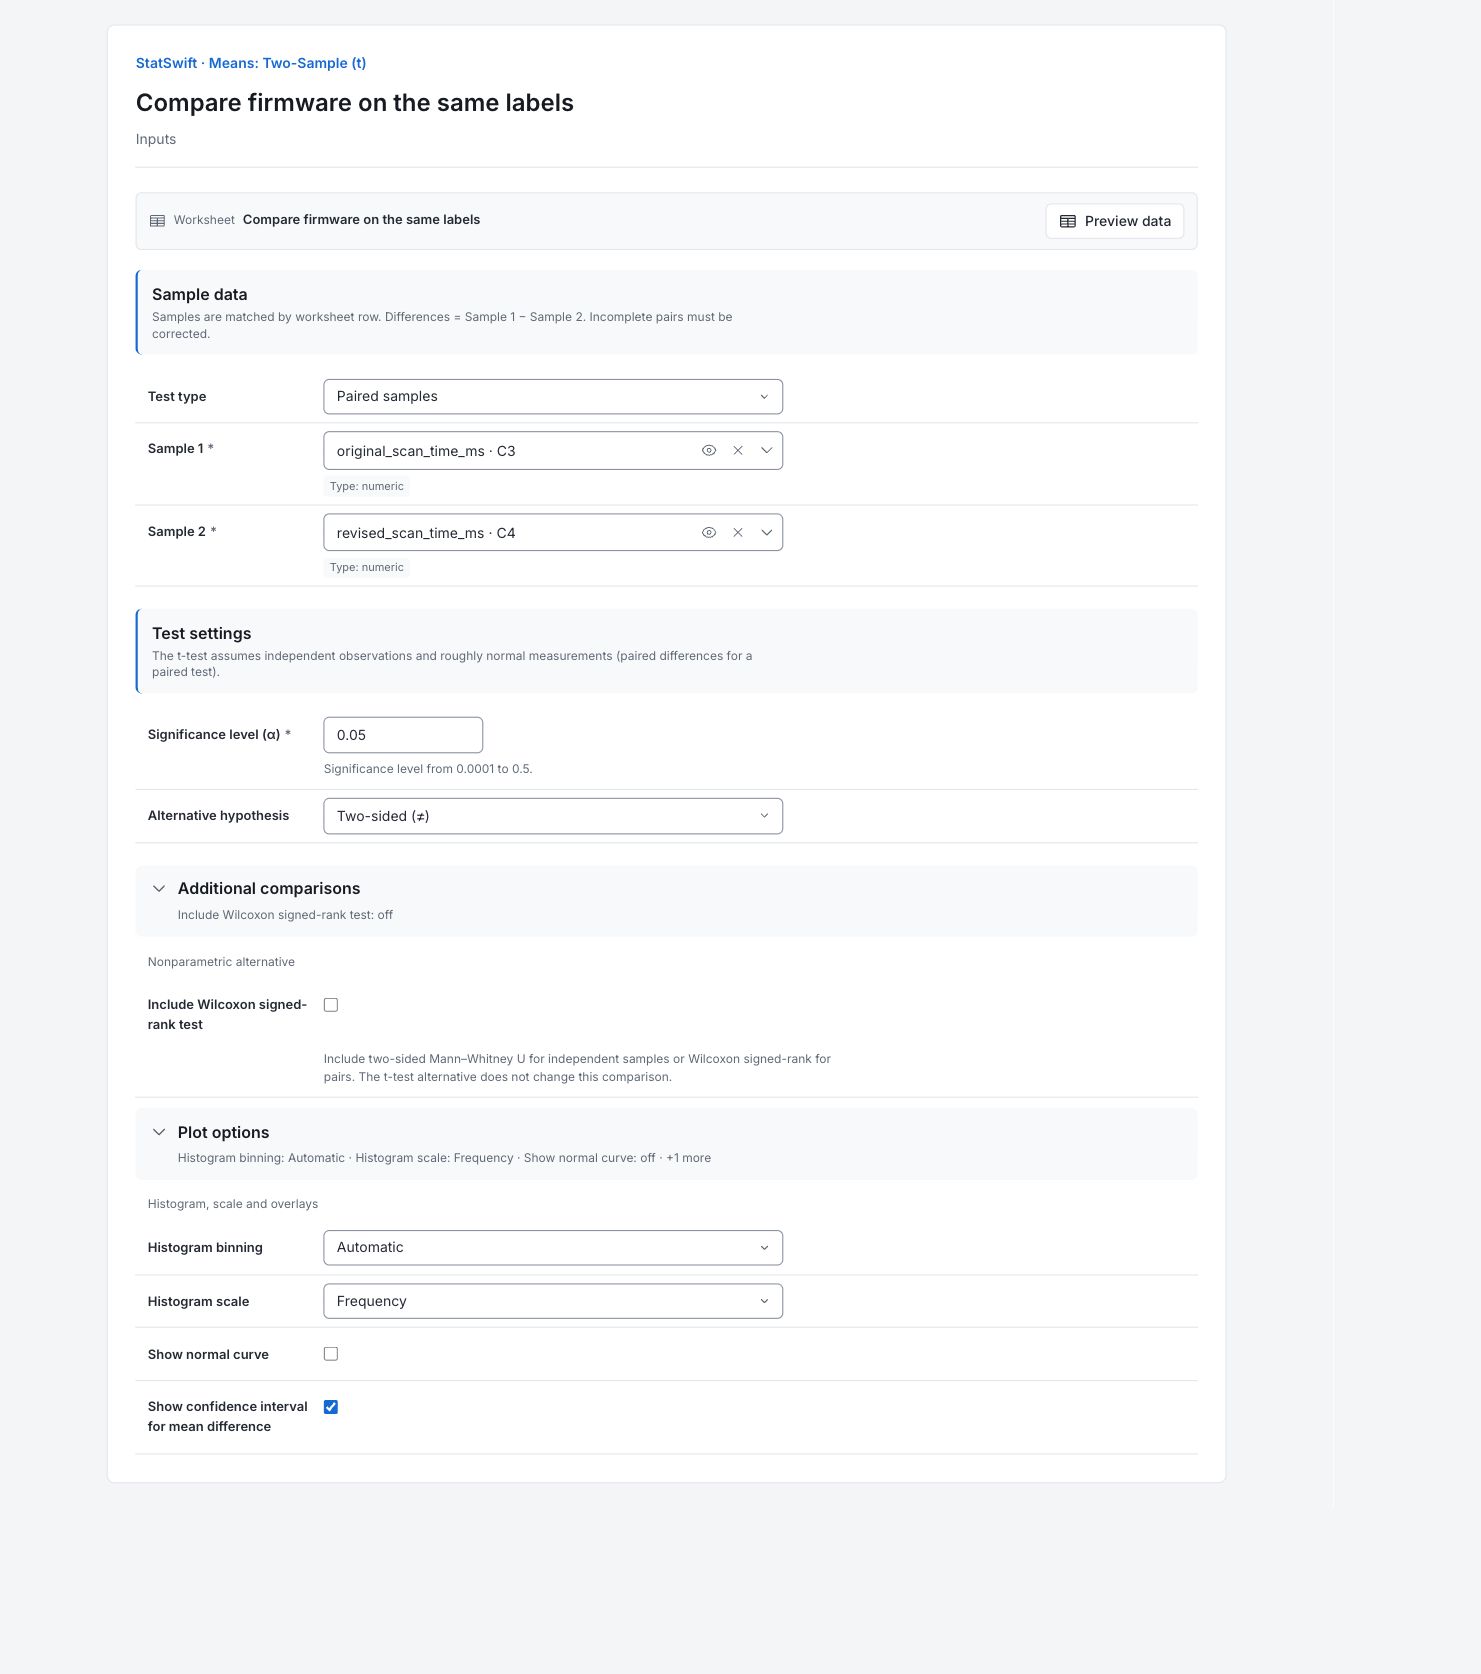
Inputs の Test type で Paired samples を選択します。Sample 1 に original_scan_time_ms、Sample 2 に revised_scan_time_ms を割り当てます。ワークシートの各行には、同じラベルの両方の測定値を含める必要があります。並べ替える際も、ペアを一緒に保ちます。
4. 検定とグラフを設定
Significance level (α) に 0.05 を入力し、Alternative hypothesis で Two-sided (≠) を選択します。Additional comparisons を開き、Include Wilcoxon signed-rank test は選択しません。
Plot options を開きます。Histogram binning を Automatic、Histogram scale を Frequency に設定します。Show normal curve は選択せず、Show confidence interval for mean difference を選択します。
5. 分析を実行
Run analysis を選択し、Results を開きます。
6. 結果を解釈
対応のある比較を明確にする
同じ24枚のラベルを、両方のファームウェアで試験しました。差は、元のスキャン時間から改訂版のスキャン時間を引いた値です。差が正なら、そのラベルでは改訂版のほうが速かったことを意味します。出力ラベルのBeforeとAfterは、元のファームウェアと改訂版を意味し、実際の読み取り順序を示すものではありません。
平均差と区間を確認
平均短縮時間は19.35 msです。95%区間は15.05–23.64 msで、全体がゼロを上回り、p = 2.813 × 10⁻⁹です。不確かさは、別々の二標本のばらつきではなく、同じラベル内の24個の差から求めます。

英語のグラフ:平均差の信頼区間。 グラフを原寸で表示 (新しいタブで開きます) 標本の分布の形を比較
箱は各標本の中央の半分を示し、箱の中の線は中央値です。ひげとフェンス超過のフラグは観測値を記述するものであり、合否判定限界ではありません。対応のある検定では、これらの別々の箱は、同じラベル内の差のばらつきを示していません。

英語のグラフ:標本の箱ひげ図。 グラフを原寸で表示 (新しいタブで開きます) ヒストグラムを確認
棒の高さは、値の区間に含まれる測定値の件数を表します。棒を信頼限界として扱わずに、形とばらつきを比較します。対応のある検定の前提については、同じラベル内の差も確認します。

英語のグラフ:標本のヒストグラム。 グラフを原寸で表示 (新しいタブで開きます) 結果が支持する範囲を判断
推定された平均15–24 msの短縮を、スキャン作業で必要な時間短縮と比較します。代表的なラベルと条件で確認します。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
対応のあるt検定
平均差は標本1から標本2を引いた値で、標準誤差はその不確かさを測ります。t統計量は、差を標準誤差で割った値です。自由度、α、対立仮説、方法、信頼水準は、推測の条件を記録します。信頼区間の下限と上限は、母平均の差の範囲を示します。対応のある比較の不確かさには、同じラベル内の差を使用します。自由度は23です。
| 統計量 | 値 |
|---|---|
| t統計量 | 9.3244 |
| 自由度 | 23 |
| p値 | 2.81325e-9 |
| 平均差 | 19.3458 |
| 標準誤差 | 2.07475 |
| α | 0.05 |
| 対立仮説 | two-sided |
| 方法 | 対応のあるt検定 |
| 信頼水準(%) | 95 |
| 信頼区間の下限 | 15.0539 |
| 信頼区間の上限 | 23.6378 |
- α=0.05(p=2.81e-09)でH₀ (μ𝑑 = 0)を棄却します。
- H₀: μ𝑑 = 0
- H₁: μ𝑑 ≠ 0
標本の要約
nは測定値の件数です。平均、中央値、最小値、最大値、範囲は各標本を記述します。標準偏差(SD)は標本のばらつき、標準誤差(SE)はその平均の不確かさ、IQRは中央の半分の広がりを表します。完全なペアが24組あります。別々の標本のSEは、対応のある差のSEではありません。
| 標本 | n | 平均 | 標準偏差(SD) | 標準誤差(SE) | 中央値 | 最小値 | 最大値 | 範囲 | 四分位範囲(IQR) |
|---|---|---|---|---|---|---|---|---|---|
| Before | 24 | 281.213 | 36.2839 | 7.40641 | 274.45 | 216.9 | 349.5 | 132.6 | 50.775 |
| After | 24 | 261.867 | 39.2201 | 8.00576 | 258.7 | 176.1 | 330.3 | 154.2 | 63.75 |
箱ひげ図の座標
Q1とQ3は中央の半分の境界で、その間に中央値があります。IQRはQ3からQ1を引いた値です。下側と上側のフェンスには1.5 × IQRを用い、ひげはフェンス内で最も外側にある観測値まで伸びます。これらの座標は合否判定限界ではありません。
| 標本 | Q1 | 中央値 | Q3 | 四分位範囲(IQR) | 下側フェンス | 上側フェンス | 下側ひげ | 上側ひげ |
|---|---|---|---|---|---|---|---|---|
| Before | 256.475 | 274.45 | 307.25 | 50.775 | 180.313 | 383.412 | 216.9 | 349.5 |
| After | 230.55 | 258.7 | 294.3 | 63.75 | 134.925 | 389.925 | 176.1 | 330.3 |
箱ひげ図のフラグ
各行には、フェンスを超えた値の「標本」「ワークシートの行」「値」が示されます。この表が空であることは、どちらの標本にもフェンス超過のフラグがないことを意味します。フラグは調査のきっかけであり、自動的に削除する理由ではありません。
| 標本 | ワークシートの行 | 値 |
|---|
このセクションで返された行はありません。
7. レポートを作成
Paired t-test 全体、Sample summaries、箱ひげ図の座標とフラグ、平均差の区間、箱ひげ図、ヒストグラムを残します。標本1から標本2を引くことと、ラベルで対応付けていることを明記します。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。