

Los comandos de la aplicación, los identificadores de las hojas de trabajo y los valores de los datos de ejemplo conservan su redacción original. Las capturas de pantalla, los gráficos y las descargas están en inglés. Los ejemplos conservan la notación numérica original en inglés: punto decimal y coma como separador de millares.
Ejemplo: tiempo de escaneo según el firmware
24 etiquetas, evaluadas una vez con cada versión de firmware: 24 filas pareadas y 48 lecturas del tiempo de escaneo. El orden de las lecturas con cada firmware se equilibró y aleatorizó entre etiquetas.
Descargar los datos de ejemplo (CSV, columnas en inglés)Es el mismo ejemplo que se utiliza en Help. Importa el CSV para seguir los pasos, o utiliza Open example in a practice copy en Help para rellenar previamente las entradas.
1. Crear el espacio de trabajo
En la barra lateral, abre Basic Statistics y elige Means: Two-Sample (t). Crea un análisis, ponle un nombre, selecciona New blank worksheet y elige Create analysis.
2. Importar los datos de ejemplo
Descarga el CSV anterior e impórtalo en la hoja de trabajo. Elige Comma como delimitador, Dot como separador decimal y First row contains column names.
3. Asignar las columnas de entrada
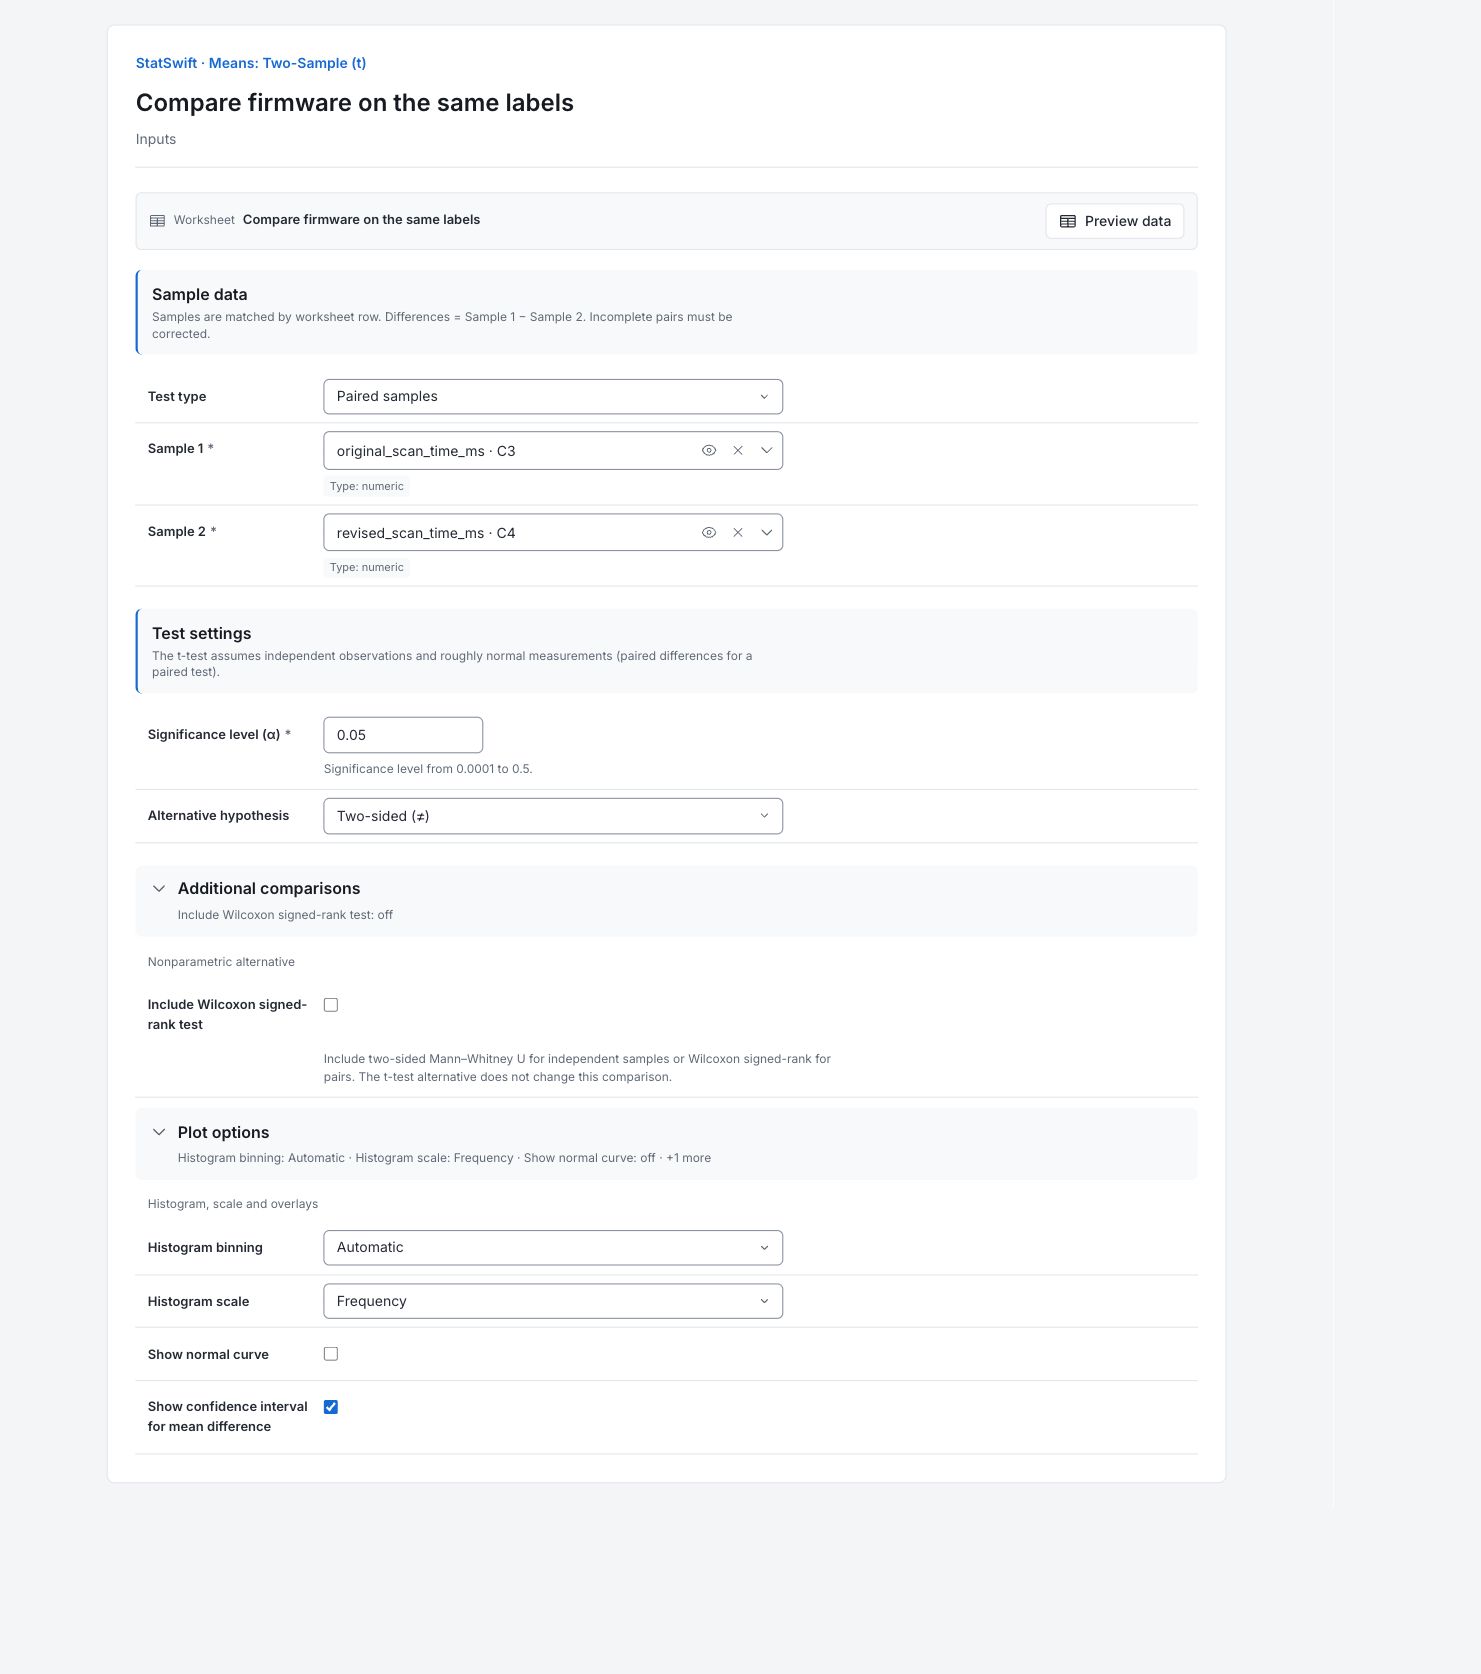
En Inputs, elige Paired samples en Test type. Asigna original_scan_time_ms a Sample 1 y revised_scan_time_ms a Sample 2. Cada fila de la hoja de trabajo debe contener ambas lecturas de la misma etiqueta. Mantén cada par unido al ordenar los datos.
4. Configurar el contraste y los gráficos
Introduce 0.05 en Significance level (α) y elige Two-sided (≠) en Alternative hypothesis. Abre Additional comparisons y deja Include Wilcoxon signed-rank test sin marcar.
Abre Plot options. Establece Histogram binning en Automatic y Histogram scale en Frequency. Deja Show normal curve sin marcar y marca Show confidence interval for mean difference.
5. Ejecutar el análisis
Elige Run analysis y abre Results.
6. Interpretar los resultados
Mantener clara la comparación pareada
Las mismas 24 etiquetas se probaron con ambas versiones de firmware. Las diferencias son el tiempo de escaneo original menos el revisado. Una diferencia positiva significa que la versión revisada fue más rápida con esa etiqueta. Las etiquetas de salida Before y After significan firmware original y revisado; no describen el orden cronológico de lectura.
Leer la diferencia media y el intervalo
La reducción media es 19.35 ms. Su intervalo del 95% es 15.05–23.64 ms, completamente por encima de cero, con p = 2.813 × 10⁻⁹. La incertidumbre procede de las 24 diferencias dentro de cada etiqueta, no de las dispersiones de las dos muestras por separado.

Gráfico en inglés: intervalo de confianza para la diferencia Ver gráfico a tamaño completo (se abre en una nueva pestaña) Comparar las formas de las muestras
Las cajas muestran la mitad central de cada muestra, con la mediana dentro. Los bigotes y los valores señalados por los umbrales describen las observaciones, no límites de aceptación. En un contraste pareado, estas cajas separadas no muestran la dispersión de las diferencias dentro de cada etiqueta.

Gráfico en inglés: diagramas de caja de las muestras Ver gráfico a tamaño completo (se abre en una nueva pestaña) Leer el histograma
Las alturas de las barras cuentan mediciones en intervalos de valores. Compara la forma y la dispersión sin tratar las barras como límites de confianza. Para comprobar los supuestos del contraste pareado, examina también las diferencias dentro de cada etiqueta.

Gráfico en inglés: histograma de las muestras Ver gráfico a tamaño completo (se abre en una nueva pestaña) Decidir qué respalda el resultado
Compara la mejora media estimada de 15–24 ms con el ahorro necesario en el flujo de trabajo de escaneo. Confírmala con etiquetas y condiciones representativas.
Más detalles: leer cada sección de resultados
Las tablas de resultados completas utilizan seis cifras significativas, como en Help.
Contraste t pareado
La diferencia de medias es la muestra 1 menos la muestra 2; el error estándar mide su incertidumbre. El estadístico t es la diferencia dividida entre el error estándar. Los grados de libertad, α, la hipótesis alternativa, el método y el nivel de confianza documentan la inferencia. Los límites inferior y superior del IC delimitan la diferencia de medias poblacionales. La incertidumbre pareada utiliza las diferencias dentro de cada etiqueta; hay 23 grados de libertad.
| Estadístico | Valor |
|---|---|
| Estadístico t | 9.3244 |
| Grados de libertad | 23 |
| Valor p | 2.81325e-9 |
| Diferencia de medias | 19.3458 |
| Error estándar | 2.07475 |
| α | 0.05 |
| Hipótesis alternativa | two-sided |
| Método | Prueba t pareada |
| Nivel de confianza (%) | 95 |
| Límite inferior del intervalo de confianza | 15.0539 |
| Límite superior del intervalo de confianza | 23.6378 |
- Rechazar H₀ (μ𝑑 = 0) con α=0.05 (p=2.81e-09)
- H₀: μ𝑑 = 0
- H₁: μ𝑑 ≠ 0
Resúmenes muestrales
n cuenta las lecturas; la media, la mediana, el mínimo, el máximo y el rango describen cada muestra. La desviación estándar es la dispersión muestral, el error estándar es la incertidumbre de su media y el rango intercuartílico describe la dispersión de la mitad central. Hay 24 pares completos. Los errores estándar de las muestras por separado no son el error estándar de la diferencia pareada.
| Muestra | n | Media | Desviación estándar | Error estándar | Mediana | Mínimo | Máximo | Rango | Rango intercuartílico (IQR) |
|---|---|---|---|---|---|---|---|---|---|
| Before | 24 | 281.213 | 36.2839 | 7.40641 | 274.45 | 216.9 | 349.5 | 132.6 | 50.775 |
| After | 24 | 261.867 | 39.2201 | 8.00576 | 258.7 | 176.1 | 330.3 | 154.2 | 63.75 |
Coordenadas de los diagramas de caja
Q1 y Q3 delimitan la mitad central, con la mediana entre ambos. IQR es Q3 menos Q1. Los umbrales inferior y superior utilizan 1.5 × IQR; los bigotes terminan en las observaciones extremas dentro de esos umbrales. Estas coordenadas no son límites de aceptación.
| Muestra | Q1 | Mediana | Q3 | Rango intercuartílico (IQR) | Umbral inferior para valores atípicos | Umbral superior para valores atípicos | Bigote inferior | Bigote superior |
|---|---|---|---|---|---|---|---|---|
| Before | 256.475 | 274.45 | 307.25 | 50.775 | 180.313 | 383.412 | 216.9 | 349.5 |
| After | 230.55 | 258.7 | 294.3 | 63.75 | 134.925 | 389.925 | 176.1 | 330.3 |
Valores señalados por los diagramas de caja
Cada fila identificaría una muestra, una fila de la hoja de trabajo y un valor más allá de un umbral. Esta tabla vacía significa que ninguna muestra tiene valores señalados por esos umbrales. Un valor señalado requeriría investigación, no su eliminación automática.
| Muestra | Fila de la hoja de trabajo | Valor |
|---|
No se devolvieron filas para esta sección.
7. Crear un informe
Conserva Paired t-test y Sample summaries completos, las coordenadas y los valores señalados de los diagramas de caja, el intervalo de la diferencia, los diagramas de caja y el histograma. Indica que la diferencia es la muestra 1 menos la muestra 2 y que el emparejamiento es por etiqueta.
Selecciona Add to report de la ejecución completada. Abre Choose individual items and advanced options para seleccionar tablas y gráficos y, a continuación, selecciona Add to draft. Los elementos ocultos se conservan en el análisis guardado.
Asigna un nombre al informe y añade el objetivo del estudio y tu interpretación. Selecciona Save, revisa Preview, y después utiliza Export → Download HTML. El ejemplo siguiente contiene todo el contenido seleccionado, incluidos los resultados que no caben en una sola pantalla.