

Os comandos da aplicação, os identificadores das folhas de cálculo e os valores dos dados dos exemplos mantêm a sua forma original. As capturas de ecrã, os gráficos e os ficheiros para transferência estão em inglês. Os exemplos científicos conservam o ponto decimal e a vírgula como separador de milhares da fonte original; os preços e as contagens do sítio seguem as convenções portuguesas.
Exemplo: tempo de leitura com o firmware
24 etiquetas, cada uma avaliada uma vez com cada versão do firmware: 24 linhas emparelhadas e 48 leituras do tempo de leitura. A ordem de leitura do firmware foi equilibrada e aleatorizada entre etiquetas.
Transferir os dados de exemplo (CSV)Este é o mesmo exemplo utilizado em Help. Importe o CSV para seguir os passos ou utilize Open example in a practice copy na Ajuda para preencher previamente as entradas.
1. Crie o espaço de trabalho
Na barra lateral, abra Basic Statistics e escolha Means: Two-Sample (t). Crie uma análise, atribua-lhe um nome, selecione New blank worksheet e escolha Create analysis.
2. Importe os dados do exemplo
Transfira o CSV acima e importe-o para a folha de cálculo. Escolha Comma como delimitador, Dot como separador decimal e First row contains column names.
3. Atribua as colunas de entrada
Em Inputs, escolha Paired samples em Test type. Atribua original_scan_time_ms a Sample 1 e revised_scan_time_ms a Sample 2. Cada linha da folha de cálculo deve conter ambas as leituras da mesma etiqueta. Mantenha o par unido ao ordenar.
4. Defina o teste e os gráficos
Introduza 0.05 em Significance level (α) e escolha Two-sided (≠) em Alternative hypothesis. Abra Additional comparisons e deixe Include Wilcoxon signed-rank test desmarcado.
Abra Plot options. Defina Histogram binning como Automatic e Histogram scale como Frequency. Deixe Show normal curve desmarcado e selecione Show confidence interval for mean difference.
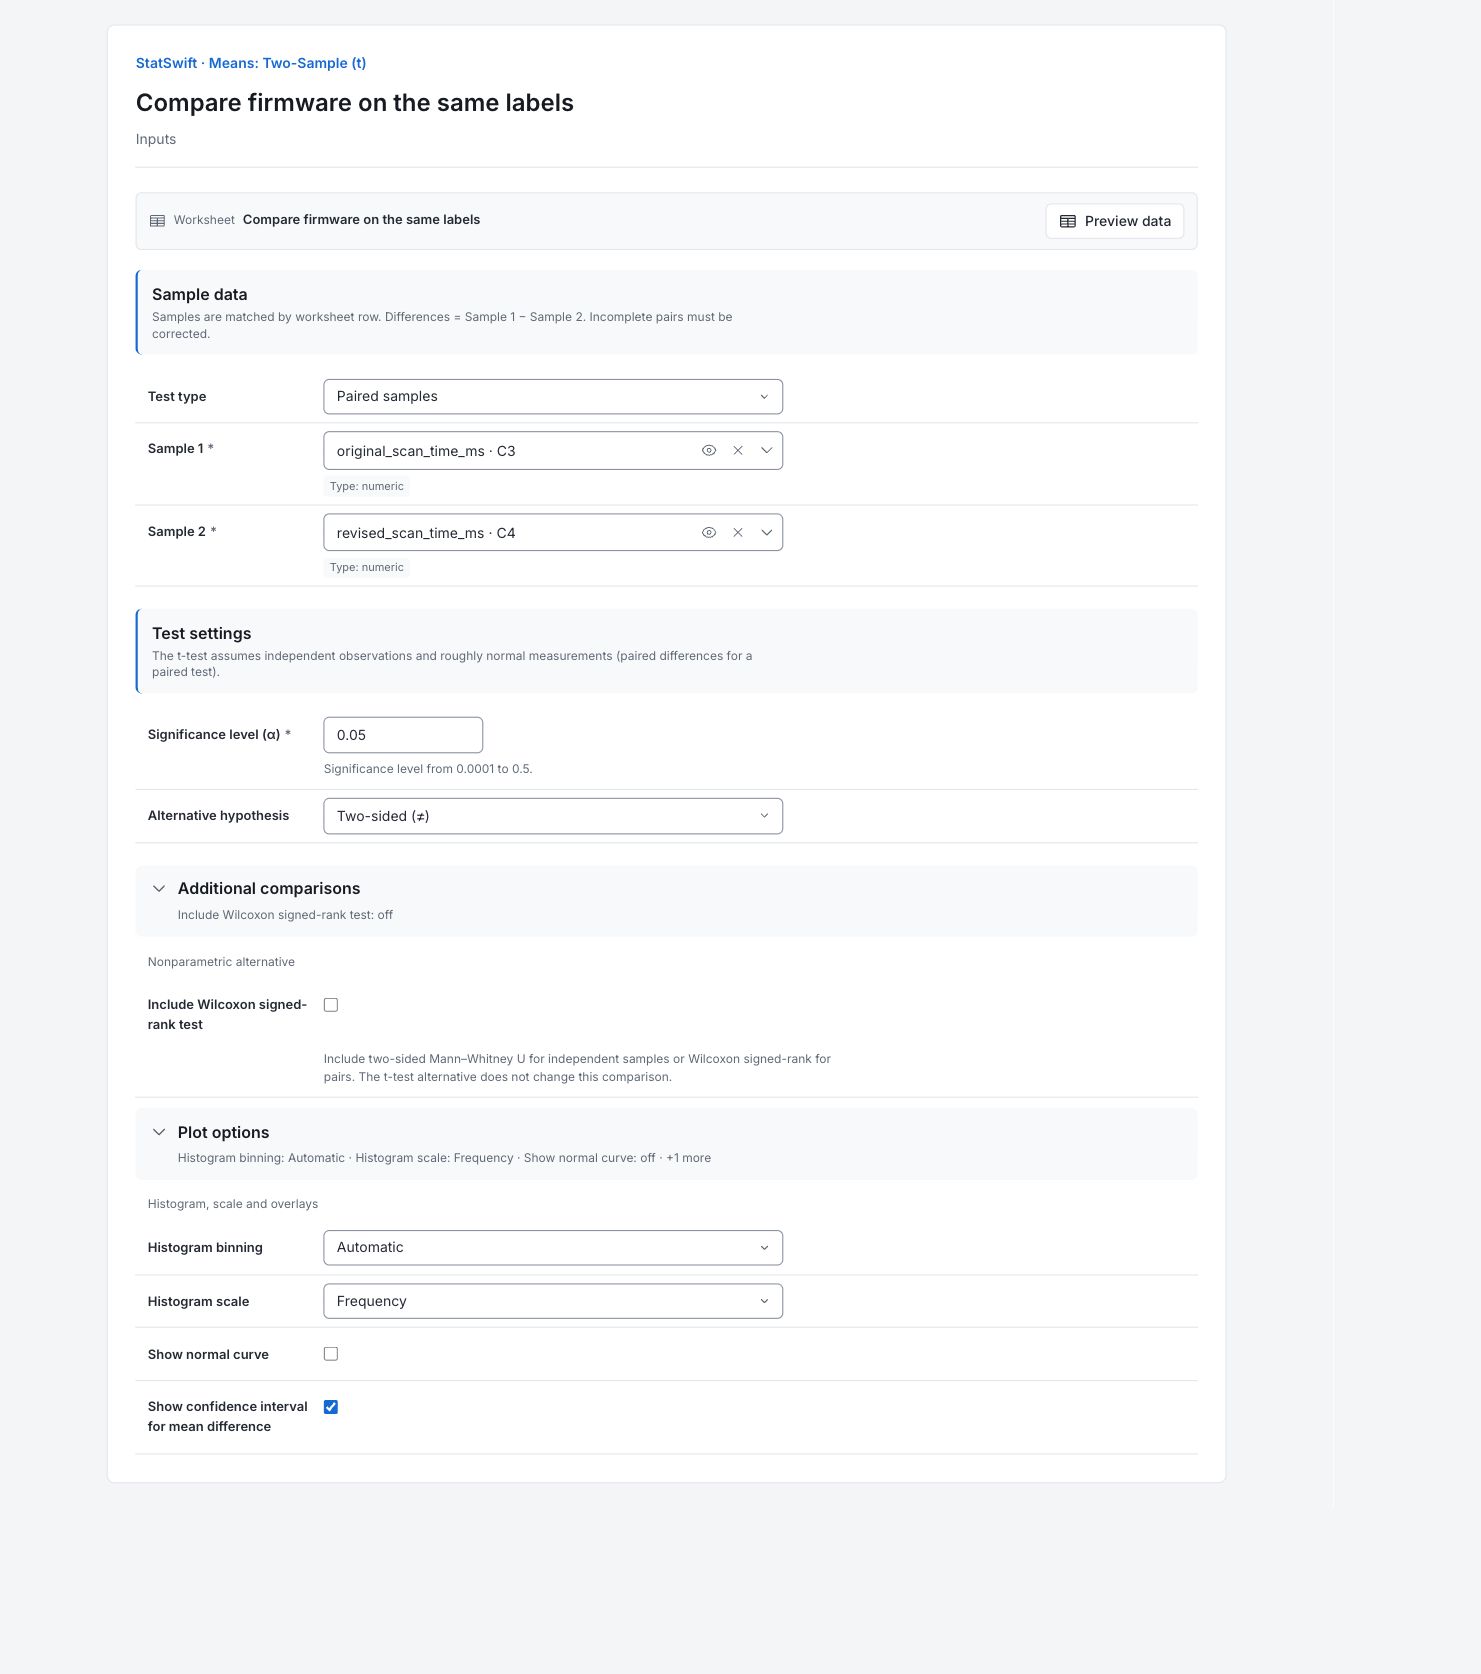
5. Execute a análise
Escolha Run analysis e abra Results.
6. Interpretar resultados
Mantenha clara a comparação emparelhada
As mesmas 24 etiquetas foram testadas com ambas as versões do firmware. As diferenças são o tempo de leitura original menos o revisto. Uma diferença positiva significa que a revisão foi mais rápida nessa etiqueta. Os rótulos de saída Before e After significam firmware original e revisto; não descrevem a ordem cronológica das leituras.
Leia a diferença média e o intervalo
A redução média é 19.35 ms. O respetivo intervalo de 95% é 15.05–23.64 ms, inteiramente acima de zero, com p = 2.813 × 10⁻⁹. A incerteza resulta das 24 diferenças dentro de cada etiqueta, não das dispersões das duas amostras separadas.

Intervalo de confiança da diferença Ver gráfico no tamanho original (abre num novo separador) Compare as formas das amostras
As caixas mostram a metade central de cada amostra, com a mediana no interior. Os bigodes e as sinalizações pelas barreiras descrevem as observações, não limites de aceitação. Num teste emparelhado, estas caixas separadas não mostram a dispersão das diferenças dentro de cada etiqueta.

Diagramas de extremos e quartis das amostras Ver gráfico no tamanho original (abre num novo separador) Leia o histograma
As alturas das barras contabilizam medições em intervalos de valores. Compare a forma e a dispersão, sem interpretar as barras como limites de confiança. Para os pressupostos do teste emparelhado, verifique também as diferenças dentro de cada etiqueta.

Histograma das amostras Ver gráfico no tamanho original (abre num novo separador) Decida o que o resultado permite concluir
Compare a melhoria média estimada de 15–24 ms com a poupança necessária no fluxo de leitura. Confirme-a em etiquetas e condições representativas.
Mais detalhes: leia cada secção de resultados
As tabelas completas de resultados usam seis algarismos significativos, como na Ajuda.
Teste t emparelhado
A diferença de médias é a amostra 1 menos a amostra 2; o erro-padrão mede a sua incerteza. A estatística t é a diferença dividida pelo erro-padrão. Os graus de liberdade, alfa, a alternativa, o método e o nível de confiança documentam a inferência. Os limites inferior e superior do IC delimitam a diferença de médias populacionais. A incerteza emparelhada utiliza as diferenças dentro de cada etiqueta; os graus de liberdade são 23.
| Estatística | Valor |
|---|---|
| Estatística t | 9.3244 |
| Graus de liberdade | 23 |
| Valor p | 2.81325e-9 |
| Diferença de médias | 19.3458 |
| Erro-padrão | 2.07475 |
| Alfa | 0.05 |
| Alternativa | two-sided |
| Método | Teste t para amostras emparelhadas |
| Nível de confiança (%) | 95 |
| Limite inferior do IC | 15.0539 |
| Limite superior do IC | 23.6378 |
- Rejeitar H₀ (μ𝑑 = 0) com α=0.05 (p=2.81e-09)
- H₀: μ𝑑 = 0
- H₁: μ𝑑 ≠ 0
Resumos das amostras
n contabiliza as leituras; a média, a mediana, o mínimo, o máximo e a amplitude descrevem cada amostra. O desvio-padrão é a dispersão amostral, o erro-padrão é a incerteza da respetiva média e a amplitude interquartil é a dispersão da metade central. Existem 24 pares completos. Os valores do erro-padrão das amostras separadas não são o erro-padrão da diferença emparelhada.
| Amostra | n | Média | Desvio-padrão | Erro-padrão | Mediana | Mínimo | Máximo | Amplitude | IQR |
|---|---|---|---|---|---|---|---|---|---|
| Before | 24 | 281.213 | 36.2839 | 7.40641 | 274.45 | 216.9 | 349.5 | 132.6 | 50.775 |
| After | 24 | 261.867 | 39.2201 | 8.00576 | 258.7 | 176.1 | 330.3 | 154.2 | 63.75 |
Coordenadas do diagrama de extremos e quartis
Q1 e Q3 delimitam a metade central, com a mediana entre ambos. IQR é Q3 menos Q1. As barreiras inferior e superior utilizam 1.5 × IQR; os bigodes terminam nas observações extremas dentro das barreiras. Estas coordenadas não são limites de aceitação.
| Amostra | Q1 | Mediana | Q3 | IQR | Barreira inferior | Barreira superior | Extremo inferior do bigode | Extremo superior do bigode |
|---|---|---|---|---|---|---|---|---|
| Before | 256.475 | 274.45 | 307.25 | 50.775 | 180.313 | 383.412 | 216.9 | 349.5 |
| After | 230.55 | 258.7 | 294.3 | 63.75 | 134.925 | 389.925 | 176.1 | 330.3 |
Sinalizações do diagrama de extremos e quartis
Cada linha identificaria uma amostra, uma linha da folha de cálculo e um valor para além de uma barreira. Esta tabela vazia significa que nenhuma amostra tem sinalizações pelas barreiras. Uma sinalização exigiria investigação, não eliminação automática.
| Amostra | Linha da folha de cálculo | Valor |
|---|
Não foram devolvidas linhas para esta secção.
7. Criar um relatório
Conserve Paired t-test e Sample summaries completos, as coordenadas e sinalizações dos diagramas de extremos e quartis, o intervalo da diferença, os diagramas de extremos e quartis e o histograma. Indique a amostra 1 menos a amostra 2 e a correspondência por etiqueta.
Selecione Add to report da execução concluída. Abra Choose individual items and advanced options para selecionar tabelas e gráficos e, em seguida, selecione Add to draft. Os elementos ocultos permanecem na análise guardada.
Dê um nome ao relatório e acrescente o objetivo do estudo e a sua interpretação. Selecione Save, reveja Preview e, em seguida, use Export → Download HTML. O exemplo abaixo contém todo o conteúdo selecionado, incluindo resultados que não cabem num único ecrã.