

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: czas skanowania oprogramowania układowego
24 etykiety, każda oceniona raz każdą wersją oprogramowania układowego: 24 sparowane wiersze i 48 odczytów czasu skanowania. Kolejność odczytów wersji oprogramowania zrównoważono i losowano między etykietami.
Pobierz przykładowe dane (CSV, angielskie nagłówki)To ten sam przykład, który znajduje się w Help. Zaimportuj CSV, aby wykonać kolejne kroki, lub użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Means: Two-Sample (t). Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Zaimportuj przykładowe dane
Pobierz powyższy plik CSV i zaimportuj go do arkusza. Wybierz Comma jako separator pól, Dot jako separator dziesiętny oraz First row contains column names.
3. Przypisz kolumny wejściowe
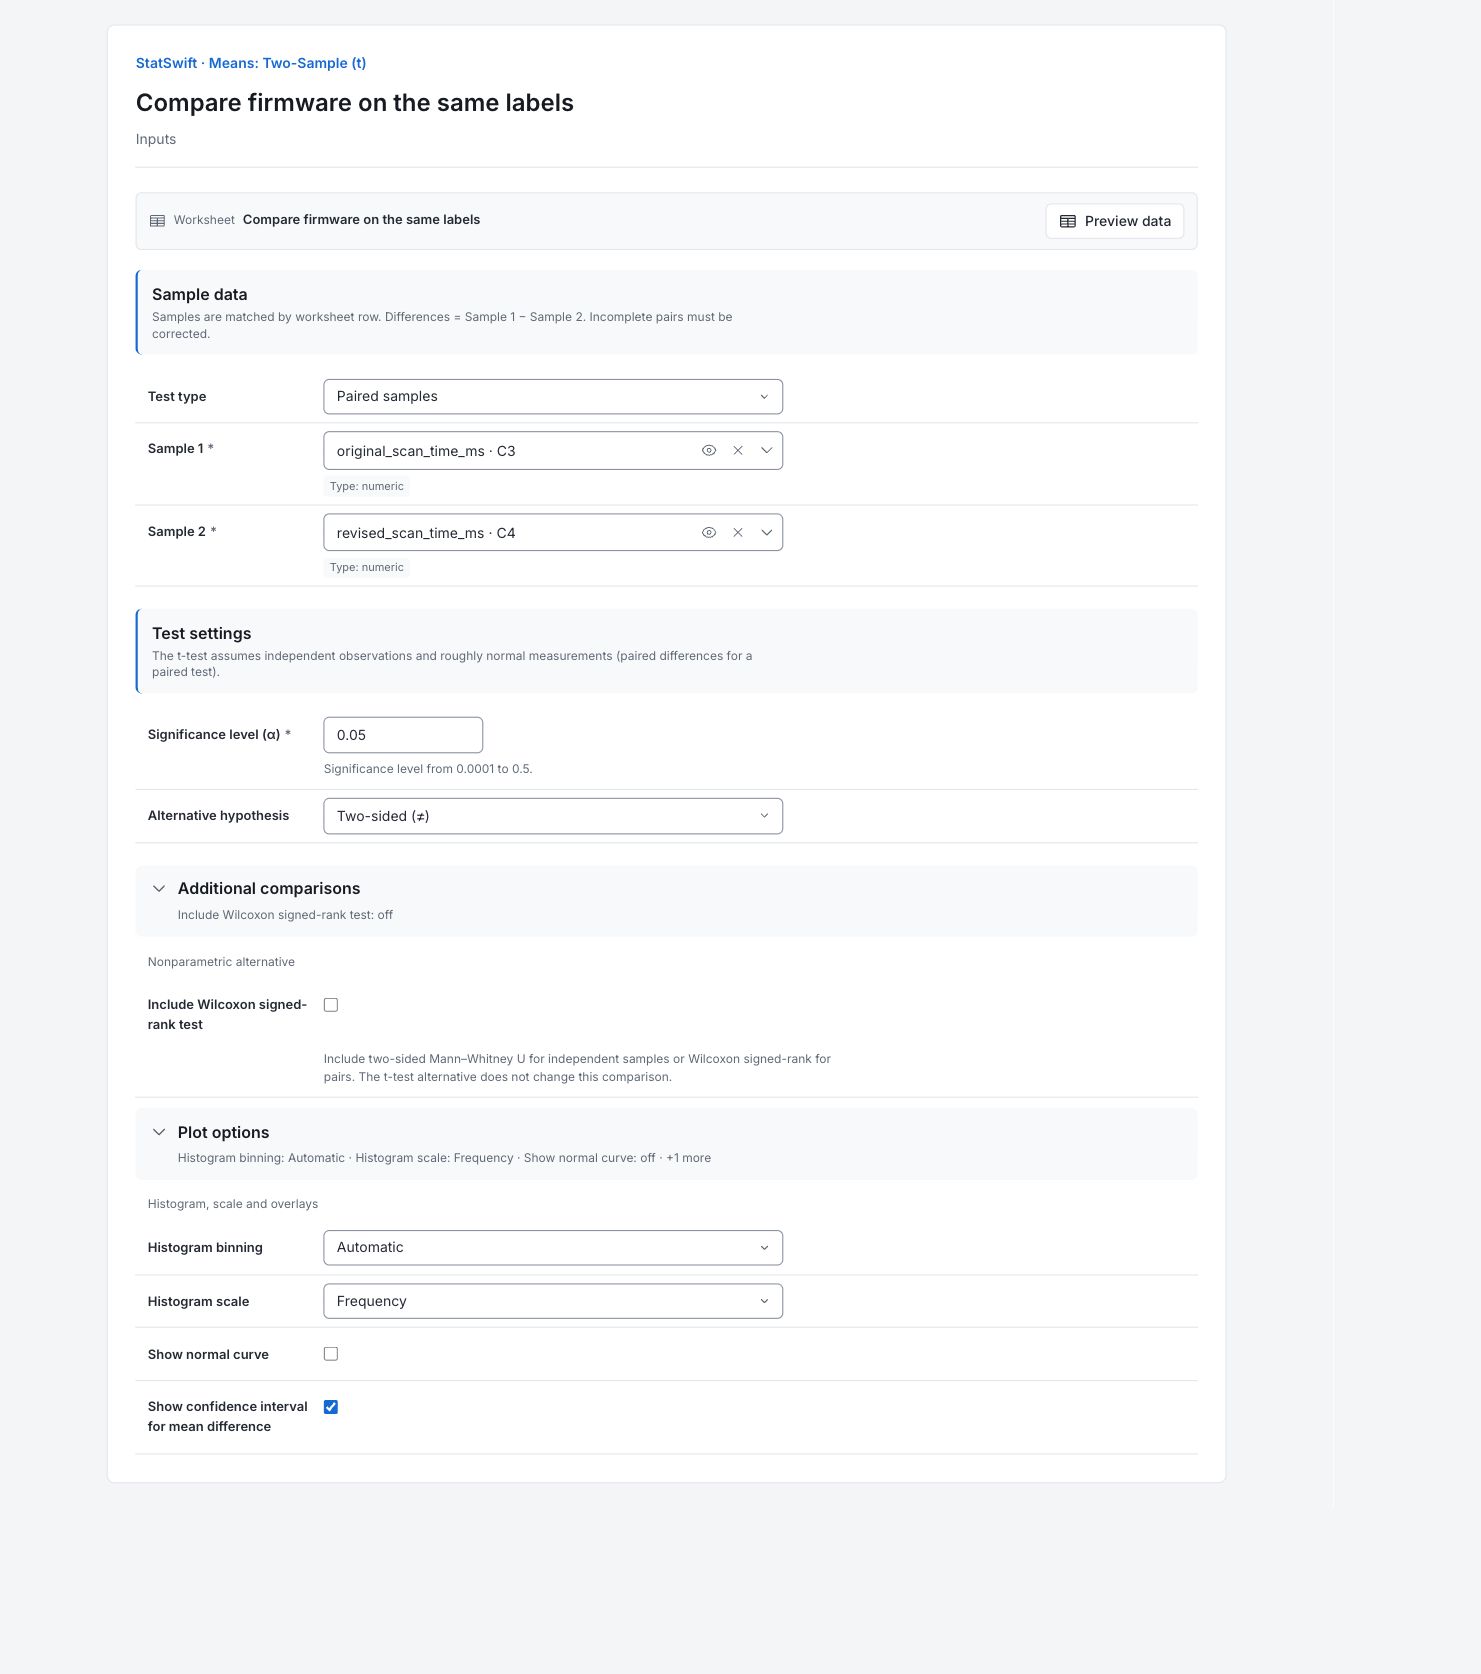
Na karcie Inputs wybierz Paired samples w Test type. Przypisz original_scan_time_ms do Sample 1 i revised_scan_time_ms do Sample 2. Każdy wiersz arkusza musi zawierać oba odczyty dla tej samej etykiety. Zachowaj parę razem podczas sortowania.
4. Ustaw test i wykresy
Wpisz 0.05 w Significance level (α) i wybierz Two-sided (≠) w Alternative hypothesis. Otwórz Additional comparisons i pozostaw Include Wilcoxon signed-rank test niezaznaczone.
Otwórz Plot options. Ustaw Histogram binning na Automatic i Histogram scale na Frequency. Pozostaw Show normal curve niezaznaczone i zaznacz Show confidence interval for mean difference.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Zachowaj jasne porównanie sparowane
Te same 24 etykiety przetestowano obiema wersjami oprogramowania układowego. Różnice to pierwotny minus zmodyfikowany czas skanowania. Dodatnia różnica oznacza szybsze skanowanie po zmianie dla danej etykiety. Etykiety wyników Before i After oznaczają pierwotne i zmodyfikowane oprogramowanie; nie opisują chronologicznej kolejności odczytów.
Odczytaj średnią różnicę i przedział
Średnie skrócenie wynosi 19.35 ms. Jego przedział 95% wynosi 15.05–23.64 ms, całkowicie powyżej zera, przy p = 2.813 × 10⁻⁹. Niepewność wynika z 24 różnic wewnątrz etykiet, a nie z rozrzutu dwóch oddzielnych prób.

Przedział ufności różnicy Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Porównaj kształty prób
Pudełka pokazują środkową połowę każdej próby, z medianą wewnątrz. Wąsy i oznaczenia przekroczenia granic opisują obserwacje, a nie granice akceptacji. Dla testu sparowanego te oddzielne pudełka nie pokazują rozrzutu różnic wewnątrz etykiet.

Wykresy pudełkowe prób Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Odczytaj histogram
Wysokości słupków zliczają pomiary w przedziałach wartości. Porównaj kształt i rozrzut, nie traktując słupków jako granic ufności. Dla założeń testu sparowanego sprawdź również różnice wewnątrz etykiet.

Histogram prób Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Zdecyduj, co uzasadnia wynik
Porównaj oszacowaną średnią poprawę 15–24 ms z oszczędnością potrzebną w procesie skanowania. Potwierdź ją na reprezentatywnych etykietach i w reprezentatywnych warunkach.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Test t dla prób sparowanych
Różnica średnich to próba 1 minus próba 2; błąd standardowy mierzy jej niepewność. Statystyka t to różnica podzielona przez błąd standardowy. Stopnie swobody, alfa, alternatywa, metoda i poziom ufności dokumentują wnioskowanie. Dolna i górna granica CI ograniczają różnicę średnich populacji. Niepewność sparowana wykorzystuje różnice wewnątrz etykiet; stopnie swobody wynoszą 23.
| Statystyka | Wartość |
|---|---|
| Statystyka t | 9.3244 |
| Stopnie swobody | 23 |
| wartość p | 2.81325e-9 |
| Różnica średnich | 19.3458 |
| Błąd standardowy | 2.07475 |
| Alfa | 0.05 |
| Hipoteza alternatywna | two-sided |
| Metoda | Test t dla prób sparowanych |
| Poziom ufności (%) | 95 |
| Dolna granica PU | 15.0539 |
| Górna granica PU | 23.6378 |
- Odrzuć H₀ (μ𝑑 = 0) przy α=0.05 (p=2.81e-09)
- H₀: μ𝑑 = 0
- H₁: μ𝑑 ≠ 0
Podsumowania prób
n zlicza odczyty; średnia, mediana, minimum, maksimum i rozstęp opisują każdą próbę. SD to rozrzut próby, SE to niepewność jej średniej, a IQR to rozrzut środkowej połowy. Istnieją 24 kompletne pary. Oddzielne wartości SE prób nie są SE różnicy sparowanej.
| Próba | n | Średnia | SD | SE | Mediana | Minimum | Maksimum | Rozstęp | IQR |
|---|---|---|---|---|---|---|---|---|---|
| Before | 24 | 281.213 | 36.2839 | 7.40641 | 274.45 | 216.9 | 349.5 | 132.6 | 50.775 |
| After | 24 | 261.867 | 39.2201 | 8.00576 | 258.7 | 176.1 | 330.3 | 154.2 | 63.75 |
Współrzędne wykresu pudełkowego
Q1 i Q3 ograniczają środkową połowę, z medianą między nimi. IQR to Q3 minus Q1. Dolna i górna granica wykorzystują 1.5 × IQR; wąsy kończą się na skrajnych obserwacjach wewnątrz granic. Te współrzędne nie są granicami akceptacji.
| Próba | Q1 | Mediana | Q3 | IQR | Dolna granica | Górna granica | Dolny wąs | Górny wąs |
|---|---|---|---|---|---|---|---|---|
| Before | 256.475 | 274.45 | 307.25 | 50.775 | 180.313 | 383.412 | 216.9 | 349.5 |
| After | 230.55 | 258.7 | 294.3 | 63.75 | 134.925 | 389.925 | 176.1 | 330.3 |
Oznaczenia wykresu pudełkowego
Każdy wiersz wskazywałby próbę, wiersz arkusza i wartość poza granicą. Pusta tabela oznacza brak oznaczeń przekroczenia granic w obu próbach. Oznaczenie wymagałoby zbadania, a nie automatycznego usunięcia.
| Próba | Wiersz arkusza | Wartość |
|---|
Dla tej sekcji nie zwrócono żadnych wierszy.
7. Utwórz raport
Zachowaj pełny Paired t-test, Sample summaries, współrzędne i oznaczenia wykresów pudełkowych, przedział różnicy, wykresy pudełkowe i histogram. Podaj kierunek próba 1 minus próba 2 oraz dopasowanie według etykiety. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.