

I comandi dell’app, gli identificatori dei fogli dati e i valori dei dati di esempio conservano la forma originale. Screenshot, grafici e file da scaricare sono in inglese. Gli esempi mantengono il punto decimale e la virgola come separatore delle migliaia della notazione inglese originale; i prezzi e i conteggi del sito seguono invece la formattazione italiana.
Esempio: tempo di scansione del firmware
24 etichette, ciascuna valutata una volta con ogni versione del firmware: 24 righe appaiate e 48 letture del tempo di scansione. L’ordine delle letture dei firmware è stato bilanciato e randomizzato tra le etichette.
Scarica i dati di esempio (CSV)È lo stesso esempio usato in Help. Importa il CSV per seguire i passaggi oppure usa Open example in a practice copy in Help per precompilare i dati in ingresso.
1. Crea l’ambiente di lavoro
Nella barra laterale, apri Basic Statistics e scegli Means: Two-Sample (t). Crea un’analisi, assegnale un nome, seleziona New blank worksheet, poi scegli Create analysis.
2. Importa i dati di esempio
Scarica il CSV qui sopra e importalo nel foglio dati. Scegli Comma come delimitatore, Dot come separatore decimale e First row contains column names.
3. Assegna le colonne in ingresso
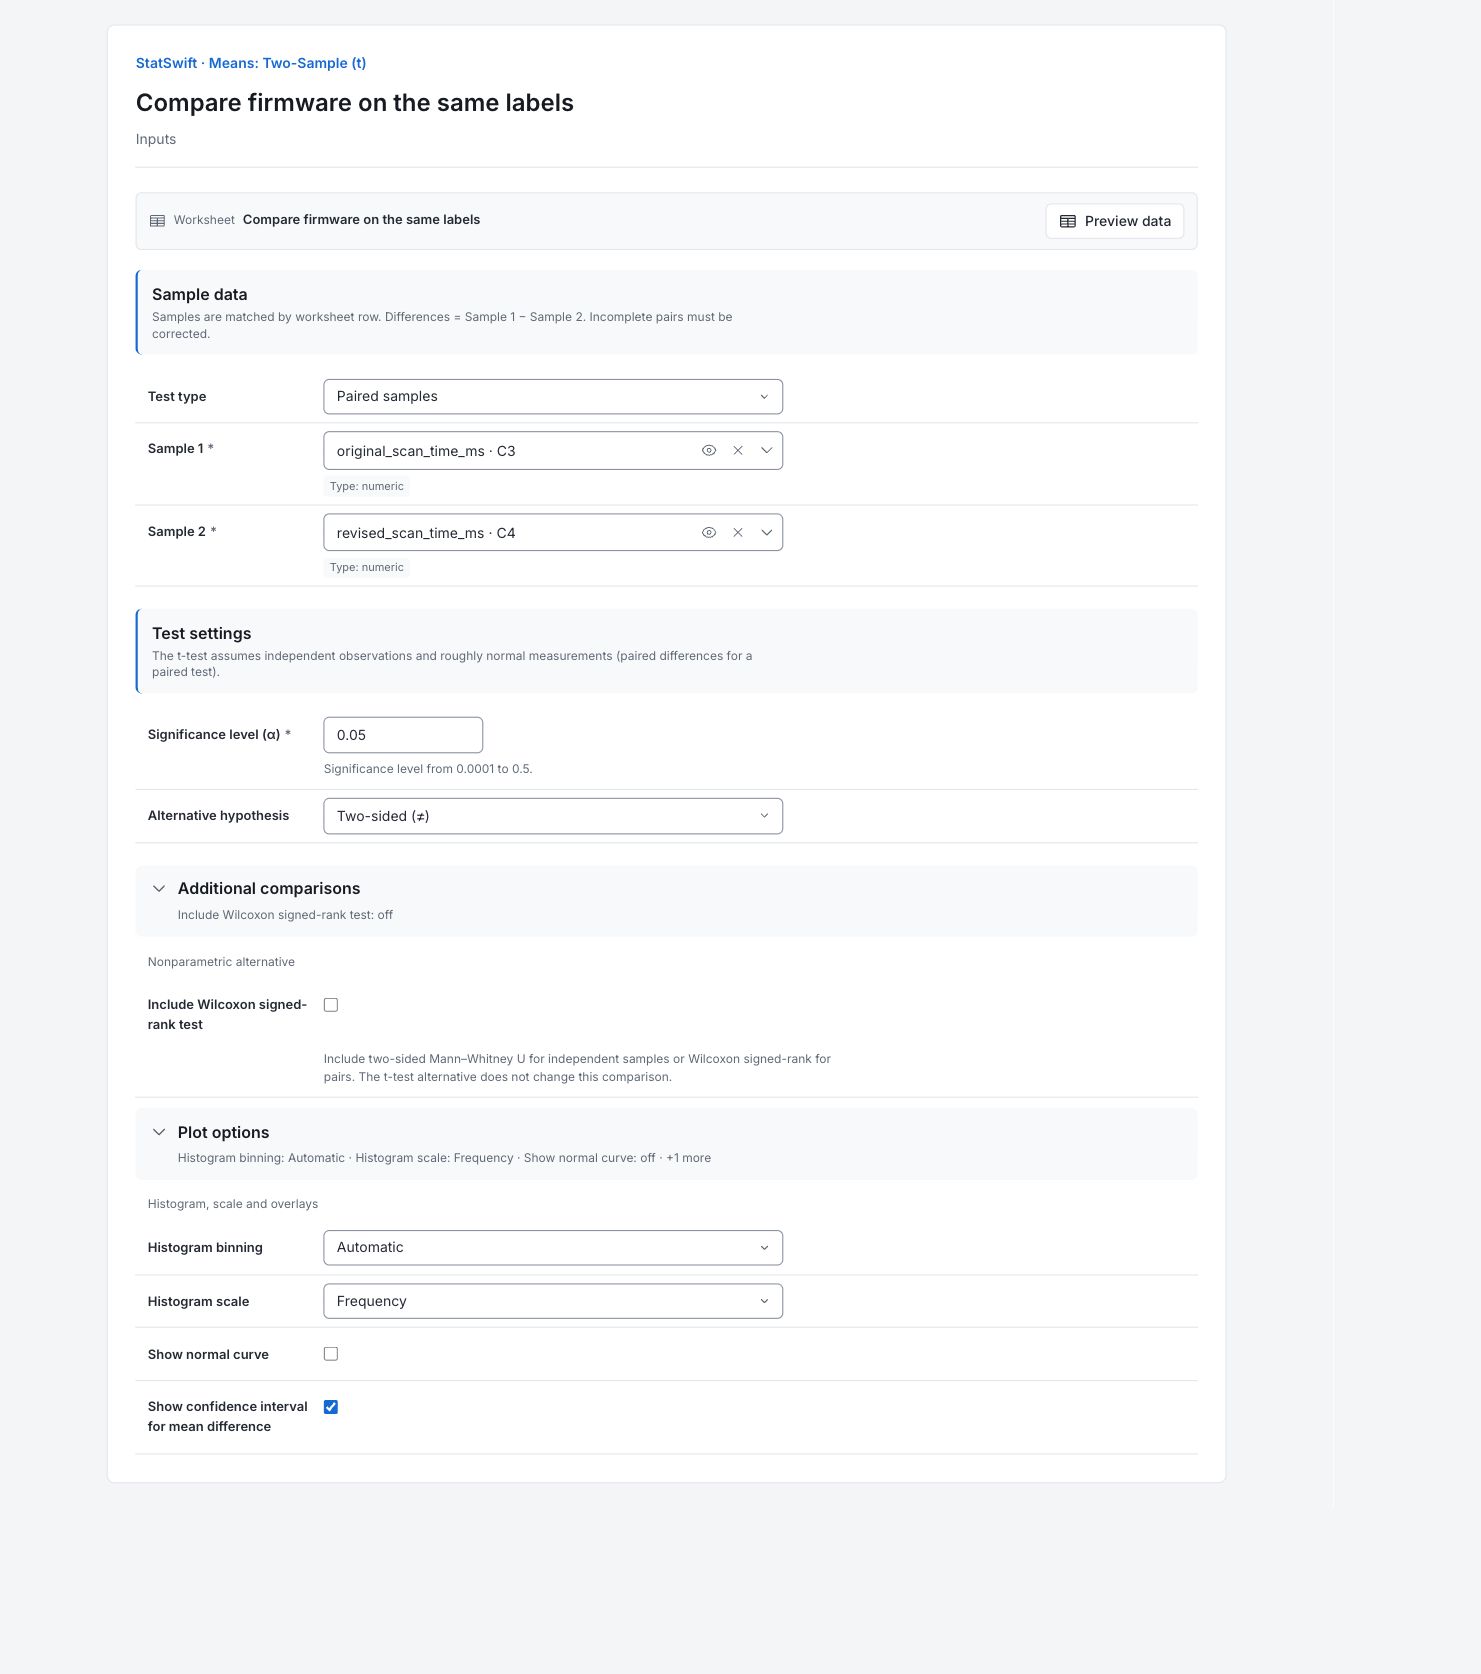
In Inputs, scegli Paired samples per Test type. Assegna original_scan_time_ms a Sample 1 e revised_scan_time_ms a Sample 2. Ogni riga del foglio dati deve contenere entrambe le letture della stessa etichetta. Mantieni unita la coppia quando ordini i dati.
4. Imposta il test e i grafici
Inserisci 0.05 in Significance level (α) e scegli Two-sided (≠) per Alternative hypothesis. Apri Additional comparisons e lascia deselezionato Include Wilcoxon signed-rank test.
Apri Plot options. Imposta Histogram binning su Automatic e Histogram scale su Frequency. Lascia deselezionato Show normal curve e seleziona Show confidence interval for mean difference.
5. Esegui l’analisi
Scegli Run analysis, poi apri Results.
6. Interpreta i risultati
Chiarisci il confronto appaiato
Le stesse 24 etichette sono state provate con entrambe le versioni del firmware. Le differenze sono tempo di scansione originale meno modificato. Una differenza positiva indica che la versione modificata era più veloce su quell’etichetta. Le etichette dei risultati Before e After indicano il firmware originale e quello modificato; non descrivono l’ordine cronologico delle letture.
Leggi la differenza media e l’intervallo
La riduzione media è di 19.35 ms. Il suo intervallo al 95% è 15.05–23.64 ms, interamente sopra lo zero, con p = 2.813 × 10⁻⁹. L’incertezza deriva dalle 24 differenze entro la stessa etichetta, non dalle dispersioni dei due campioni separati.

Intervallo di confidenza della differenza Visualizza il grafico a grandezza originale (si apre in una nuova scheda) Confronta le forme dei campioni
I box mostrano la metà centrale di ogni campione, con la mediana all’interno. I baffi e le segnalazioni oltre le soglie descrivono le osservazioni, non limiti di accettazione. In un test appaiato, questi box separati non mostrano la dispersione delle differenze entro la stessa etichetta.

Box plot dei campioni Visualizza il grafico a grandezza originale (si apre in una nuova scheda) Leggi l’istogramma
Le altezze delle barre contano le misurazioni in intervalli di valori. Confronta forma e dispersione senza considerare le barre come limiti di confidenza. Per le ipotesi del test appaiato, verifica anche le differenze entro la stessa etichetta.

Istogramma dei campioni Visualizza il grafico a grandezza originale (si apre in una nuova scheda) Decidi cosa sostiene il risultato
Confronta il miglioramento medio stimato di 15–24 ms con il risparmio necessario nel flusso di scansione. Confermalo su etichette e condizioni rappresentative.
Altri dettagli: leggi ogni sezione dei risultati
Le tabelle complete dei risultati usano sei cifre significative, come in Help.
Test t appaiato
Differenza tra le medie è Campione 1 meno Campione 2; Errore standard ne misura l’incertezza. La statistica t è la differenza divisa per Errore standard. Gradi di libertà, Alfa, Alternativa, Metodo e Livello di confidenza documentano l’inferenza. Limite inferiore dell’intervallo di confidenza e Limite superiore dell’intervallo di confidenza delimitano la differenza tra le medie delle popolazioni. L’incertezza appaiata usa le differenze entro la stessa etichetta; i gradi di libertà sono 23.
| Statistica | Valore |
|---|---|
| Statistica t | 9.3244 |
| Gradi di libertà | 23 |
| p-value | 2.81325e-9 |
| Differenza tra le medie | 19.3458 |
| Errore standard | 2.07475 |
| α | 0.05 |
| Alternativa | two-sided |
| Metodo | Test t appaiato |
| Livello di confidenza (%) | 95 |
| Limite inferiore dell’intervallo di confidenza | 15.0539 |
| Limite superiore dell’intervallo di confidenza | 23.6378 |
- Rifiuta H₀ (μ𝑑 = 0) a α=0.05 (p=2.81e-09)
- H₀: μ𝑑 = 0
- H₁: μ𝑑 ≠ 0
Riepiloghi dei campioni
n conta le letture; Media, Mediana, Min, Max e Ampiezza descrivono ogni campione. SD è la dispersione campionaria, SE è l’incertezza della media e IQR è la dispersione della metà centrale. Vi sono 24 coppie complete. I valori di SE dei campioni separati non sono il SE della differenza appaiata.
| Campione | n | Media | SD | SE | Mediana | Min | Max | Ampiezza | IQR |
|---|---|---|---|---|---|---|---|---|---|
| Before | 24 | 281.213 | 36.2839 | 7.40641 | 274.45 | 216.9 | 349.5 | 132.6 | 50.775 |
| After | 24 | 261.867 | 39.2201 | 8.00576 | 258.7 | 176.1 | 330.3 | 154.2 | 63.75 |
Coordinate dei box plot
Q1 e Q3 delimitano la metà centrale, con la Mediana tra loro. IQR è Q3 meno Q1. Le Soglie inferiore e superiore usano 1.5 × IQR; i baffi terminano alle osservazioni estreme all’interno delle soglie. Queste coordinate non sono limiti di accettazione.
| Campione | Q1 | Mediana | Q3 | IQR | Soglia inferiore | Soglia superiore | Baffo inferiore | Baffo superiore |
|---|---|---|---|---|---|---|---|---|
| Before | 256.475 | 274.45 | 307.25 | 50.775 | 180.313 | 383.412 | 216.9 | 349.5 |
| After | 230.55 | 258.7 | 294.3 | 63.75 | 134.925 | 389.925 | 176.1 | 330.3 |
Segnalazioni dei box plot
Ogni riga identificherebbe un Campione, una Riga del foglio dati e un Valore oltre una soglia. Questa tabella vuota indica che nessuno dei due campioni ha segnalazioni oltre le soglie. Una segnalazione richiederebbe un’indagine, non l’eliminazione automatica.
| Campione | Riga del foglio dati | Valore |
|---|
Non sono state restituite righe per questa sezione.
7. Crea un report
Conserva Paired t-test, Sample summaries, le coordinate e le segnalazioni dei box plot, l’intervallo della differenza, i box plot e l’istogramma completi. Specifica Campione 1 meno Campione 2 e l’abbinamento per etichetta.
Seleziona Add to report dall’esecuzione completata. Apri Choose individual items and advanced options per selezionare tabelle e grafici, quindi scegli Add to draft. Gli elementi nascosti restano nell’analisi salvata.
Assegna un nome al report e aggiungi lo scopo dello studio e la tua interpretazione. Seleziona Save, controlla Preview, quindi usa Export → Download HTML. L’esempio seguente contiene tutti i contenuti selezionati, compresi i risultati che occupano più di una schermata.