

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : durées d’achèvement d’essais sur banc
120 essais terminés ; une durée positive par essai.
Télécharger les données d’exemple (CSV en anglais)C’est le même exemple que dans Help. Importez le CSV pour suivre les étapes ou utilisez Open example in a practice copy dans Help pour préremplir les données d’entrée.
1. Créer l’espace de travail
Dans la barre latérale, ouvrez Basic Statistics et choisissez Distribution Fit Analysis. Créez une analyse, nommez-la, sélectionnez New blank worksheet, puis choisissez Create analysis.
2. Importer les données d’exemple
Téléchargez le CSV ci-dessus et importez-le dans la feuille de données. Choisissez Comma comme délimiteur, Dot comme séparateur décimal et First row contains column names.
3. Affecter les mesures
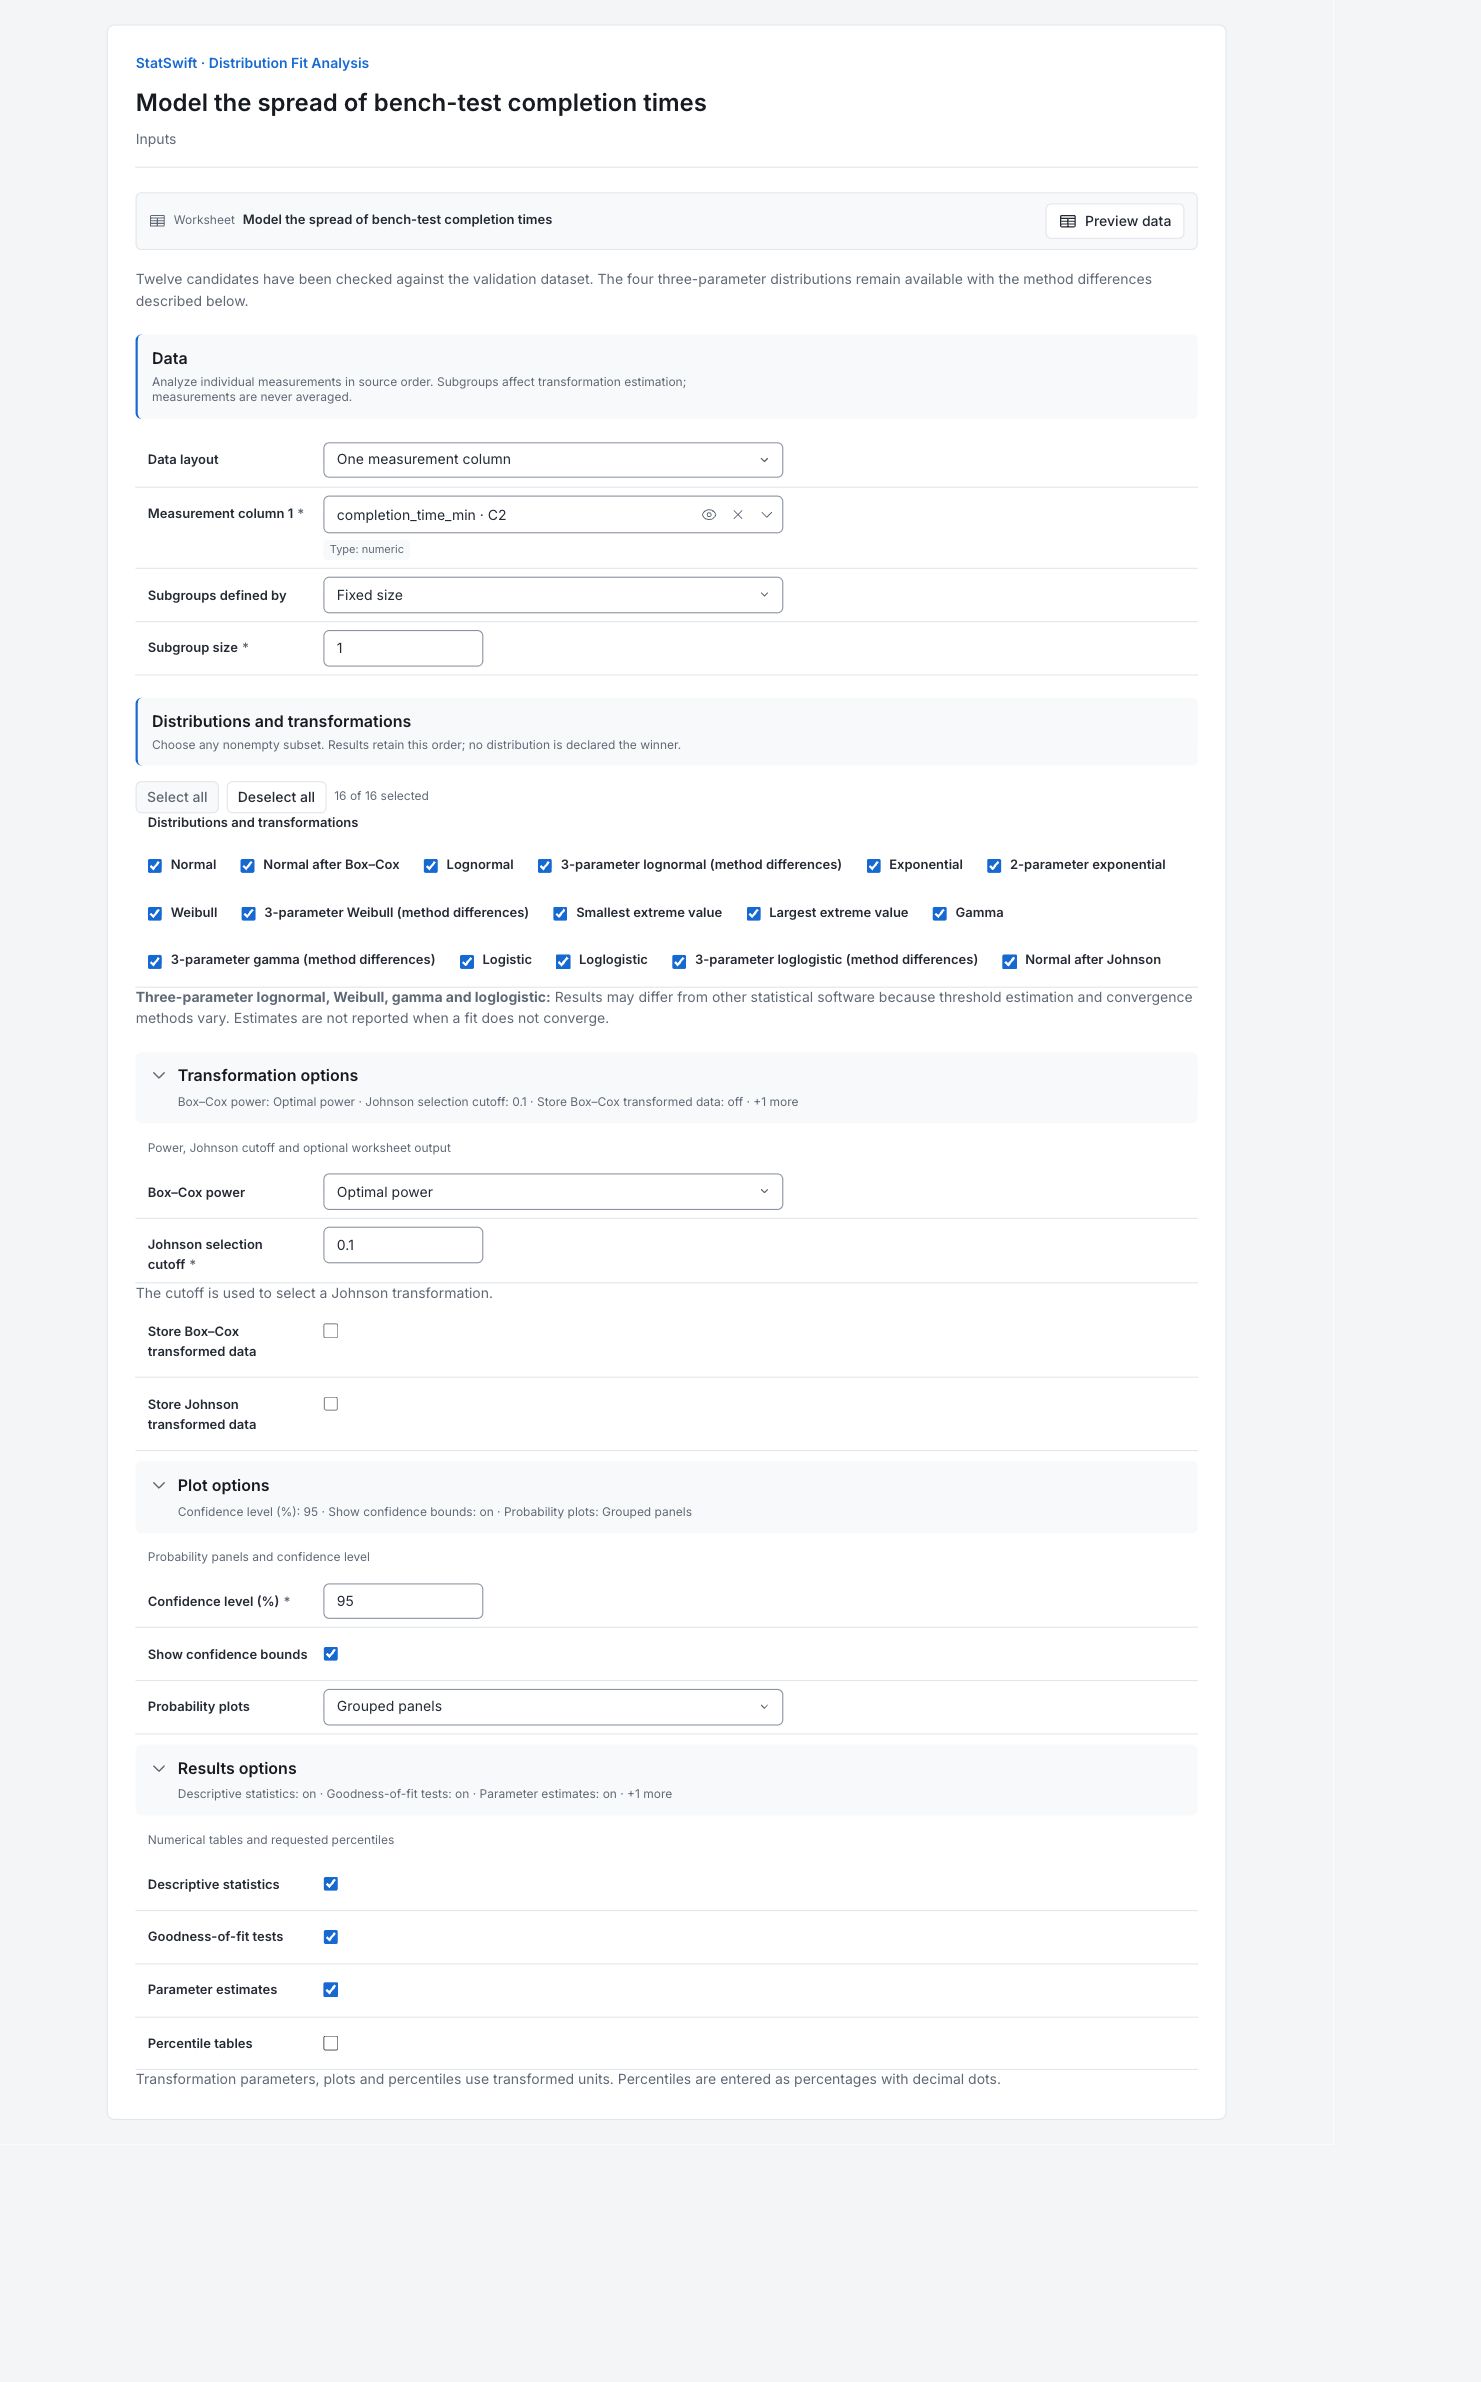
Dans Inputs, choisissez One measurement column pour Data layout. Affectez completion_time_min à Measurement column 1. Choisissez Fixed size pour Subgroups defined by et saisissez 1 dans Subgroup size.
4. Choisir les modèles candidats et les transformations
Sous Distributions and transformations, choisissez Select all pour sélectionner les 16 of 16 modèles candidats. Conservez leur ordre.
Ouvrez Transformation options. Choisissez Optimal power pour Box–Cox power et saisissez 0.1 dans Johnson selection cutoff. Laissez Store Box–Cox transformed data et Store Johnson transformed data décochés.
5. Définir les graphiques et les tableaux de résultats
Ouvrez Plot options. Saisissez 95 dans Confidence level (%), cochez Show confidence bounds et choisissez Grouped panels pour Probability plots. Ouvrez Results options, cochez Descriptive statistics, Goodness-of-fit tests et Parameter estimates, et laissez Percentile tables décoché.
6. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
7. Interpréter les résultats
Identifier la comparaison
Les 120 durées d’achèvement positives sont incluses, une par essai terminé. La moyenne est de 19.597 minutes. Seize lois et transformations sont comparées dans l’ordre sélectionné ; l’outil ne choisit pas une unique famille vraie.
Comparer les quatre premiers graphiques
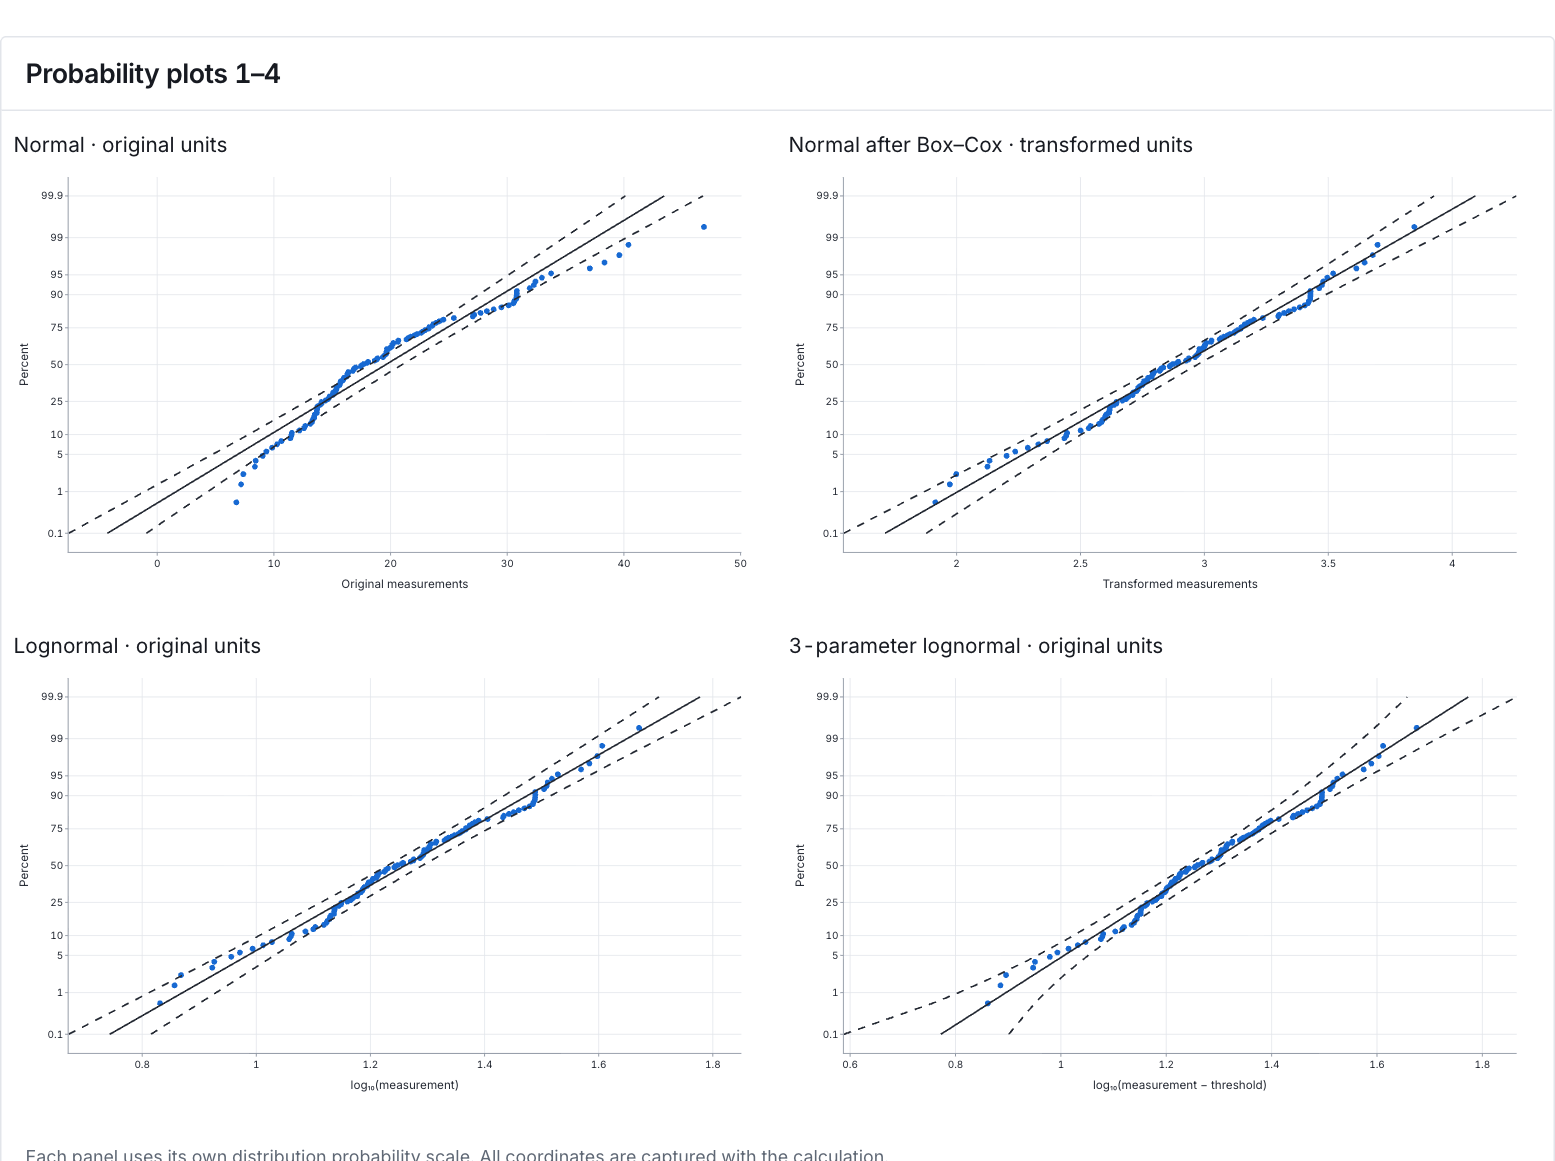
Les panneaux montrent les lois normale, normale après Box–Cox, lognormale et lognormale à 3 paramètres. Chaque point est une durée ordonnée sur l’échelle indiquée du panneau. Recherchez une structure approximativement rectiligne et examinez les queues et les bornes de confiance. Les 12 autres panneaux se trouvent dans Plus de détails.
Graphiques de probabilité 1–4 Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Lire les éléments sur l’ajustement
L’ajustement normal donne AD = 2.7369 et p < 0.005, indiquant un mauvais ajustement normal. La lognormale donne p = 0.1514 ; la log-logistique et la loi de la plus grande valeur extrême ne sont pas non plus rejetées à 0.05. Plusieurs modèles restent plausibles. Une valeur p plus élevée ne choisit pas à elle seule le meilleur modèle.
Distinguer les résultats indisponibles et les échelles
Les lignes lognormale, gamma et log-logistique à 3 paramètres ont des valeurs p AD indisponibles ; indisponible ne signifie pas que le test est satisfait. La ligne Weibull à 3 paramètres indique au contraire p≈0.0183, avec qualification de la méthode aux limites toujours en attente. Les ajustements de Box–Cox et de Johnson utilisent des unités transformées, et non des minutes.
Choisir un modèle pour la décision visée
Comparez le comportement des modèles plausibles aux durées importantes, en particulier dans la queue des durées longues. Conservez les notes méthodologiques et vérifiez la performance prédictive avant d’utiliser des percentiles ajustés pour décider sur le temps de service.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Tests d’adéquation
Le modèle candidat identifie une loi ou un ajustement normal après transformation. AD mesure l’écart sur son échelle de probabilité ; la valeur p AD peut être un nombre, une borne de restitution ou Indisponible. Lisez la note de la cellule. La statistique du rapport de vraisemblance et la valeur p LRT comparent les familles emboîtées admissibles ; ce n’est pas le test AD d’adéquation. Sans objet et Indisponible ne sont pas des résultats satisfaisant un test. La valeur p AD de Weibull à 3 paramètres est numérique, environ 0.0183, avec qualification aux limites en attente ; les valeurs lognormale, gamma et log-logistique à 3 paramètres sont indisponibles.
| Modèle candidat | AD | Valeur p AD | Statistique du rapport de vraisemblance | Valeur p LRT |
|---|---|---|---|---|
| Normal | 2.73688 | < 0.005Approximation AD normale de Stephens ; borne inférieure de restitution 0.005 | — | Sans objet |
| Normal after Box–Cox | 0.552479 | 0.151353Approximation AD normale de Stephens ; borne inférieure de restitution 0.005 | — | Sans objet |
| Lognormal | 0.552479 | 0.151353Approximation AD normale de Stephens ; borne inférieure de restitution 0.005 | — | Sans objet |
| 3-parameter lognormal | 0.564131 | IndisponibleUne probabilité AD n’est pas disponible pour cette famille à trois paramètres. | 0.0222193 | 0.881505Khi-deux, 1 ddl ; maximums de vraisemblance ajustés |
| Exponential | 22.216 | < 0.003Formules de significativité exponentielle de Stephens, table 4.12, correction 1+0.6/n ; contrôles de l’implémentation de part et d’autre de 0.26, 0.51, 0.95 et 2.534 | — | Sans objet |
| 2-parameter exponential | 9.52934 | < 0.01Stephens, table 4.14, correction 1+5.4/n-11/n² ; interpolation linéaire dans la table | 99.8966 | 1.60565e-23Khi-deux, 1 ddl ; vraisemblance ajustée de l’exponentielle décalée |
| Weibull | 2.14725 | < 0.01Correction de valeurs extrêmes de Stephens 1+0.2/sqrt(n) ; interpolation linéaire dans la table | — | Sans objet |
| 3-parameter Weibull | 0.952225 | 0.0183026Lockhart–Stephens, table 1, cas 7 ; interpolation sur l’inverse du paramètre de forme et sur la probabilité ; qualification des cas limites de l’implémentation en attente | 14.422 | 0.000146086Khi-deux, 1 ddl ; maximums de vraisemblance ajustés |
| Smallest extreme value | 6.55729 | < 0.01Correction de valeurs extrêmes de Stephens 1+0.2/sqrt(n) ; interpolation linéaire dans la table | — | Sans objet |
| Largest extreme value | 0.581117 | 0.141662Correction de valeurs extrêmes de Stephens 1+0.2/sqrt(n) ; interpolation linéaire dans la table | — | Sans objet |
| Gamma | 0.917041 | 0.0215001Stephens, table 4.21 ; première ligne sous une forme de 1, interpolation linéaire sur la forme et la probabilité, ligne asymptotique au-dessus d’une forme de 20 ; qualification plus large des cas limites en attente | — | Sans objet |
| 3-parameter gamma | 0.664386 | IndisponibleUne probabilité AD n’est pas disponible pour cette famille à trois paramètres. | 2.03791 | 0.15342Khi-deux, 1 ddl ; vraisemblance gamma modifiée rapportée |
| Logistic | 2.04259 | < 0.005Correction logistique de Stephens 1+0.25/n ; interpolation linéaire dans la table | — | Sans objet |
| Loglogistic | 0.524443 | 0.141019Correction logistique de Stephens 1+0.25/n ; interpolation linéaire dans la table | — | Sans objet |
| 3-parameter loglogistic | 0.471833 | IndisponibleUne probabilité AD n’est pas disponible pour cette famille à trois paramètres. | 0.268154 | 0.604573Khi-deux, 1 ddl ; maximums de vraisemblance ajustés |
| Normal after Johnson | 0.395435 | 0.366495Approximation AD normale de Stephens ; borne inférieure de restitution 0.005 | — | Sans objet |
- Les modèles candidats sont affichés dans l’ordre spécifié, sans désigner de loi gagnante.
- Les tests du rapport de vraisemblance comparent les familles décalées à leurs versions non décalées. L’exponentielle décalée utilise ses estimations ajustées ; les autres familles utilisent leurs maximums de vraisemblance ajustés.
Statistiques descriptives
Le nombre d’observations est de 120, les cellules manquantes sont 0 et les sous-groupes non vides 120. La moyenne, la médiane, le minimum et le maximum décrivent les durées en minutes ; l’écart-type décrit leur dispersion. Une taille de sous-groupe de 1 laisse les mesures individuelles.
Mesures d’origine regroupées sans calcul de moyennes de sous-groupes.
| Statistique | Valeur |
|---|---|
| Observations | 120 |
| Cellules manquantes | 0 |
| Sous-groupes non vides | 120 |
| Moyenne | 19.597 |
| Écart-type | 7.72253 |
| Minimum | 6.78 |
| Médiane | 17.605 |
| Maximum | 46.86 |
| Asymétrie | 0.99684 |
| Excès d’aplatissement | 0.907451 |
Résultats des modèles candidats
Le statut indique si chaque modèle candidat a été calculé ou est indisponible. L’échelle distingue les résultats d’origine et transformés. L’explication conserve les réserves sur la validation, la convergence et la méthode. Les 16 résultats sont inclus ; ne supprimez pas silencieusement un résultat indisponible.
| Modèle candidat | Statut | Échelle | Explication |
|---|---|---|---|
| Normal | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| Normal after Box–Cox | Calculé | transformé | Vérifié par rapport au jeu de données de validation |
| Lognormal | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| 3-parameter lognormal | Calculé | d’origine | Les résultats peuvent différer de ceux d’autres logiciels statistiques, car les méthodes d’estimation du seuil et de convergence varient. Les estimations ne sont pas rapportées si l’ajustement ne converge pas. |
| Exponential | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| 2-parameter exponential | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| Weibull | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| 3-parameter Weibull | Calculé | d’origine | Les résultats peuvent différer de ceux d’autres logiciels statistiques, car les méthodes d’estimation du seuil et de convergence varient. Les estimations ne sont pas rapportées si l’ajustement ne converge pas. |
| Smallest extreme value | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| Largest extreme value | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| Gamma | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| 3-parameter gamma | Calculé | d’origine | Les résultats peuvent différer de ceux d’autres logiciels statistiques, car les méthodes d’estimation du seuil et de convergence varient. Les estimations ne sont pas rapportées si l’ajustement ne converge pas. |
| Logistic | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| Loglogistic | Calculé | d’origine | Vérifié par rapport au jeu de données de validation |
| 3-parameter loglogistic | Calculé | d’origine | Les résultats peuvent différer de ceux d’autres logiciels statistiques, car les méthodes d’estimation du seuil et de convergence varient. Les estimations ne sont pas rapportées si l’ajustement ne converge pas. |
| Normal after Johnson | Calculé | transformé | Vérifié par rapport au jeu de données de validation |
Estimations des paramètres
Les paramètres suivent la convention mathématique de chaque modèle candidat. L’échelle et la convention expliquent comment les lire ; la position et l’échelle lognormales concernent ln(X − seuil), bien que le modèle décrive les durées d’origine. Les paramètres normaux après transformation utilisent des unités transformées. Conservez les réserves sur le seuil et la covariance avec les estimations.
| Modèle candidat | Paramètres | Échelle | Convention |
|---|---|---|---|
| Normal | location = 19.597; scale = 7.72253 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Normal after Box–Cox | location = 2.90216; scale = 0.385417 | transformé | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Lognormal | location = 2.90216; scale = 0.385417 | d’origine | La position et l’échelle se rapportent à ln(X − seuil). |
| 3-parameter lognormal | location = 2.93063; scale = 0.372998; threshold = -0.489666 | d’origine | La position et l’échelle se rapportent à ln(X − seuil). |
| Exponential | scale = 19.597 | d’origine | Initialisation par régression du graphique de probabilité passant par l’origine et estimations de Newton sur l’échelle logarithmique, avec une tolérance d’arrêt relative de 1e−4 et une tolérance absolue du pas de 1e−6 ; l’estimation exacte du maximum de vraisemblance par la moyenne de l’échantillon est conservée séparément. |
| 2-parameter exponential | scale = 12.9247; threshold = 6.67229 | d’origine | Initialisation par régression du graphique de probabilité, mises à jour de Newton alternées sur l’échelle logarithmique et seuil = minimum − échelle/n ; l’arrêt conjoint sur les paramètres et la vraisemblance a été vérifié par rapport au jeu de données de validation. L’estimation du maximum de vraisemblance à la frontière du support est conservée séparément. |
| Weibull | shape = 2.6814; scale = 22.0651 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| 3-parameter Weibull | shape = 1.79811; scale = 14.9711; threshold = 6.28336 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Smallest extreme value | location = 23.7574; scale = 9.20238 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Largest extreme value | location = 16.1294; scale = 5.91185 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Gamma | shape = 6.99122; scale = 2.80309 | d’origine | Initialisation de Greenwood–Durand, arrêt relatif de Newton à 1e−4 et mise à jour finale linéarisée de l’échelle ; les estimations exactes du maximum de vraisemblance sont conservées séparément. |
| 3-parameter gamma | shape = 3.99933; scale = 3.82201; threshold = 4.31151 | d’origine | Estimation gamma conditionnelle finie, puis seuil = minimum − quantile gamma à 1/(n+1) ; convergence conjointe des paramètres et de la vraisemblance. La forme et l’échelle sont conservées depuis l’étape précédente d’estimation du seuil. |
| Logistic | location = 18.7606; scale = 4.22543 | d’origine | L’échelle et la forme suivent les conventions mathématiques de référence. |
| Loglogistic | location = 2.89811; scale = 0.217969 | d’origine | La position et l’échelle se rapportent à ln(X − seuil). |
| 3-parameter loglogistic | location = 2.7846; scale = 0.244789; threshold = 1.88031 | d’origine | La position et l’échelle se rapportent à ln(X − seuil). |
| Normal after Johnson | location = 0.00290881; scale = 1.00489 | transformé | L’échelle et la forme suivent les conventions mathématiques de référence. |
Détails des transformations
La transformation, la famille, les paramètres et la formule directe documentent les transformations ajustées. Box–Cox utilise ici ln(X) ; Johnson utilise sa formule SU indiquée. Aucune colonne transformée n’est enregistrée dans cet exemple. Ces formules changent l’échelle d’analyse, et non les durées enregistrées.
| Transformation | Famille | Paramètres de transformation | Formule directe |
|---|---|---|---|
| Normal after Box–Cox | Box–Cox | power = 0; optimal_power = 0.0480987 | ln(X) |
| Normal after Johnson | SU | gamma = -1.21067; eta = 1.31136; epsilon = 12.0096; lambda = 5.44783 | gamma + eta·asinh((X−epsilon)/lambda) |
- Les paramètres normaux et les percentiles après transformation sont dans les unités transformées.
Graphiques de probabilité 5–8
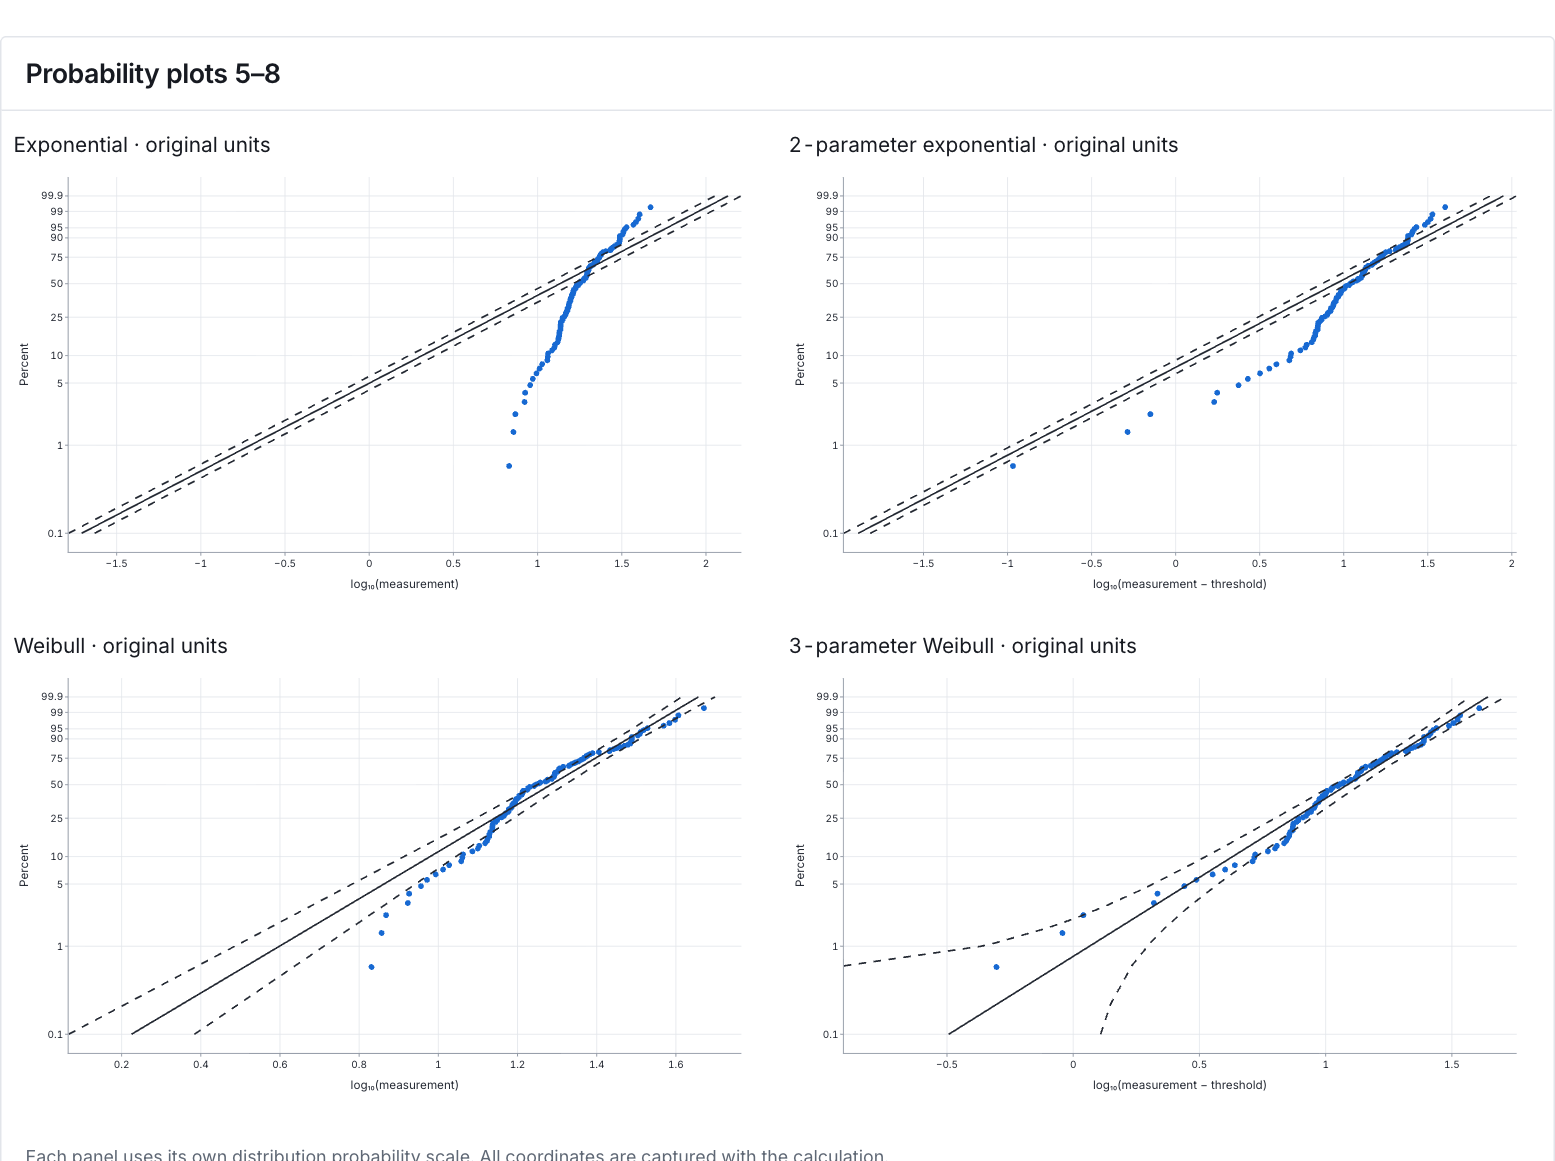
Comparez les quatre graphiques de probabilité candidats suivants avec l’échelle propre à chaque panneau. Les courbures et les écarts dans les queues indiquent où un modèle ajusté peut mal décrire les durées d’achèvement ; conservez les réserves des panneaux.
Graphiques de probabilité 9–12
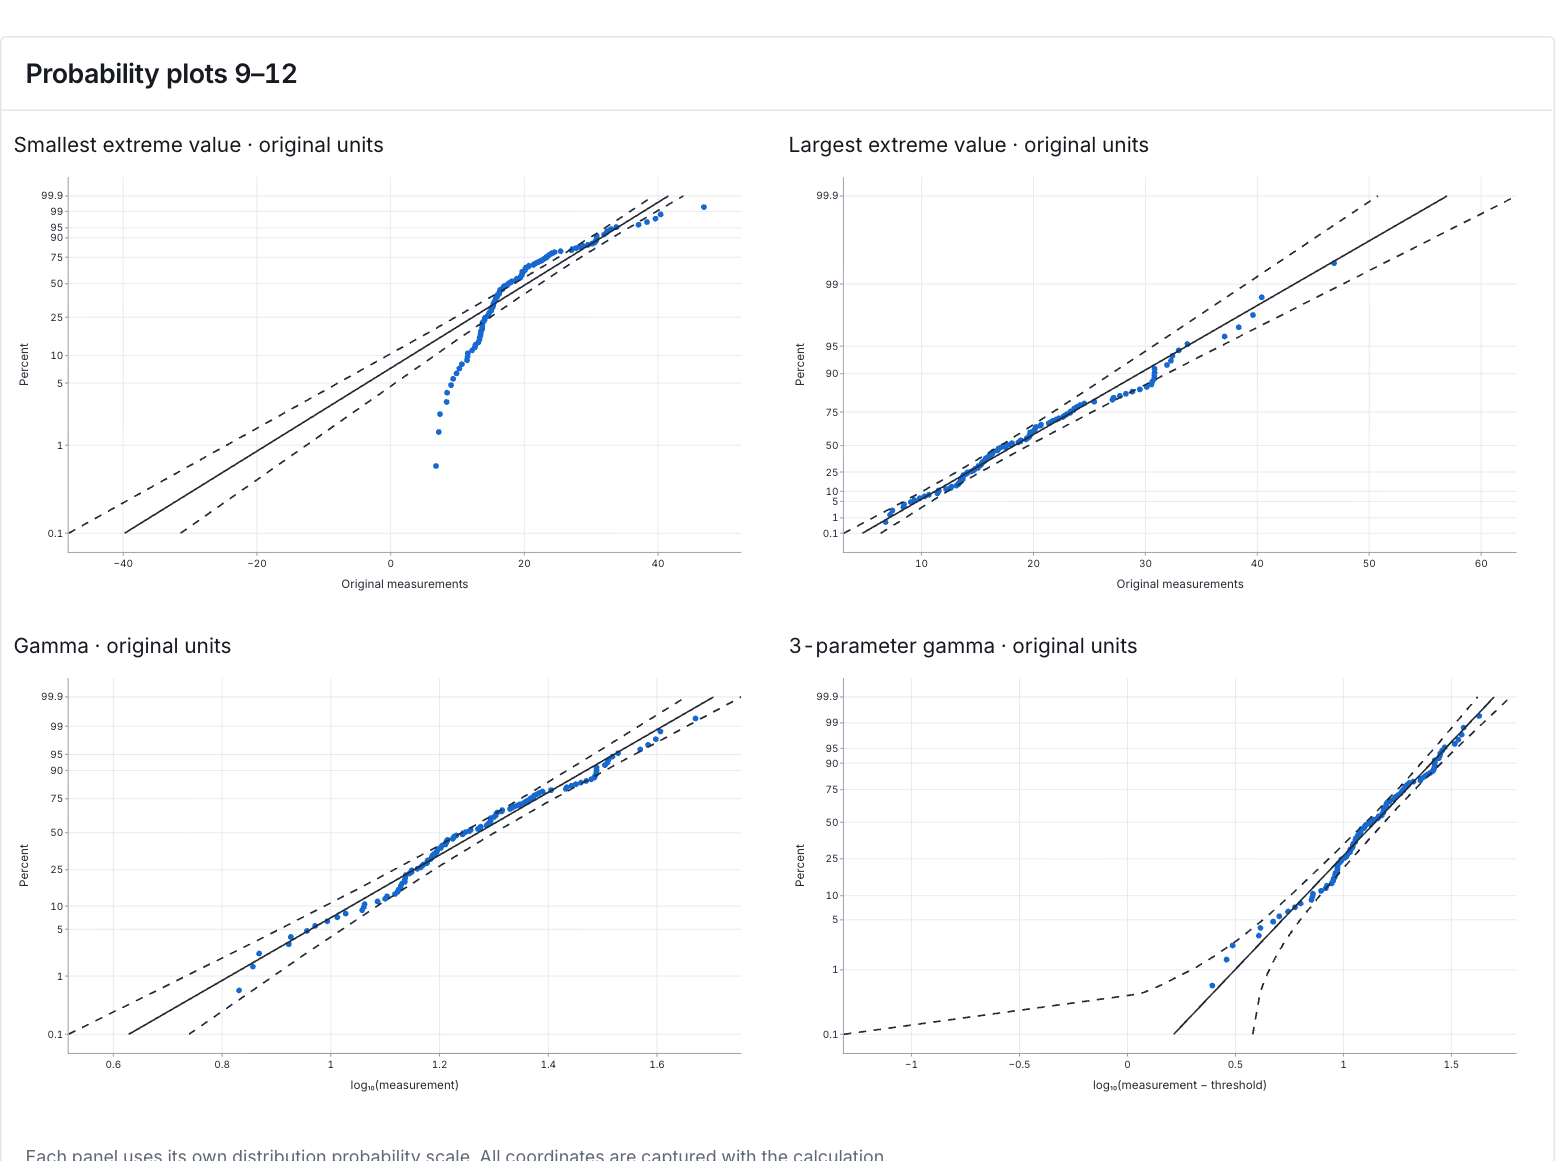
Ces graphiques de probabilité étendent la comparaison aux quatre modèles candidats configurés suivants. Lisez leurs échelles propres et leurs queues de durées longues, sans juger les modèles uniquement sur leur ressemblance visuelle.
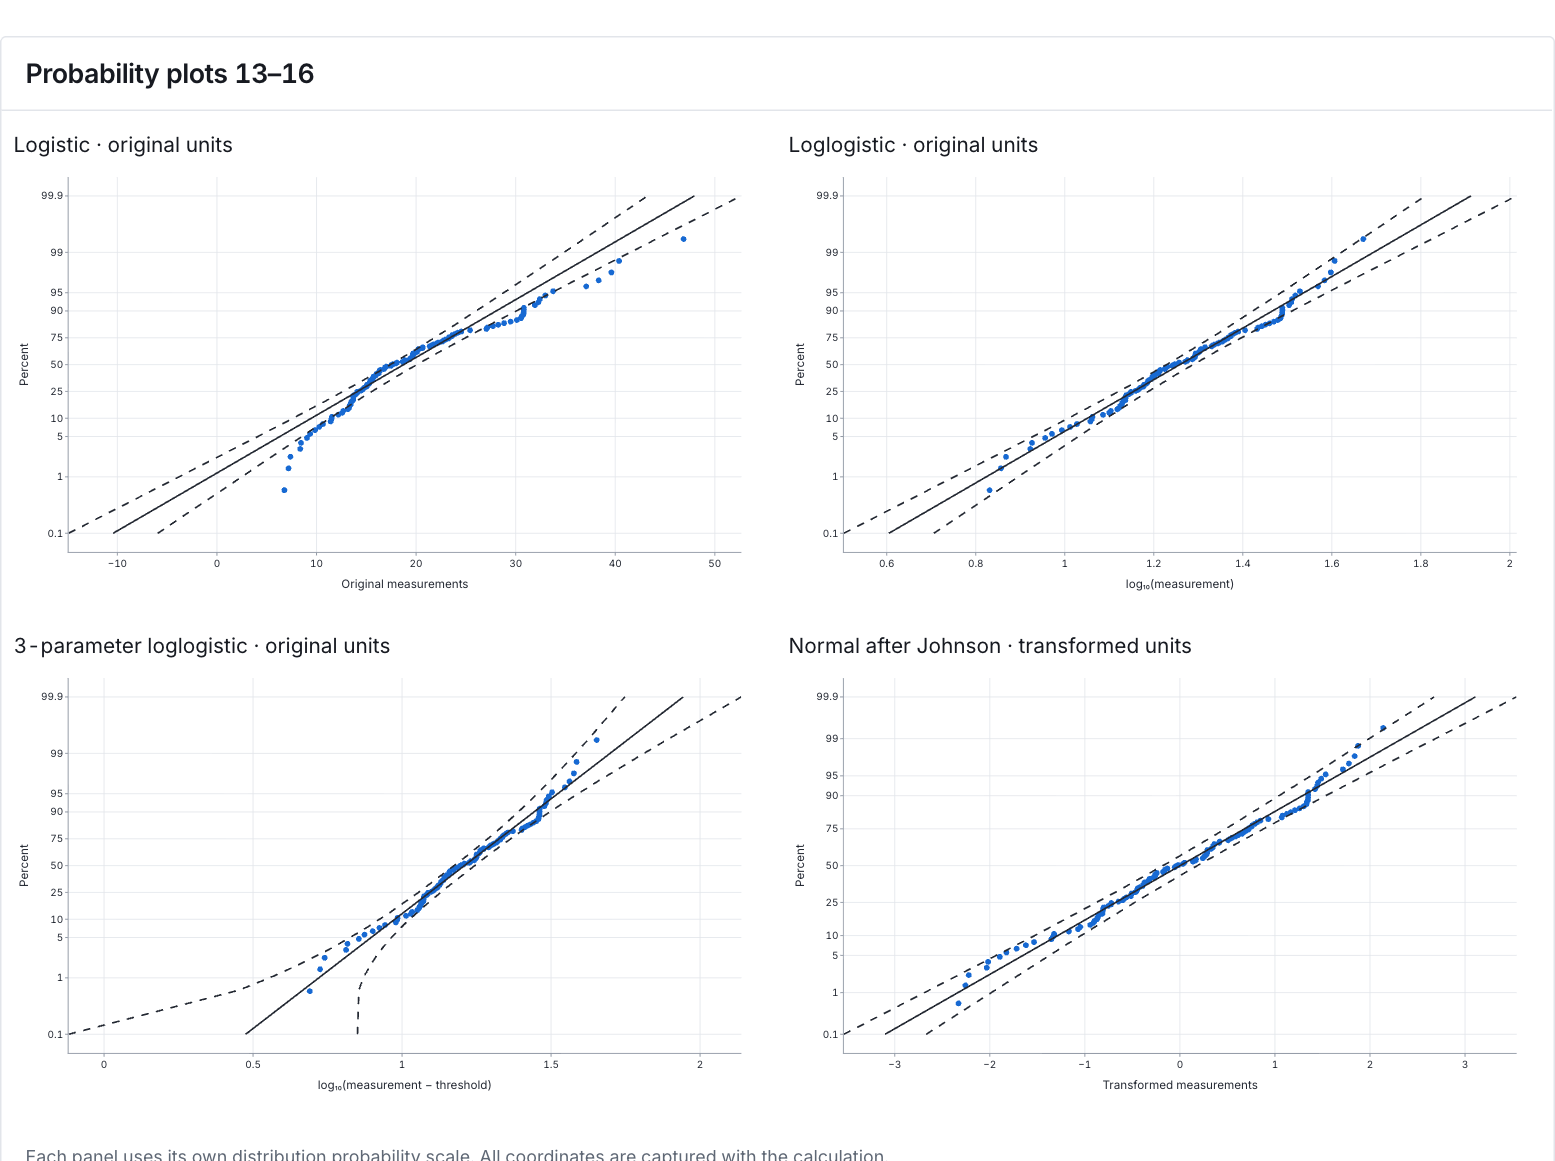
Graphiques de probabilité 13–16
Lisez les graphiques de probabilité candidats restants, y compris les ajustements normaux après transformation, sur leurs échelles indiquées. Une structure d’apparence rectiligne n’identifie pas un modèle vrai unique et ne supprime pas les limites méthodologiques.
Réserve concernant Weibull à trois paramètres
La valeur p AD de Weibull enregistrée est de 0.018302630915132106. La méthode enregistrée est la table 1, cas 7 de Lockhart–Stephens, avec interpolation sur l’inverse du paramètre de forme et sur la probabilité ; la qualification des cas limites de l’implémentation est en attente. Conservez cette réserve en discutant les éléments défavorables à cet ajustement. Ce n’est pas une probabilité sans réserve, entièrement validée.
8. Créer un rapport
Conservez tous les Goodness-of-fit tests, Candidate outcomes, Parameter estimates, Transformation details, Descriptive statistics et les quatre figures de graphiques de probabilité regroupés. Conservez les bornes de restitution, les probabilités indisponibles et toutes les réserves méthodologiques, y compris les intervalles conditionnels de l’exponentielle décalée.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.