

App-Befehle, Arbeitsblattkennungen und Werte der Beispieldaten bleiben im Original erhalten. Screenshots, Diagramme und Dateien zum Herunterladen liegen im englischen Original vor. Die Zahlen in dieser Anleitung verwenden die englische Schreibweise mit Dezimalpunkt und Tausenderkomma.
Beispiel: Bearbeitungszeiten von Prüfaufträgen am Prüfstand
120 abgeschlossene Prüfaufträge; eine positive Dauer pro Auftrag.
Beispieldaten herunterladen (CSV, englisches Original)Dasselbe Beispiel finden Sie unter Help. Importieren Sie die CSV-Datei, um den Schritten zu folgen, oder verwenden Sie Open example in a practice copy in Help, um die Eingaben vorab ausfüllen zu lassen.
1. Arbeitsumgebung erstellen
Öffnen Sie Basic Statistics in der Seitenleiste und wählen Sie Distribution Fit Analysis. Erstellen Sie eine Analyse, geben Sie ihr einen Namen, wählen Sie New blank worksheet und anschließend Create analysis.
2. Beispieldaten importieren
Laden Sie die CSV-Datei oben herunter und importieren Sie sie in das Arbeitsblatt. Wählen Sie Comma als Trennzeichen, Dot als Dezimaltrennzeichen und First row contains column names.
3. Messwerte zuordnen
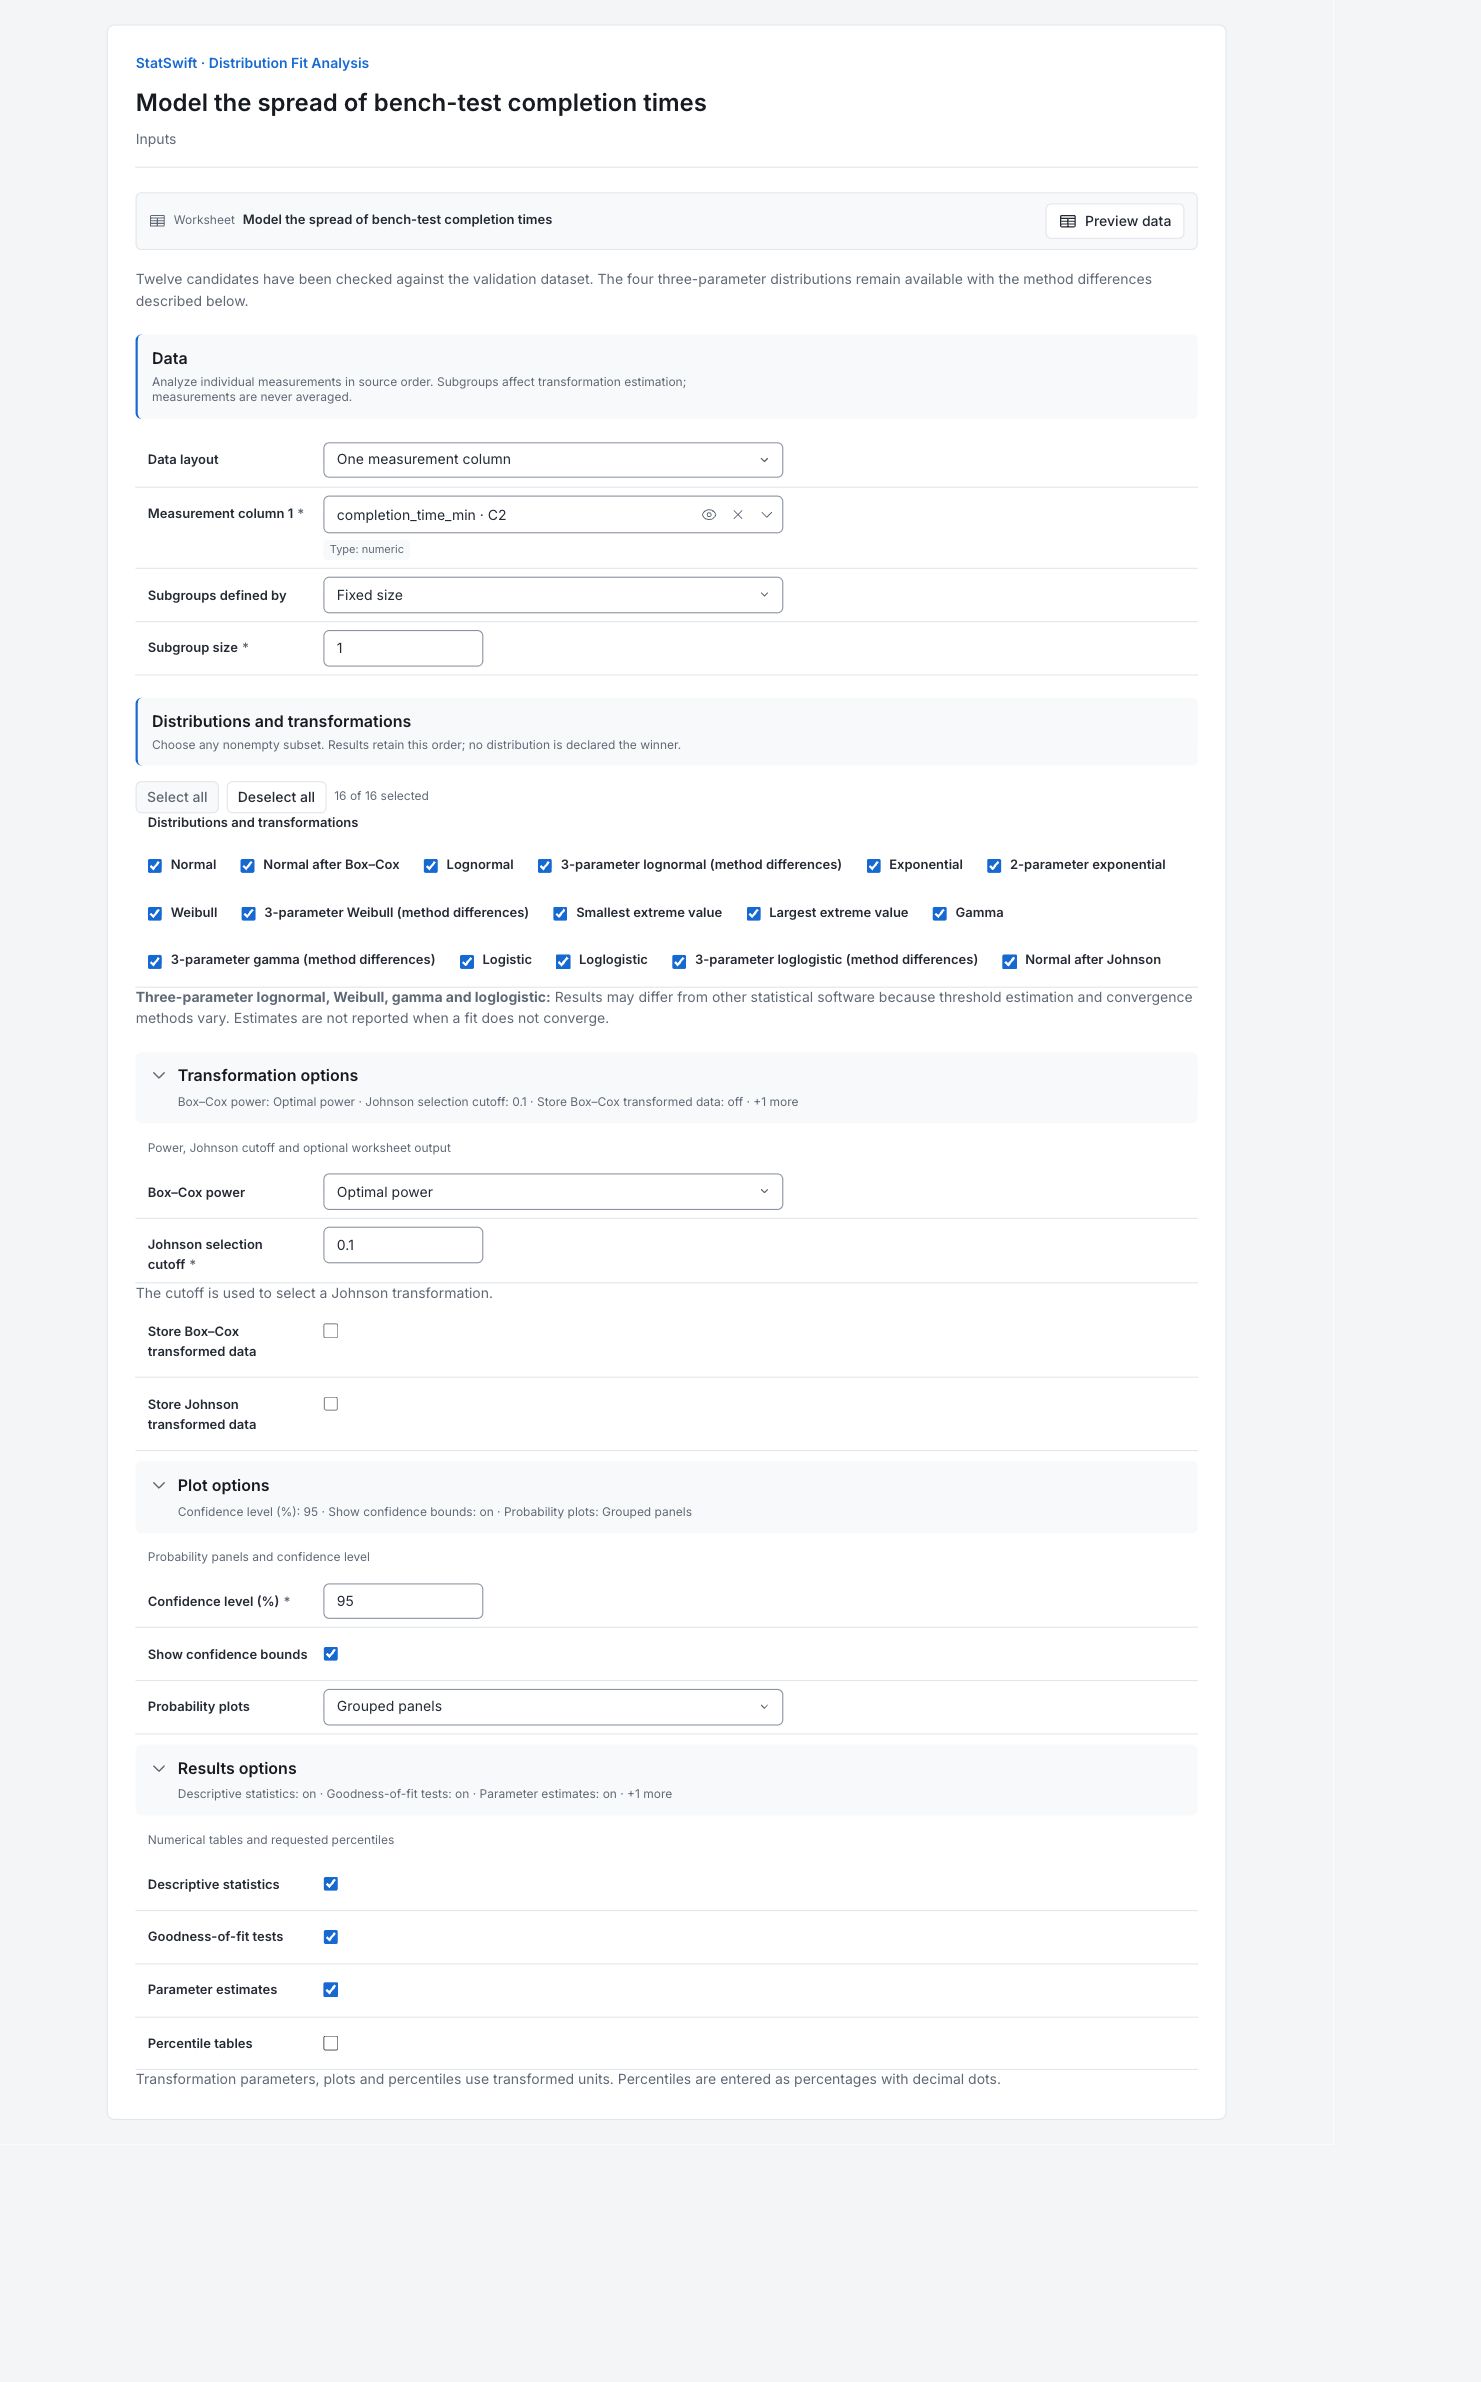
Wählen Sie unter Inputs für Data layout die Option One measurement column. Ordnen Sie completion_time_min dem Feld Measurement column 1 zu. Wählen Sie Fixed size für Subgroups defined by und geben Sie 1 in Subgroup size ein.
4. Kandidaten und Transformationen wählen
Wählen Sie unter Distributions and transformations die Option Select all, sodass alle 16 of 16 Kandidaten ausgewählt sind. Behalten Sie ihre Reihenfolge bei.
Öffnen Sie Transformation options. Wählen Sie Optimal power für Box–Cox power und geben Sie 0.1 in Johnson selection cutoff ein. Lassen Sie Store Box–Cox transformed data und Store Johnson transformed data deaktiviert.
5. Diagramme und Ergebnistabellen einstellen
Öffnen Sie Plot options. Geben Sie 95 in Confidence level (%) ein, aktivieren Sie Show confidence bounds und wählen Sie Grouped panels für Probability plots. Öffnen Sie Results options, aktivieren Sie Descriptive statistics, Goodness-of-fit tests und Parameter estimates und lassen Sie Percentile tables deaktiviert.
6. Analyse ausführen
Wählen Sie Run analysis und öffnen Sie anschließend Results.
7. Ergebnisse interpretieren
Vergleich bestimmen
Alle 120 positiven Bearbeitungszeiten sind enthalten, eine pro abgeschlossenem Auftrag. Der Mittelwert beträgt 19.597 Minuten. Sechzehn Verteilungen und Transformationen werden in der ausgewählten Reihenfolge verglichen; das Werkzeug wählt keine eindeutig wahre Verteilungsfamilie aus.
Die ersten vier Diagramme vergleichen
Die Teilgrafiken zeigen Normalverteilung, Normalverteilung nach Box–Cox-Transformation, Lognormalverteilung und Lognormalverteilung mit 3 Parametern. Jeder Punkt ist eine sortierte Dauer auf der angegebenen Skala der jeweiligen Teilgrafik. Achten Sie auf einen annähernd geradlinigen Verlauf und prüfen Sie die Verteilungsenden und Konfidenzgrenzen. Die übrigen 12 Teilgrafiken finden Sie unter More details.
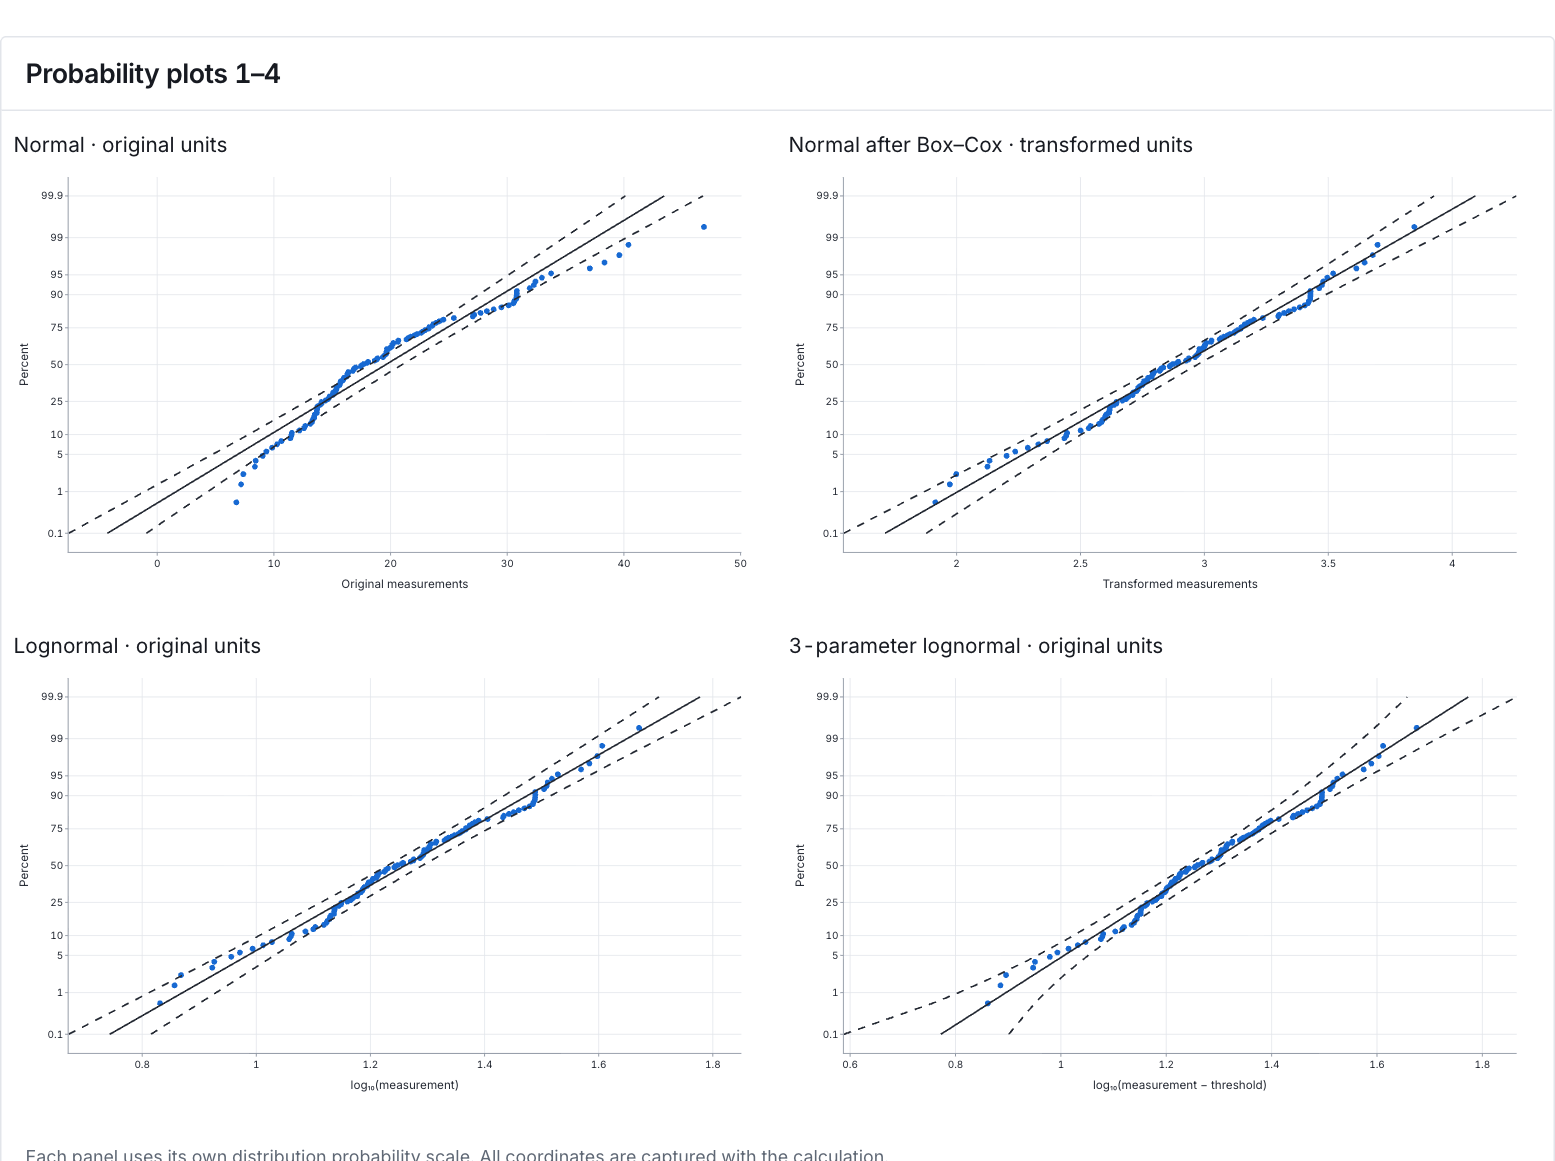
Englische Wahrscheinlichkeitsdiagramme 1–4. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Hinweise zur Anpassung ablesen
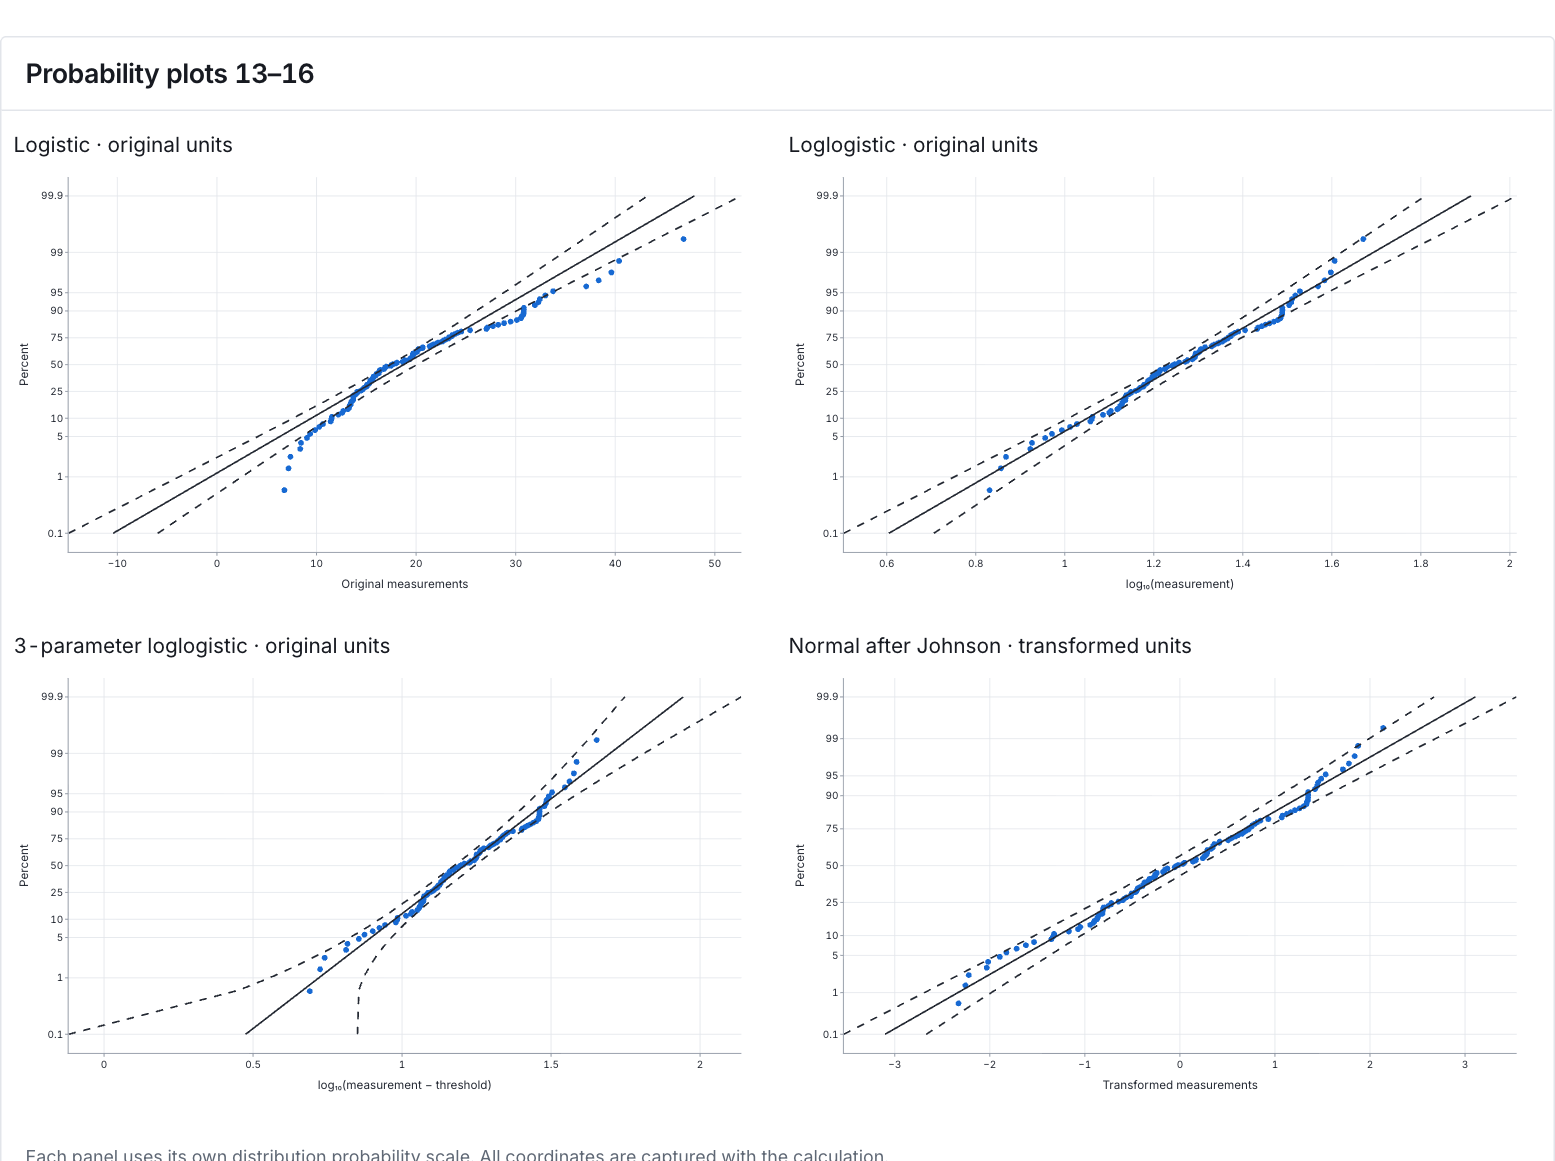
Die Anpassung der Normalverteilung ergibt AD = 2.7369 und p < 0.005, was auf eine schlechte Anpassung der Normalverteilung hinweist. Die Lognormalverteilung ergibt p = 0.1514; auch die loglogistische Verteilung und die Extremwertverteilung für Maxima werden bei 0.05 nicht verworfen. Mehrere Modelle bleiben plausibel. Ein höherer p-Wert allein bestimmt nicht das beste Modell.
Nicht verfügbare Ergebnisse und Skalen klar unterscheiden
In den Zeilen der Lognormal-, Gamma- und loglogistischen Verteilung mit 3 Parametern sind die AD-p-Werte nicht verfügbar; nicht verfügbar bedeutet keinen bestandenen Test. Die Zeile der Weibull-Verteilung mit 3 Parametern gibt dagegen p≈0.0183 an, wobei die Validierung der Methode in den Randbereichen noch aussteht. Box–Cox- und Johnson-Anpassungen verwenden transformierte Einheiten, keine Minuten.
Ein Modell für die beabsichtigte Entscheidung wählen
Vergleichen Sie das Verhalten plausibler Modelle bei den relevanten Dauern, insbesondere am Verteilungsende der langen Dauern. Bewahren Sie die Methodenhinweise auf und prüfen Sie die Vorhersageleistung, bevor Sie angepasste Perzentile für eine Entscheidung über Bearbeitungszeiten verwenden.
Weitere Einzelheiten: die einzelnen Ergebnisabschnitte lesen
Vollständige Ergebnistabellen verwenden wie im Bereich Help sechs signifikante Stellen.
Anpassungstests
Candidate bezeichnet eine Verteilung oder eine Normalanpassung nach Transformation. AD misst die Abweichung auf der jeweiligen Wahrscheinlichkeitsskala; AD p-value kann eine Zahl, eine Ausgabegrenze oder Unavailable sein. Lesen Sie den Zellhinweis. Likelihood-ratio statistic und LRT p-value vergleichen dafür geeignete geschachtelte Familien; sie sind nicht der AD-Anpassungstest. Not applicable und Unavailable sind keine bestandenen Ergebnisse. Der AD-p-Wert der Weibull-Verteilung mit 3 Parametern ist numerisch, etwa 0.0183, bei noch ausstehender Validierung der Randbereiche; die Werte für die Lognormal-, Gamma- und loglogistische Verteilung mit 3 Parametern sind nicht verfügbar.
| Kandidat | AD | AD-p-Wert | Likelihood-Quotienten-Statistik | LRT-p-Wert |
|---|---|---|---|---|
| Normal | 2.73688 | < 0.005Stephens-Approximation für den AD-Test auf Normalverteilung; untere Grenze der numerischen Ausgabe 0.005 | — | Nicht zutreffend |
| Normal after Box–Cox | 0.552479 | 0.151353Stephens-Approximation für den AD-Test auf Normalverteilung; untere Grenze der numerischen Ausgabe 0.005 | — | Nicht zutreffend |
| Lognormal | 0.552479 | 0.151353Stephens-Approximation für den AD-Test auf Normalverteilung; untere Grenze der numerischen Ausgabe 0.005 | — | Nicht zutreffend |
| 3-parameter lognormal | 0.564131 | Nicht verfügbarFür diese Familie mit drei Parametern ist keine AD-Wahrscheinlichkeit verfügbar. | 0.0222193 | 0.881505Chi-Quadrat, 1 Freiheitsgrad; angepasste maximale Likelihood-Werte |
| Exponential | 22.216 | < 0.003Stephens, Tabelle 4.12, Signifikanzformeln für die Exponentialverteilung, Korrektur 1+0.6/n; anwendungseigene Kontrollprüfungen beiderseits von 0.26, 0.51, 0.95 und 2.534 | — | Nicht zutreffend |
| 2-parameter exponential | 9.52934 | < 0.01Stephens, Tabelle 4.14, Korrektur 1+5.4/n-11/n²; lineare Tabelleninterpolation | 99.8966 | 1.60565e-23Chi-Quadrat, 1 Freiheitsgrad; adjustierte Likelihood der verschobenen Exponentialverteilung |
| Weibull | 2.14725 | < 0.01Stephens-Korrektur für Extremwerte 1+0.2/sqrt(n); lineare Tabelleninterpolation | — | Nicht zutreffend |
| 3-parameter Weibull | 0.952225 | 0.0183026Lockhart–Stephens, Tabelle 1, Fall 7; Interpolation über den Kehrwert des Formparameters und die Wahrscheinlichkeit; Validierung der Randbereiche in der Anwendung noch ausstehend | 14.422 | 0.000146086Chi-Quadrat, 1 Freiheitsgrad; angepasste maximale Likelihood-Werte |
| Smallest extreme value | 6.55729 | < 0.01Stephens-Korrektur für Extremwerte 1+0.2/sqrt(n); lineare Tabelleninterpolation | — | Nicht zutreffend |
| Largest extreme value | 0.581117 | 0.141662Stephens-Korrektur für Extremwerte 1+0.2/sqrt(n); lineare Tabelleninterpolation | — | Nicht zutreffend |
| Gamma | 0.917041 | 0.0215001Stephens, Tabelle 4.21; erste Zeile unterhalb eines Formparameters von 1, lineare Interpolation über Formparameter und Wahrscheinlichkeit, asymptotische Zeile oberhalb eines Formparameters von 20; umfassendere Validierung der Randbereiche noch ausstehend | — | Nicht zutreffend |
| 3-parameter gamma | 0.664386 | Nicht verfügbarFür diese Familie mit drei Parametern ist keine AD-Wahrscheinlichkeit verfügbar. | 2.03791 | 0.15342Chi-Quadrat, 1 Freiheitsgrad; berichtete modifizierte Gamma-Likelihood |
| Logistic | 2.04259 | < 0.005Stephens-Korrektur für die logistische Verteilung 1+0.25/n; lineare Tabelleninterpolation | — | Nicht zutreffend |
| Loglogistic | 0.524443 | 0.141019Stephens-Korrektur für die logistische Verteilung 1+0.25/n; lineare Tabelleninterpolation | — | Nicht zutreffend |
| 3-parameter loglogistic | 0.471833 | Nicht verfügbarFür diese Familie mit drei Parametern ist keine AD-Wahrscheinlichkeit verfügbar. | 0.268154 | 0.604573Chi-Quadrat, 1 Freiheitsgrad; angepasste maximale Likelihood-Werte |
| Normal after Johnson | 0.395435 | 0.366495Stephens-Approximation für den AD-Test auf Normalverteilung; untere Grenze der numerischen Ausgabe 0.005 | — | Nicht zutreffend |
- Die Kandidaten werden in der vorgegebenen Reihenfolge angezeigt, ohne eine Verteilung als beste auszuwählen.
- Likelihood-Quotienten-Tests vergleichen verschobene Familien mit ihren nicht verschobenen Varianten. Die verschobene Exponentialverteilung verwendet ihre adjustierten Schätzwerte; andere Familien verwenden ihre angepassten maximalen Likelihood-Werte.
Deskriptive Statistik
Observations beträgt 120, Missing cells beträgt 0 und Nonempty subgroups beträgt 120. Mean, Median, Min und Max beschreiben Dauern in Minuten; Standard deviation beschreibt ihre Streuung. Die Untergruppengröße 1 belässt die Messwerte als Einzelwerte.
Ursprüngliche Messwerte, ohne Mittelung innerhalb von Untergruppen zusammengefasst.
| Kennzahl | Wert |
|---|---|
| Beobachtungen | 120 |
| Fehlende Zellen | 0 |
| Nicht leere Untergruppen | 120 |
| Mittelwert | 19.597 |
| Standardabweichung | 7.72253 |
| Minimum | 6.78 |
| Median | 17.605 |
| Maximum | 46.86 |
| Schiefe | 0.99684 |
| Exzess | 0.907451 |
Ergebnisse der Kandidaten
Status gibt an, ob ein Kandidat berechnet wurde oder nicht verfügbar war. Scale unterscheidet ursprüngliche und transformierte Ergebnisse. Explanation bewahrt Einschränkungen zu Validierung, Konvergenz und Methode. Alle 16 Ergebnisse sind enthalten; lassen Sie ein nicht verfügbares Ergebnis nicht stillschweigend weg.
| Kandidat | Status | Skala | Erläuterung |
|---|---|---|---|
| Normal | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| Normal after Box–Cox | Berechnet | transformiert | Anhand des Validierungsdatensatzes geprüft |
| Lognormal | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| 3-parameter lognormal | Berechnet | Original | Die Ergebnisse können von anderer Statistiksoftware abweichen, da sich die Schätzung des Schwellenwerts und die Konvergenzverfahren unterscheiden. Bei fehlender Konvergenz der Anpassung werden keine Schätzwerte angegeben. |
| Exponential | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| 2-parameter exponential | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| Weibull | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| 3-parameter Weibull | Berechnet | Original | Die Ergebnisse können von anderer Statistiksoftware abweichen, da sich die Schätzung des Schwellenwerts und die Konvergenzverfahren unterscheiden. Bei fehlender Konvergenz der Anpassung werden keine Schätzwerte angegeben. |
| Smallest extreme value | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| Largest extreme value | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| Gamma | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| 3-parameter gamma | Berechnet | Original | Die Ergebnisse können von anderer Statistiksoftware abweichen, da sich die Schätzung des Schwellenwerts und die Konvergenzverfahren unterscheiden. Bei fehlender Konvergenz der Anpassung werden keine Schätzwerte angegeben. |
| Logistic | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| Loglogistic | Berechnet | Original | Anhand des Validierungsdatensatzes geprüft |
| 3-parameter loglogistic | Berechnet | Original | Die Ergebnisse können von anderer Statistiksoftware abweichen, da sich die Schätzung des Schwellenwerts und die Konvergenzverfahren unterscheiden. Bei fehlender Konvergenz der Anpassung werden keine Schätzwerte angegeben. |
| Normal after Johnson | Berechnet | transformiert | Anhand des Validierungsdatensatzes geprüft |
Parameterschätzungen
Die Parameter folgen der mathematischen Konvention des jeweiligen Kandidaten. Scale und Convention erklären ihre Interpretation; Lage- und Skalenparameter der Lognormalverteilung beziehen sich auf ln(X − threshold), obwohl das Modell die ursprünglichen Dauern beschreibt. Parameter einer Normalanpassung nach Transformation verwenden transformierte Einheiten. Bewahren Sie Einschränkungen zum Schwellenparameter und zur Kovarianz mit sämtlichen Schätzwerten auf.
| Kandidat | Parameter | Skala | Konvention |
|---|---|---|---|
| Normal | location = 19.597; scale = 7.72253 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Normal after Box–Cox | location = 2.90216; scale = 0.385417 | transformiert | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Lognormal | location = 2.90216; scale = 0.385417 | Original | Lage und Skala beziehen sich auf ln(X − Schwellenwert). |
| 3-parameter lognormal | location = 2.93063; scale = 0.372998; threshold = -0.489666 | Original | Lage und Skala beziehen sich auf ln(X − Schwellenwert). |
| Exponential | scale = 19.597 | Original | Initialisierung durch Regression im Wahrscheinlichkeitsnetz durch den Ursprung und Newton-Schätzungen auf logarithmischer Skala, mit relativer Abbruchtoleranz 1e−4 und absoluter Schritttoleranz 1e−6; die exakte Likelihood-Schätzung auf Basis des Stichprobenmittelwerts wird separat beibehalten. |
| 2-parameter exponential | scale = 12.9247; threshold = 6.67229 | Original | Initialisierung durch Regression im Wahrscheinlichkeitsnetz, abwechselnde Newton-Aktualisierungen auf logarithmischer Skala und Schwellenwert = Minimum − Skala/n; das gemeinsame Abbruchkriterium für Parameter und Likelihood wurde anhand des Validierungsdatensatzes geprüft. Die Likelihood-Schätzung am Rand des Trägers wird separat beibehalten. |
| Weibull | shape = 2.6814; scale = 22.0651 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| 3-parameter Weibull | shape = 1.79811; scale = 14.9711; threshold = 6.28336 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Smallest extreme value | location = 23.7574; scale = 9.20238 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Largest extreme value | location = 16.1294; scale = 5.91185 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Gamma | shape = 6.99122; scale = 2.80309 | Original | Greenwood–Durand-Initialisierung, relatives Newton-Abbruchkriterium bei 1e−4 und linearisierte abschließende Skalenaktualisierung; exakte Likelihood-Schätzungen werden separat beibehalten. |
| 3-parameter gamma | shape = 3.99933; scale = 3.82201; threshold = 4.31151 | Original | Endliche bedingte Gamma-Schätzung, gefolgt von Schwellenwert = Minimum − Gamma-Quantil bei 1/(n+1); gemeinsame Konvergenz von Parametern und Likelihood. Form und Skala werden aus dem vorhergehenden Schwellenwertschritt beibehalten. |
| Logistic | location = 18.7606; scale = 4.22543 | Original | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
| Loglogistic | location = 2.89811; scale = 0.217969 | Original | Lage und Skala beziehen sich auf ln(X − Schwellenwert). |
| 3-parameter loglogistic | location = 2.7846; scale = 0.244789; threshold = 1.88031 | Original | Lage und Skala beziehen sich auf ln(X − Schwellenwert). |
| Normal after Johnson | location = 0.00290881; scale = 1.00489 | transformiert | Für Skala und Form gelten die mathematischen Referenzkonventionen. |
Transformationsdetails
Transformation, Family, Parameter und Forward formula dokumentieren die angepassten Transformationen. Box–Cox verwendet hier ln(X); Johnson verwendet die angegebene SU-Formel. Keine der beiden transformierten Spalten wird in diesem Beispiel gespeichert. Diese Formeln ändern die Analyseskala, nicht die aufgezeichneten Dauern.
| Transformation | Familie | Transformationsparameter | Vorwärtsformel |
|---|---|---|---|
| Normal after Box–Cox | Box–Cox | power = 0; optimal_power = 0.0480987 | ln(X) |
| Normal after Johnson | SU | gamma = -1.21067; eta = 1.31136; epsilon = 12.0096; lambda = 5.44783 | gamma + eta·asinh((X−epsilon)/lambda) |
- Parameter und Perzentile der Normalverteilung nach Transformation werden in transformierten Einheiten angegeben.
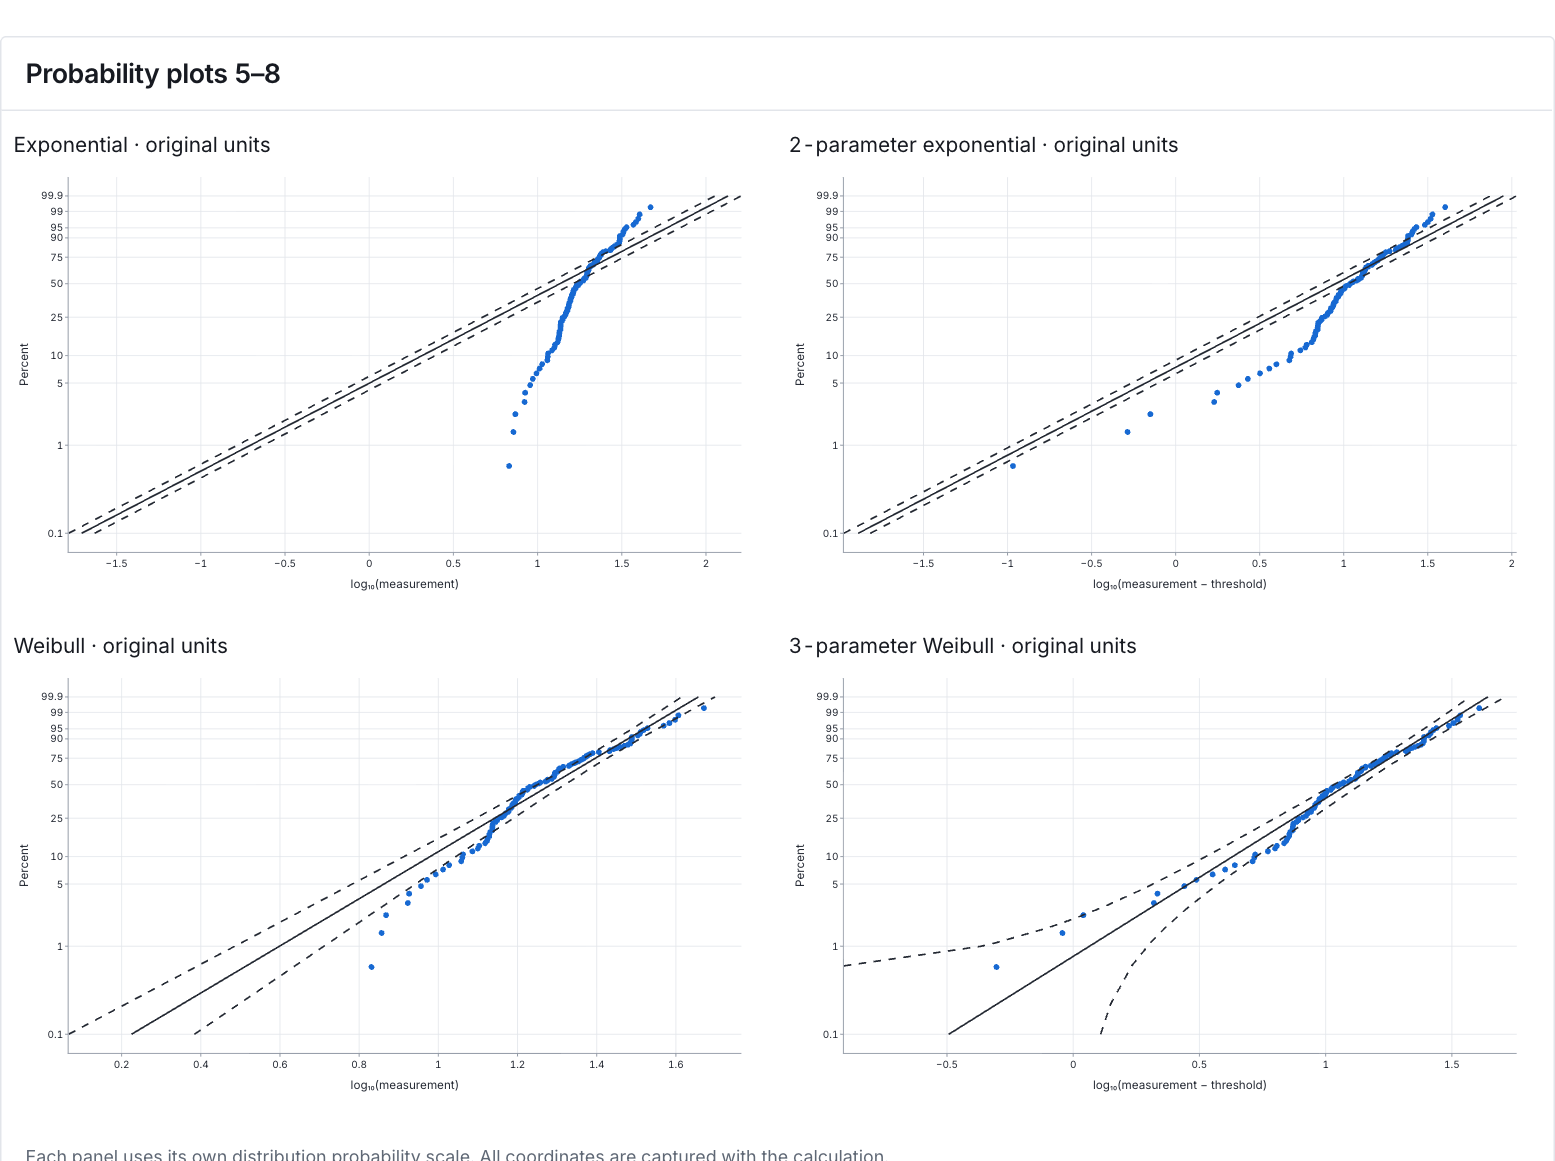
Wahrscheinlichkeitsdiagramme 5–8
Vergleichen Sie die nächsten vier Wahrscheinlichkeitsdiagramme der Kandidaten anhand der jeweiligen Skala jeder Teilgrafik. Krümmungen und Abweichungen an den Verteilungsenden zeigen, wo ein angepasstes Modell die Bearbeitungszeiten möglicherweise schlecht beschreibt; bewahren Sie sämtliche Einschränkungen der Teilgrafiken auf.
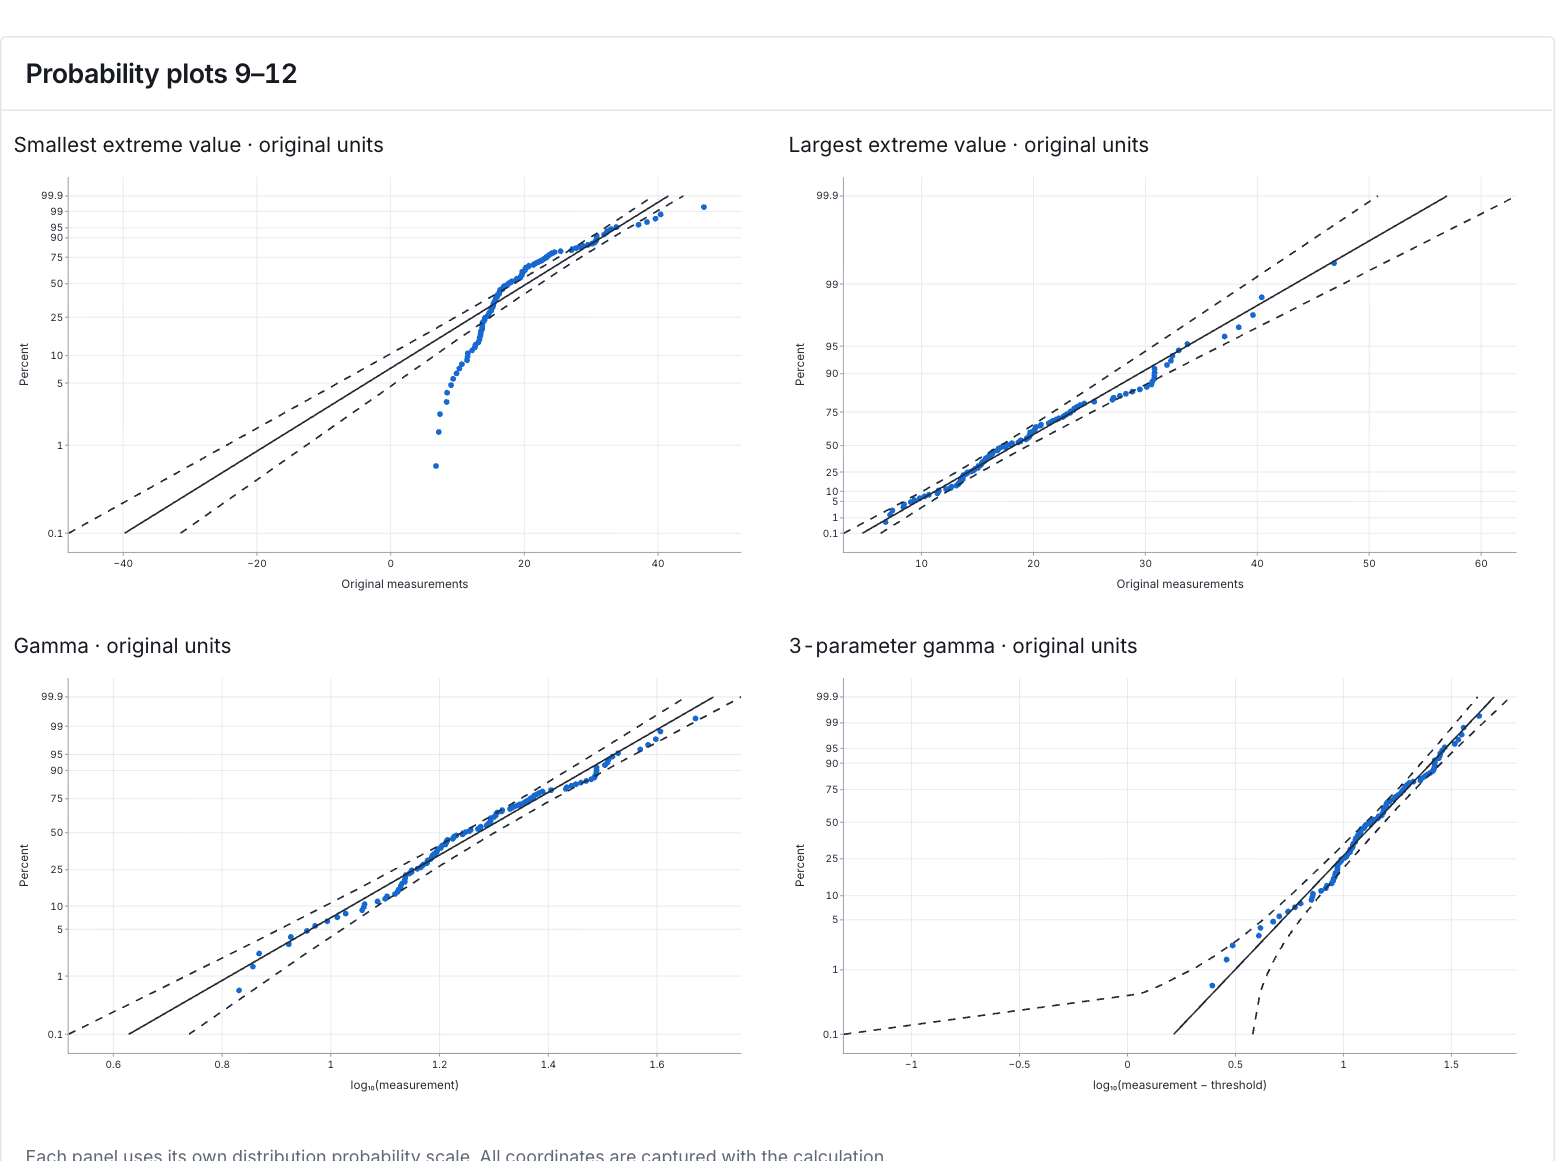
Wahrscheinlichkeitsdiagramme 9–12
Diese Wahrscheinlichkeitsdiagramme erweitern den Vergleich um die nächsten vier konfigurierten Kandidaten. Lesen Sie ihre jeweiligen Skalen und die Verteilungsenden der langen Dauern, statt Modelle allein nach visueller Ähnlichkeit zu beurteilen.
Wahrscheinlichkeitsdiagramme 13–16
Lesen Sie die übrigen Wahrscheinlichkeitsdiagramme der Kandidaten, einschließlich der Normalanpassungen nach Transformation, auf den angegebenen Skalen ab. Ein geradlinig erscheinendes Muster bestimmt kein eindeutig wahres Modell und beseitigt keine methodischen Einschränkungen.
Einschränkung für die Weibull-Verteilung mit drei Parametern
Der gespeicherte AD-p-Wert der Weibull-Verteilung beträgt 0.018302630915132106. Als Methode ist Lockhart–Stephens, Tabelle 1, Fall 7, mit Interpolation über den Kehrwert des Formparameters und die Wahrscheinlichkeit dokumentiert; die Validierung der Randbereiche in der Anwendung steht noch aus. Bewahren Sie diese Einschränkung auf, wenn Sie Hinweise gegen diese Anpassung besprechen. Es handelt sich nicht um eine uneingeschränkt und vollständig validierte Wahrscheinlichkeit.
8. Bericht erstellen
Behalten Sie alle Goodness-of-fit tests, Candidate outcomes, Parameter estimates, Transformation details, Descriptive statistics und alle vier englischen Abbildungen mit gruppierten Wahrscheinlichkeitsdiagrammen im Bericht. Bewahren Sie die Ausgabegrenzen, nicht verfügbaren Wahrscheinlichkeiten und sämtliche methodischen Einschränkungen auf, einschließlich der bedingten Intervalle für die verschobene Exponentialverteilung.
Wählen Sie Add to report im abgeschlossenen Analyselauf. Öffnen Sie Choose individual items and advanced options zur Auswahl von Tabellen und Diagrammen und wählen Sie anschließend Add to draft. Ausgeblendete Elemente bleiben in der gespeicherten Analyse erhalten.
Geben Sie dem Bericht einen Namen und ergänzen Sie den Zweck der Untersuchung sowie Ihre Interpretation. Wählen Sie Save, prüfen Sie Preview und verwenden Sie anschließend Export → Download HTML. Das folgende Beispiel enthält den gesamten ausgewählten Inhalt, auch Ergebnisse, die über eine Bildschirmansicht hinausgehen.