

Los comandos de la aplicación, los identificadores de las hojas de trabajo y los valores de los datos de ejemplo conservan su redacción original. Las capturas de pantalla, los gráficos y las descargas están en inglés. Los ejemplos conservan la notación numérica original en inglés: punto decimal y coma como separador de millares.
Ejemplo: tiempos de finalización de ensayos en banco
120 trabajos de ensayo finalizados; una duración positiva por trabajo.
Descargar los datos de ejemplo (CSV, columnas en inglés)Es el mismo ejemplo que se utiliza en Help. Importa el CSV para seguir los pasos o utiliza Open example in a practice copy en Help para rellenar previamente las entradas.
1. Crear el espacio de trabajo
En la barra lateral, abre Basic Statistics y elige Distribution Fit Analysis. Crea un análisis, ponle un nombre, selecciona New blank worksheet y elige Create analysis.
2. Importar los datos de ejemplo
Descarga el CSV anterior e impórtalo en la hoja de trabajo. Elige Comma como delimitador, Dot como separador decimal y First row contains column names.
3. Asignar las mediciones
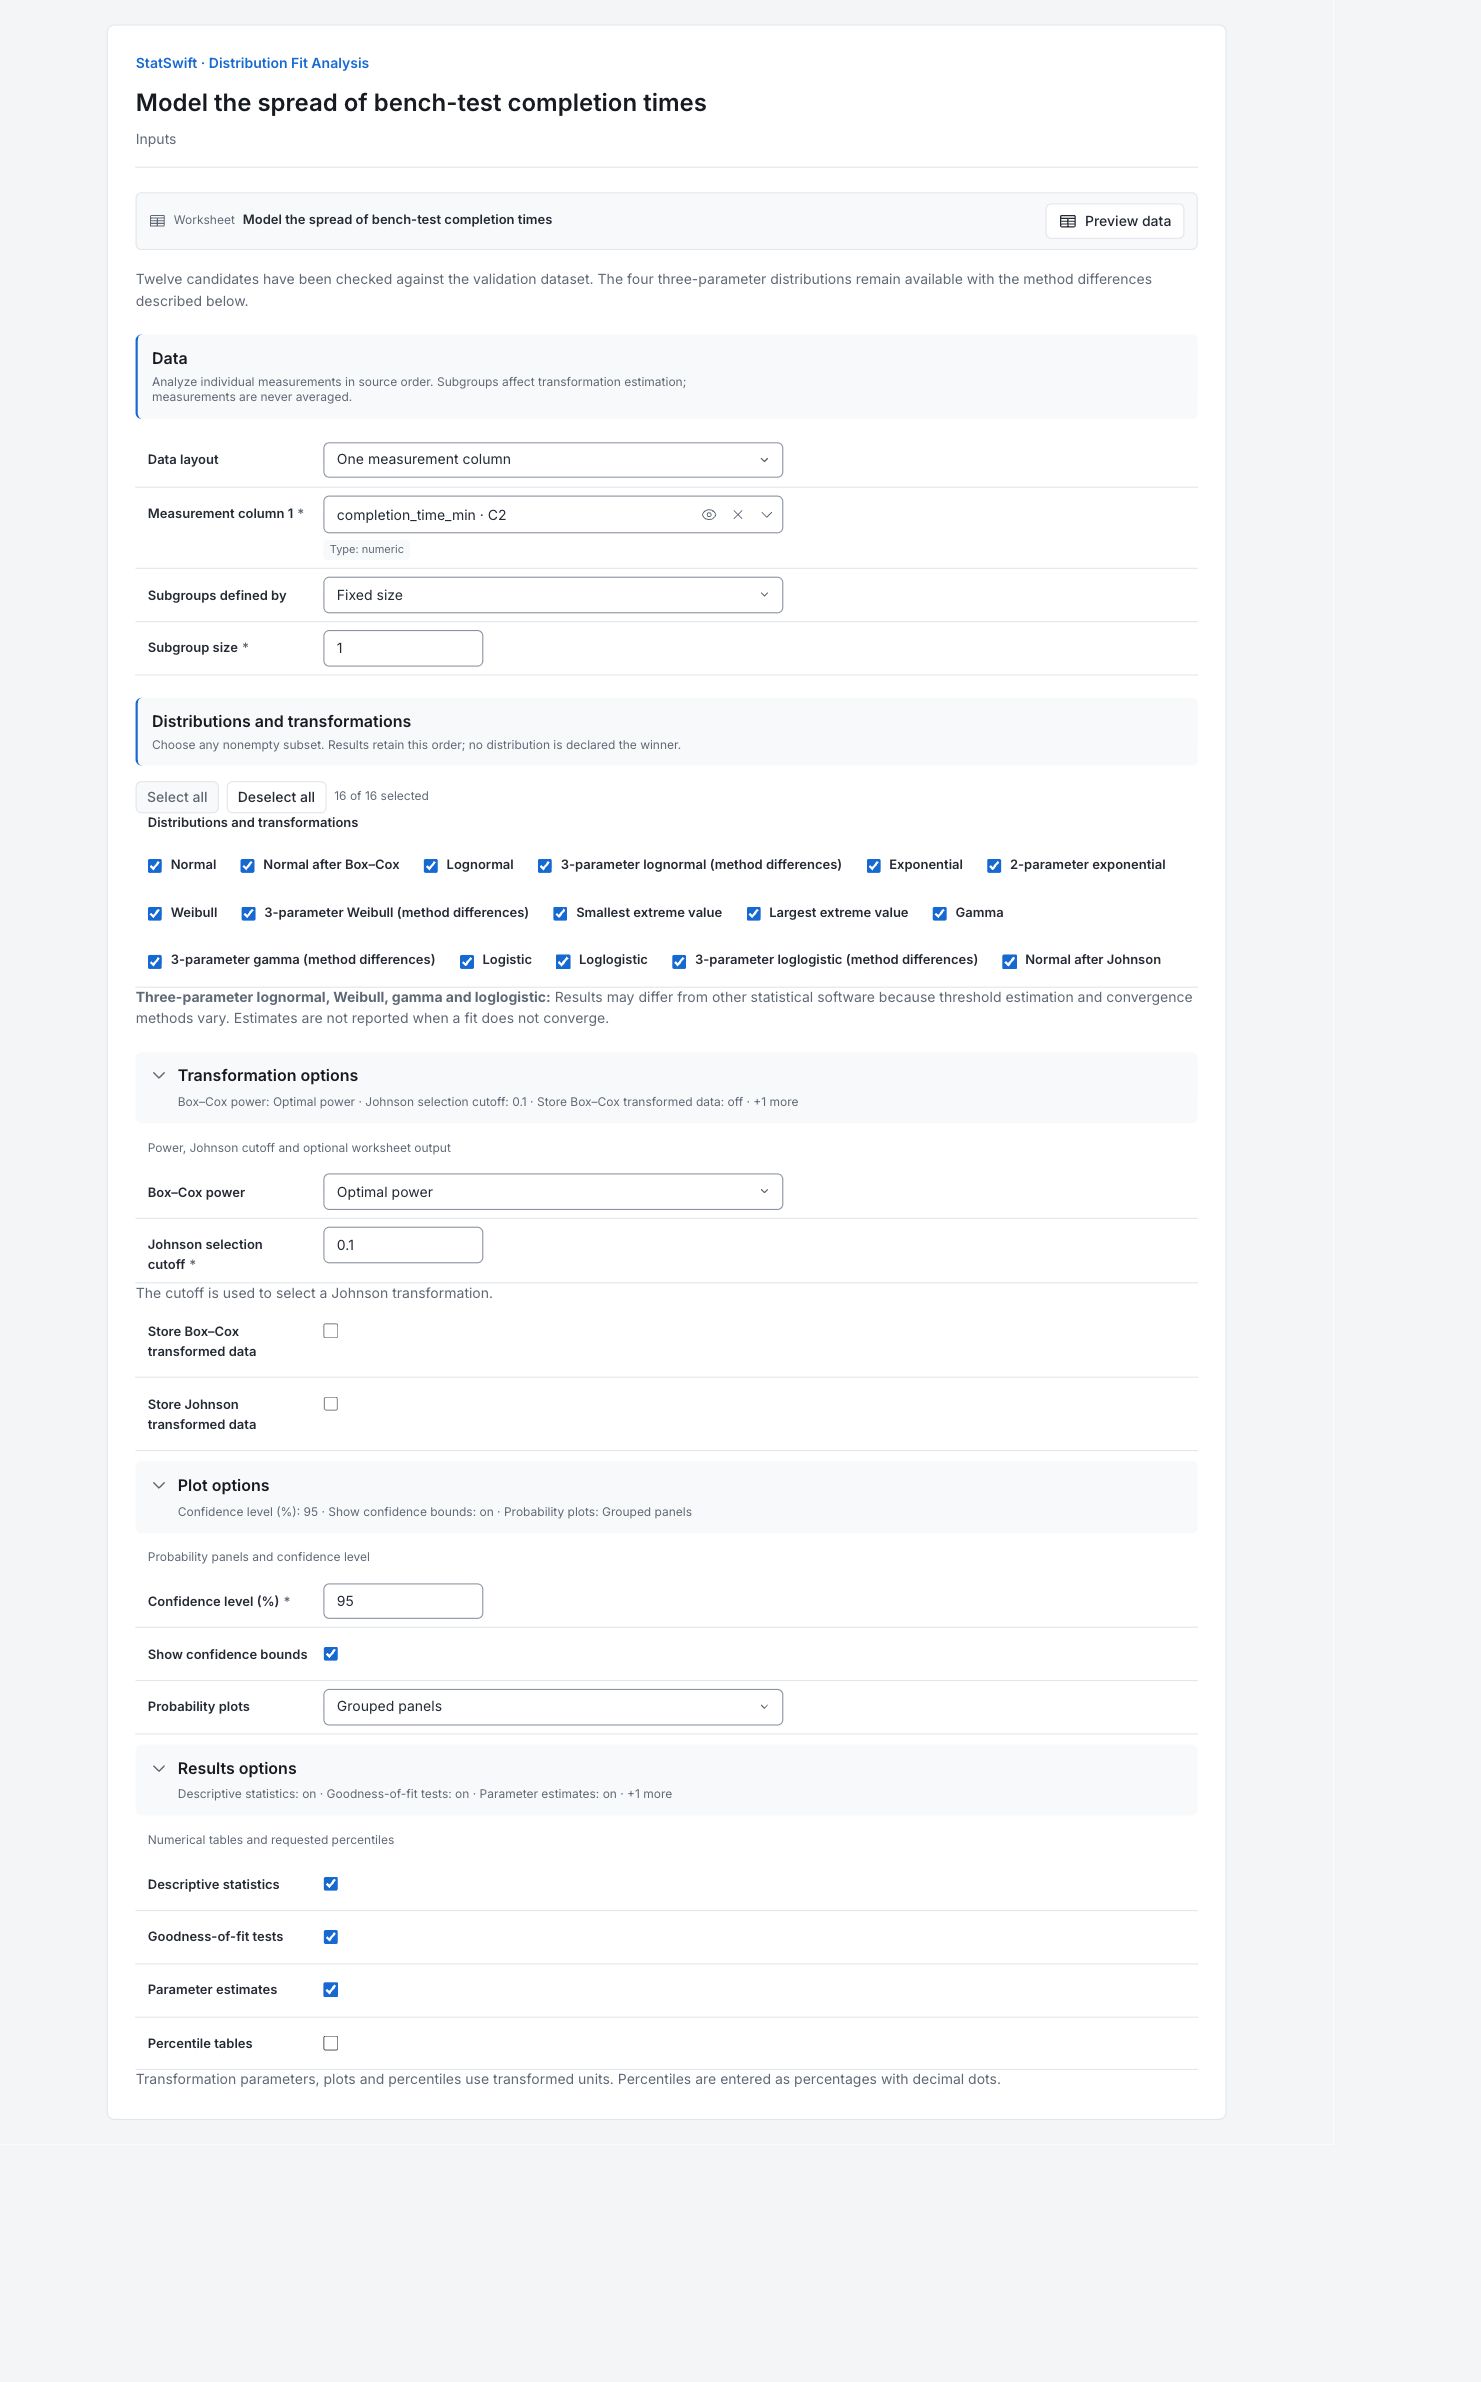
En Inputs, elige One measurement column en Data layout. Asigna completion_time_min a Measurement column 1. Elige Fixed size en Subgroups defined by e introduce 1 en Subgroup size.
4. Elegir las candidatas y las transformaciones
En Distributions and transformations, elige Select all para seleccionar las 16 of 16 candidatas. Conserva su orden.
Abre Transformation options. Elige Optimal power en Box–Cox power e introduce 0.1 en Johnson selection cutoff. Deja sin marcar Store Box–Cox transformed data y Store Johnson transformed data.
5. Configurar los gráficos y las tablas de resultados
Abre Plot options. Introduce 95 en Confidence level (%), marca Show confidence bounds y elige Grouped panels en Probability plots. Abre Results options, marca Descriptive statistics, Goodness-of-fit tests y Parameter estimates, y deja sin marcar Percentile tables.
6. Ejecutar el análisis
Elige Run analysis y abre Results.
7. Interpretar los resultados
Identificar la comparación
Se incluyen los 120 tiempos de finalización positivos, uno por trabajo finalizado. La media es 19.597 minutos. Se comparan dieciséis distribuciones y transformaciones en el orden seleccionado; la herramienta no elige una única familia verdadera.
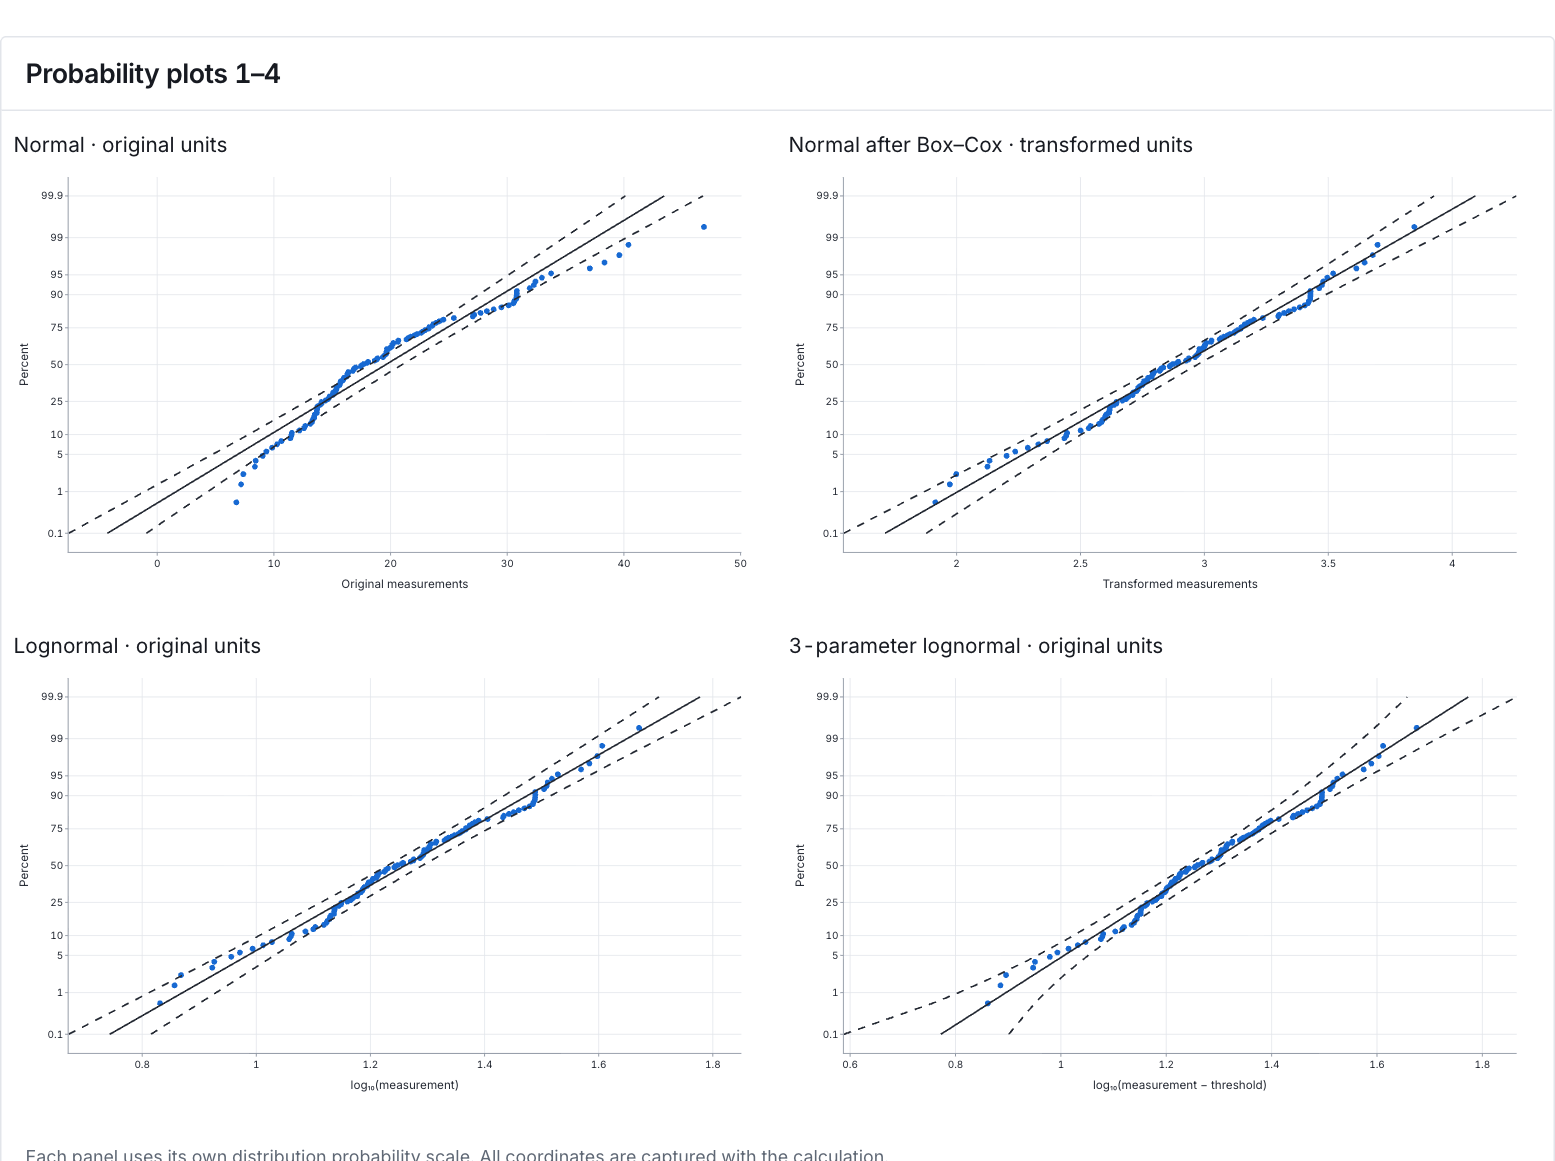
Comparar los cuatro primeros gráficos
Los paneles muestran la normal, la normal tras Box–Cox, la lognormal y la lognormal de 3 parámetros. Cada punto es una duración ordenada en la escala indicada por el panel. Busca un patrón aproximadamente recto e inspecciona las colas y los límites de confianza. Los otros 12 paneles están en Más detalles.
Gráficos de probabilidad 1–4 (en inglés) Ver gráfico a tamaño completo (se abre en una nueva pestaña) Leer la evidencia del ajuste
El ajuste normal tiene AD = 2.7369 y p < 0.005, lo que indica un ajuste normal deficiente. La lognormal tiene p = 0.1514; la loglogística y la distribución del valor extremo máximo tampoco se rechazan a 0.05. Varios modelos siguen siendo plausibles. Un valor p mayor por sí solo no elige el mejor modelo.
Distinguir los resultados no disponibles y las escalas
Las filas de la lognormal, gamma y loglogística de 3 parámetros no tienen valores p de AD disponibles; no disponible no significa que el contraste se haya superado. La fila de Weibull de 3 parámetros sí presenta p≈0.0183, con la validación de los casos límite de su método aún pendiente. Los ajustes de Box–Cox y Johnson utilizan unidades transformadas, no minutos.
Elegir un modelo para la decisión prevista
Compara el comportamiento de los modelos plausibles en las duraciones relevantes, especialmente en la cola de tiempos largos. Conserva las notas metodológicas y comprueba el desempeño predictivo antes de utilizar percentiles ajustados para una decisión sobre el tiempo de servicio.
Más detalles: leer cada sección de resultados
Las tablas de resultados completas utilizan seis cifras significativas, como en Help.
Contrastes de bondad de ajuste
La candidata identifica una distribución o un ajuste normal de datos transformados. AD mide la desviación en su escala de probabilidad; el valor p de AD puede ser un número, un límite de notificación o No disponible. Lee la nota de la celda. El estadístico de razón de verosimilitudes y el valor p de LRT comparan familias anidadas cuando procede; no son el contraste de bondad de ajuste de AD. No aplicable y No disponible no son resultados favorables del contraste. El valor p de AD de Weibull de 3 parámetros es numérico, aproximadamente 0.0183, con la validación de los casos límite pendiente; los valores de la lognormal, gamma y loglogística de 3 parámetros no están disponibles.
| Candidata | AD | Valor p de AD | Estadístico de razón de verosimilitudes | Valor p de LRT |
|---|---|---|---|---|
| Normal | 2.73688 | < 0.005Aproximación de Stephens para AD de normalidad; límite inferior de notificación 0.005 | — | No aplicable |
| Normal after Box–Cox | 0.552479 | 0.151353Aproximación de Stephens para AD de normalidad; límite inferior de notificación 0.005 | — | No aplicable |
| Lognormal | 0.552479 | 0.151353Aproximación de Stephens para AD de normalidad; límite inferior de notificación 0.005 | — | No aplicable |
| 3-parameter lognormal | 0.564131 | No disponibleNo se dispone de una probabilidad de AD para esta familia de tres parámetros. | 0.0222193 | 0.881505Chi-cuadrado, 1 grado de libertad; máximos de verosimilitud ajustados |
| Exponential | 22.216 | < 0.003Fórmulas de significación exponencial de la tabla 4.12 de Stephens, corrección 1+0.6/n; comprobaciones de la implementación nativa a ambos lados de 0.26, 0.51, 0.95 y 2.534 | — | No aplicable |
| 2-parameter exponential | 9.52934 | < 0.01Tabla 4.14 de Stephens, corrección 1+5.4/n-11/n²; interpolación lineal en la tabla | 99.8966 | 1.60565e-23Chi-cuadrado, 1 grado de libertad; verosimilitud ajustada de la exponencial desplazada |
| Weibull | 2.14725 | < 0.01Corrección de Stephens para valores extremos 1+0.2/sqrt(n); interpolación lineal en la tabla | — | No aplicable |
| 3-parameter Weibull | 0.952225 | 0.0183026Tabla 1 de Lockhart–Stephens, caso 7; interpolación en el inverso del parámetro de forma y en la probabilidad; validación de los casos límite de la implementación nativa pendiente | 14.422 | 0.000146086Chi-cuadrado, 1 grado de libertad; máximos de verosimilitud ajustados |
| Smallest extreme value | 6.55729 | < 0.01Corrección de Stephens para valores extremos 1+0.2/sqrt(n); interpolación lineal en la tabla | — | No aplicable |
| Largest extreme value | 0.581117 | 0.141662Corrección de Stephens para valores extremos 1+0.2/sqrt(n); interpolación lineal en la tabla | — | No aplicable |
| Gamma | 0.917041 | 0.0215001Tabla 4.21 de Stephens; primera fila para un parámetro de forma inferior a 1, interpolación lineal en el parámetro de forma y en la probabilidad, fila asintótica para un parámetro de forma superior a 20; validación más amplia de los casos límite pendiente | — | No aplicable |
| 3-parameter gamma | 0.664386 | No disponibleNo se dispone de una probabilidad de AD para esta familia de tres parámetros. | 2.03791 | 0.15342Chi-cuadrado, 1 grado de libertad; verosimilitud gamma modificada presentada |
| Logistic | 2.04259 | < 0.005Corrección logística de Stephens 1+0.25/n; interpolación lineal en la tabla | — | No aplicable |
| Loglogistic | 0.524443 | 0.141019Corrección logística de Stephens 1+0.25/n; interpolación lineal en la tabla | — | No aplicable |
| 3-parameter loglogistic | 0.471833 | No disponibleNo se dispone de una probabilidad de AD para esta familia de tres parámetros. | 0.268154 | 0.604573Chi-cuadrado, 1 grado de libertad; máximos de verosimilitud ajustados |
| Normal after Johnson | 0.395435 | 0.366495Aproximación de Stephens para AD de normalidad; límite inferior de notificación 0.005 | — | No aplicable |
- Las candidatas se muestran en el orden especificado, sin seleccionar una distribución ganadora.
- Los contrastes de razón de verosimilitudes comparan familias desplazadas con sus versiones sin desplazamiento. La exponencial desplazada utiliza sus estimaciones ajustadas; las demás familias utilizan sus máximos de verosimilitud ajustados.
Estadísticos descriptivos
Hay 120 observaciones, 0 celdas faltantes y 120 subgrupos no vacíos. La media, la mediana, el mínimo y el máximo describen duraciones en minutos; la desviación estándar describe su dispersión. El tamaño de subgrupo 1 mantiene las mediciones individuales.
Mediciones originales combinadas, sin promediar los subgrupos.
| Estadístico | Valor |
|---|---|
| Observaciones | 120 |
| Celdas con valores faltantes | 0 |
| Subgrupos no vacíos | 120 |
| Media | 19.597 |
| Desviación estándar | 7.72253 |
| Mínimo | 6.78 |
| Mediana | 17.605 |
| Máximo | 46.86 |
| Asimetría | 0.99684 |
| Exceso de curtosis | 0.907451 |
Resultados de las candidatas
El estado indica si cada candidata se calculó o no está disponible. La escala distingue los resultados originales de los transformados. La explicación conserva las salvedades sobre validación, convergencia y método. Se incluyen los 16 resultados; no omitas sin indicarlo un resultado no disponible.
| Candidata | Estado | Escala | Explicación |
|---|---|---|---|
| Normal | Calculado | original | Comprobado con el conjunto de datos de validación |
| Normal after Box–Cox | Calculado | transformada | Comprobado con el conjunto de datos de validación |
| Lognormal | Calculado | original | Comprobado con el conjunto de datos de validación |
| 3-parameter lognormal | Calculado | original | Los resultados pueden diferir de los de otros programas estadísticos porque varían los métodos de estimación del umbral y de convergencia. No se presentan estimaciones cuando el ajuste no converge. |
| Exponential | Calculado | original | Comprobado con el conjunto de datos de validación |
| 2-parameter exponential | Calculado | original | Comprobado con el conjunto de datos de validación |
| Weibull | Calculado | original | Comprobado con el conjunto de datos de validación |
| 3-parameter Weibull | Calculado | original | Los resultados pueden diferir de los de otros programas estadísticos porque varían los métodos de estimación del umbral y de convergencia. No se presentan estimaciones cuando el ajuste no converge. |
| Smallest extreme value | Calculado | original | Comprobado con el conjunto de datos de validación |
| Largest extreme value | Calculado | original | Comprobado con el conjunto de datos de validación |
| Gamma | Calculado | original | Comprobado con el conjunto de datos de validación |
| 3-parameter gamma | Calculado | original | Los resultados pueden diferir de los de otros programas estadísticos porque varían los métodos de estimación del umbral y de convergencia. No se presentan estimaciones cuando el ajuste no converge. |
| Logistic | Calculado | original | Comprobado con el conjunto de datos de validación |
| Loglogistic | Calculado | original | Comprobado con el conjunto de datos de validación |
| 3-parameter loglogistic | Calculado | original | Los resultados pueden diferir de los de otros programas estadísticos porque varían los métodos de estimación del umbral y de convergencia. No se presentan estimaciones cuando el ajuste no converge. |
| Normal after Johnson | Calculado | transformada | Comprobado con el conjunto de datos de validación |
Estimaciones de parámetros
Los parámetros corresponden a la convención matemática de cada candidata. La escala y la convención explican cómo interpretarlos; la localización y la escala de la lognormal se refieren a ln(X − umbral), aunque el modelo describa las duraciones originales. Los parámetros de los ajustes normales tras la transformación utilizan unidades transformadas. Conserva las salvedades sobre el umbral y la covarianza junto con las estimaciones.
| Candidata | Parámetros | Escala | Convención |
|---|---|---|---|
| Normal | location = 19.597; scale = 7.72253 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| Normal after Box–Cox | location = 2.90216; scale = 0.385417 | transformada | La escala y la forma siguen las convenciones de la referencia matemática. |
| Lognormal | location = 2.90216; scale = 0.385417 | original | La localización y la escala se refieren a ln(X − threshold). |
| 3-parameter lognormal | location = 2.93063; scale = 0.372998; threshold = -0.489666 | original | La localización y la escala se refieren a ln(X − threshold). |
| Exponential | scale = 19.597 | original | Inicialización mediante regresión del gráfico de probabilidad que pasa por el origen y estimaciones de Newton en escala logarítmica, con tolerancia relativa de parada de 1e−4 y tolerancia absoluta del paso de 1e−6; la estimación exacta de verosimilitud basada en la media muestral se conserva por separado. |
| 2-parameter exponential | scale = 12.9247; threshold = 6.67229 | original | Inicialización mediante regresión del gráfico de probabilidad, actualizaciones alternas de Newton en escala logarítmica y umbral = mínimo − escala/n; el criterio de parada conjunto de parámetros y verosimilitud se comprobó con el conjunto de datos de validación. La estimación de verosimilitud en la frontera del soporte se conserva por separado. |
| Weibull | shape = 2.6814; scale = 22.0651 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| 3-parameter Weibull | shape = 1.79811; scale = 14.9711; threshold = 6.28336 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| Smallest extreme value | location = 23.7574; scale = 9.20238 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| Largest extreme value | location = 16.1294; scale = 5.91185 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| Gamma | shape = 6.99122; scale = 2.80309 | original | Inicialización de Greenwood–Durand, criterio de parada relativo de Newton de 1e−4 y actualización final linealizada de la escala; las estimaciones exactas de verosimilitud se conservan por separado. |
| 3-parameter gamma | shape = 3.99933; scale = 3.82201; threshold = 4.31151 | original | Estimación gamma condicional finita seguida de umbral = mínimo − cuantil de la distribución gamma en 1/(n+1); convergencia conjunta de parámetros y verosimilitud. La forma y la escala se conservan del paso anterior de estimación del umbral. |
| Logistic | location = 18.7606; scale = 4.22543 | original | La escala y la forma siguen las convenciones de la referencia matemática. |
| Loglogistic | location = 2.89811; scale = 0.217969 | original | La localización y la escala se refieren a ln(X − threshold). |
| 3-parameter loglogistic | location = 2.7846; scale = 0.244789; threshold = 1.88031 | original | La localización y la escala se refieren a ln(X − threshold). |
| Normal after Johnson | location = 0.00290881; scale = 1.00489 | transformada | La escala y la forma siguen las convenciones de la referencia matemática. |
Detalles de las transformaciones
La transformación, la familia, los parámetros y la fórmula directa documentan las transformaciones ajustadas. Aquí Box–Cox utiliza ln(X); Johnson utiliza su fórmula SU indicada. En este ejemplo no se guarda ninguna de las dos columnas transformadas. Estas fórmulas cambian la escala de análisis, no las duraciones registradas.
| Transformación | Familia | Parámetros de la transformación | Fórmula directa |
|---|---|---|---|
| Normal after Box–Cox | Box–Cox | power = 0; optimal_power = 0.0480987 | ln(X) |
| Normal after Johnson | SU | gamma = -1.21067; eta = 1.31136; epsilon = 12.0096; lambda = 5.44783 | gamma + eta·asinh((X−epsilon)/lambda) |
- Los parámetros y percentiles normales tras la transformación se expresan en unidades transformadas.
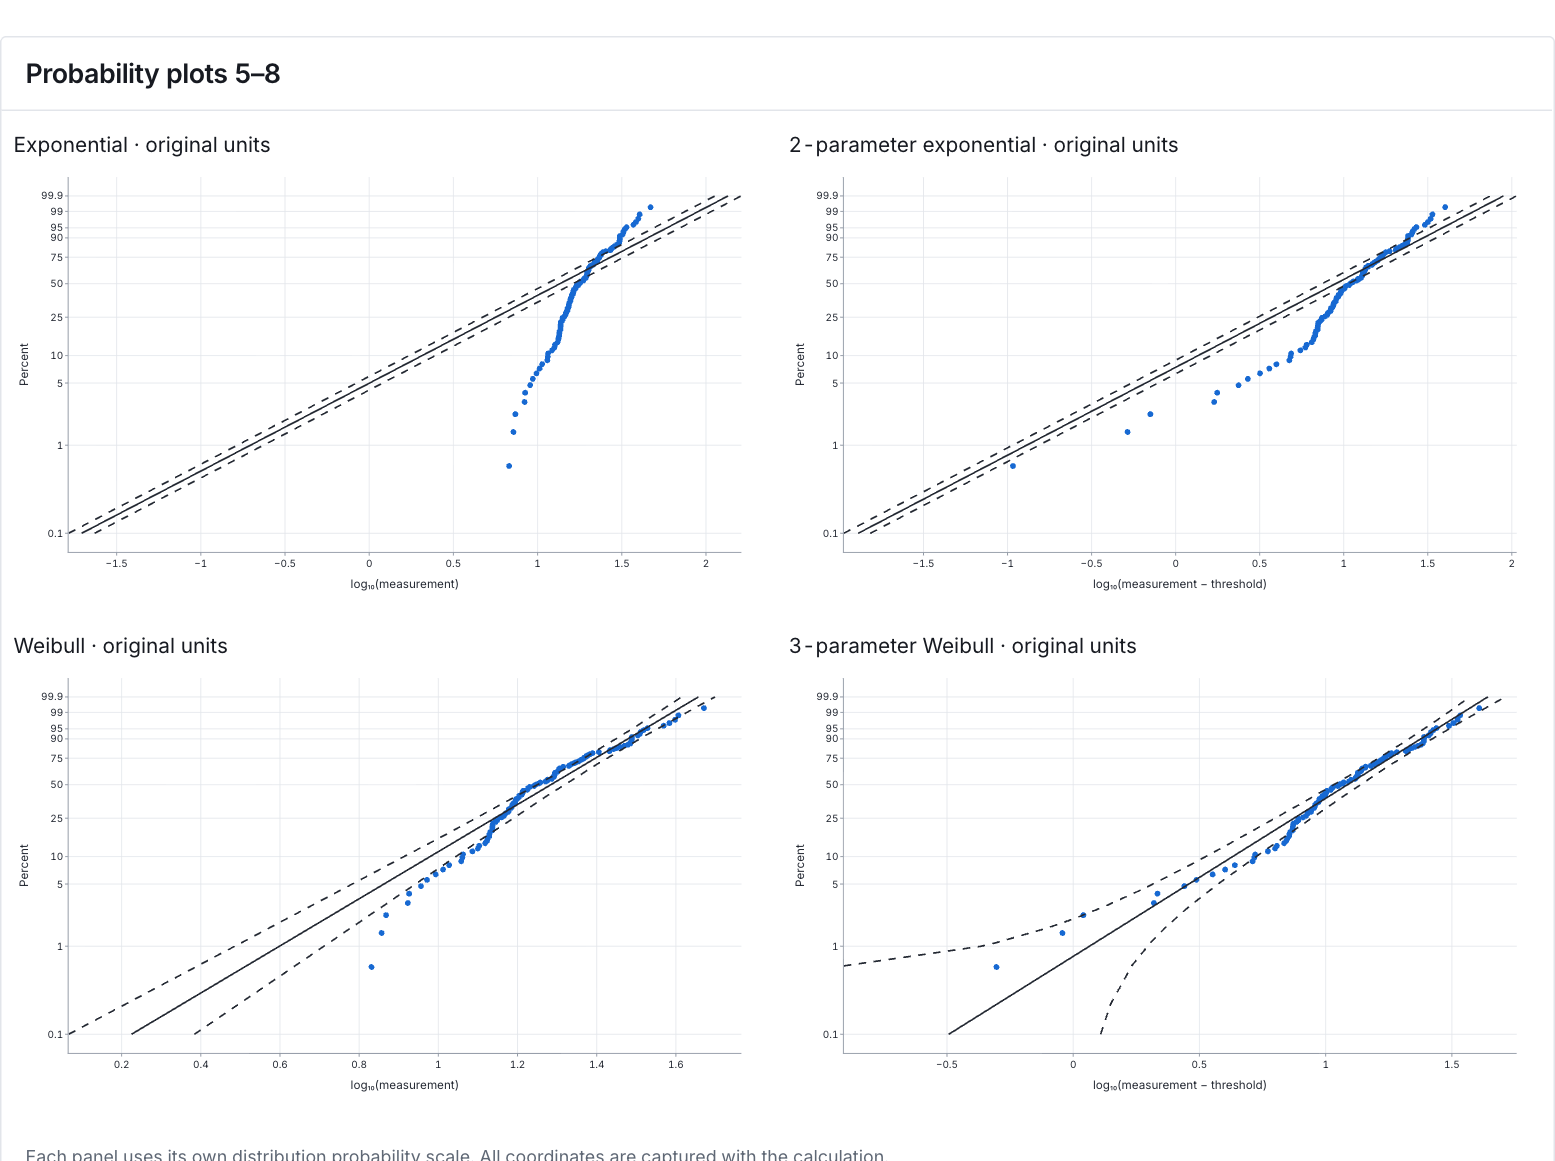
Gráficos de probabilidad 5–8
Compara los cuatro gráficos de probabilidad de las candidatas siguientes utilizando la escala propia de cada panel. La curvatura y las desviaciones en las colas indican dónde un modelo ajustado puede describir mal los tiempos de finalización; conserva las salvedades de cada panel.
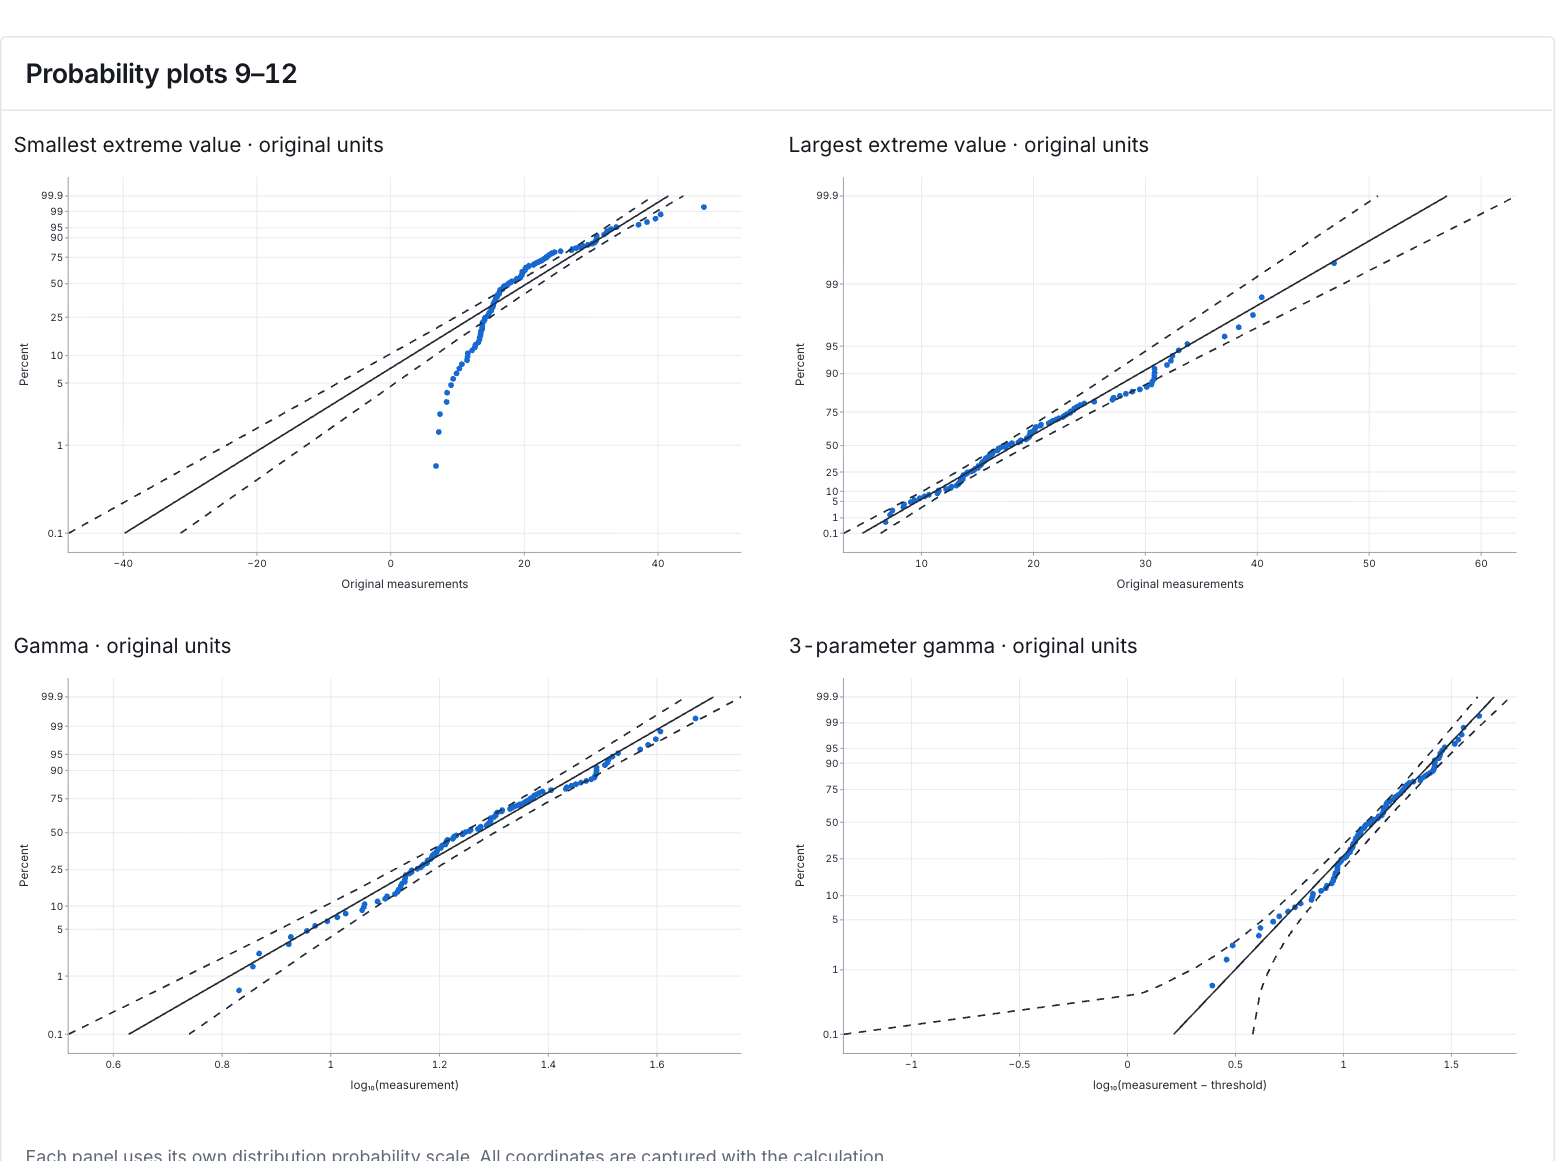
Gráficos de probabilidad 9–12
Estos gráficos de probabilidad amplían la comparación a las cuatro candidatas configuradas siguientes. Lee sus escalas individuales y las colas de tiempos largos en lugar de juzgar los modelos solo por su similitud visual.
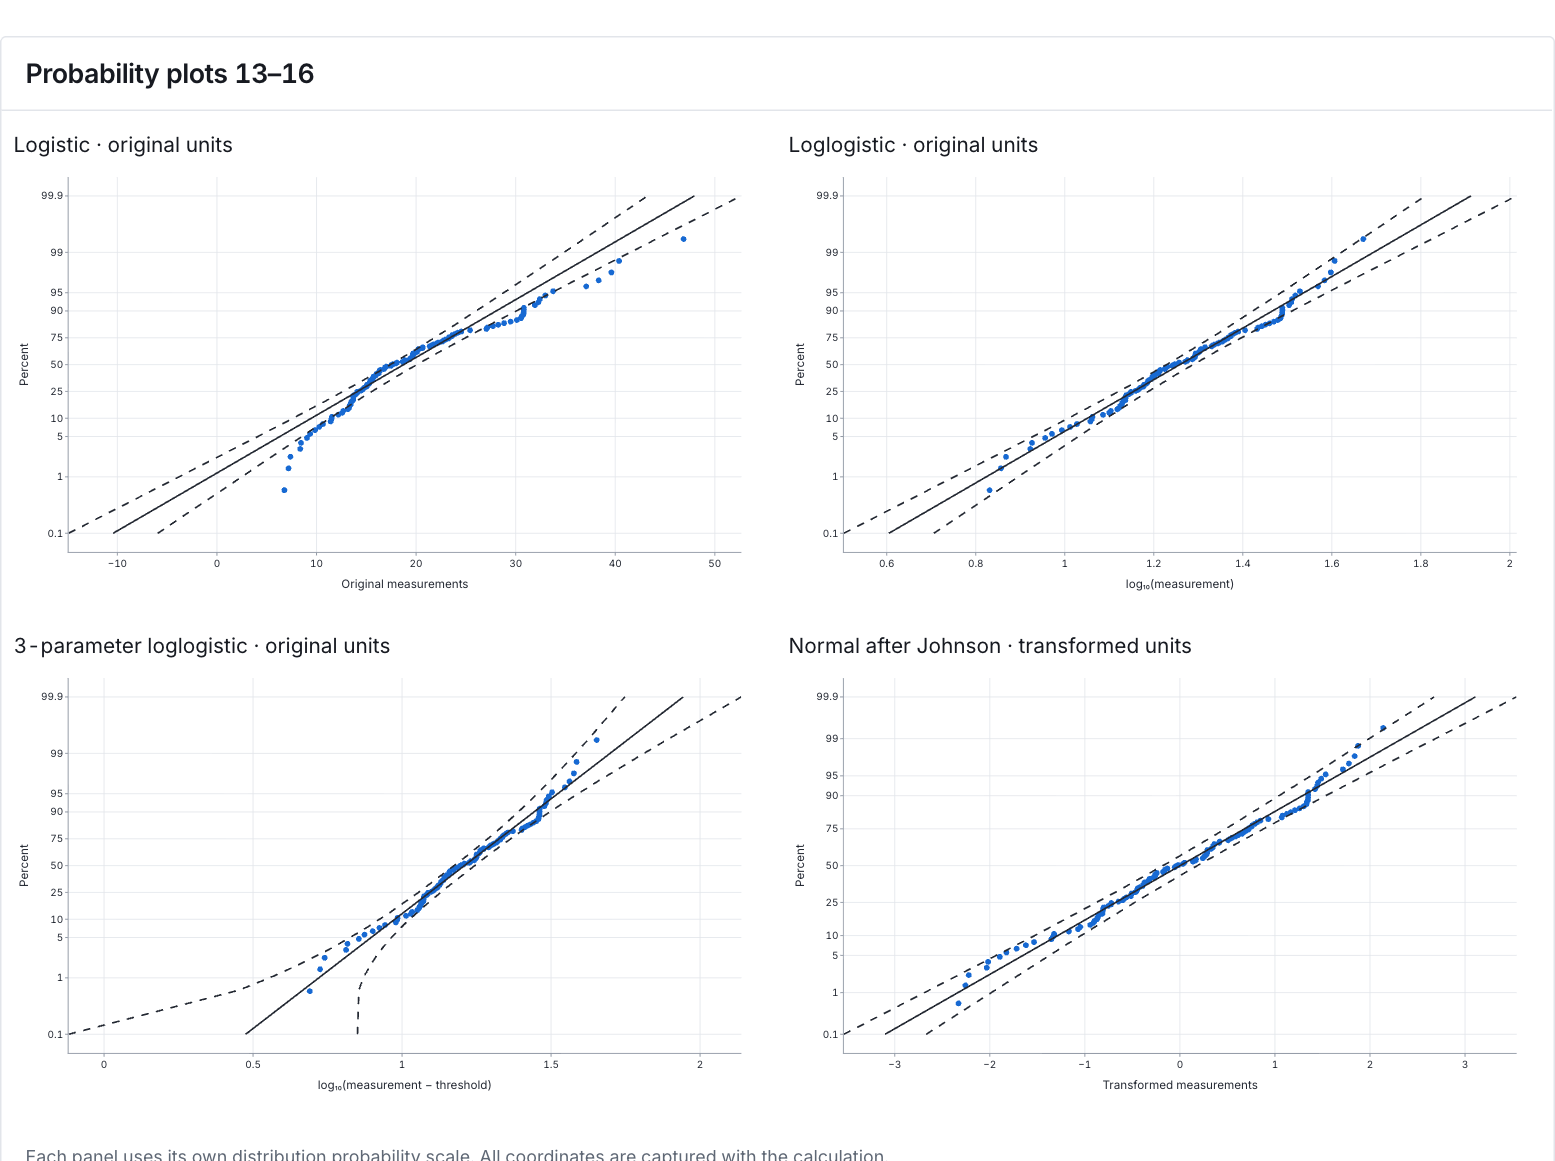
Gráficos de probabilidad 13–16
Lee los gráficos de probabilidad de las candidatas restantes, incluidos los ajustes normales tras una transformación, en las escalas indicadas. Un patrón de aspecto recto no identifica un único modelo verdadero ni elimina las limitaciones metodológicas.
Salvedad sobre Weibull de tres parámetros
El valor p de AD de Weibull guardado es 0.018302630915132106. El método registrado es la tabla 1 de Lockhart–Stephens, caso 7, con interpolación en el inverso del parámetro de forma y en la probabilidad; la validación de los casos límite de la implementación nativa está pendiente. Conserva esta salvedad al comentar la evidencia contra este ajuste. No es una probabilidad plenamente validada y sin salvedades.
8. Crear un informe
Conserva todos los resultados de Goodness-of-fit tests, Candidate outcomes, Parameter estimates, Transformation details y Descriptive statistics, junto con los cuatro gráficos de probabilidad agrupados. Conserva los límites de notificación, las probabilidades no disponibles y todas las salvedades metodológicas, incluidos los intervalos condicionales de la exponencial desplazada.
Selecciona Add to report de la ejecución completada. Abre Choose individual items and advanced options para seleccionar tablas y gráficos y, a continuación, selecciona Add to draft. Los elementos ocultos se conservan en el análisis guardado.
Asigna un nombre al informe y añade el objetivo del estudio y tu interpretación. Selecciona Save, revisa Preview, y después utiliza Export → Download HTML. El ejemplo siguiente contiene todo el contenido seleccionado, incluidos los resultados que no caben en una sola pantalla.