

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: zużycie energii elektrycznej w partiach suszenia
72 niezależne partie, ze zużyciem energii elektrycznej i trzema liczbowymi zmiennymi objaśniającymi.
Pobierz przykładowe dane (CSV, angielskie nagłówki)To ten sam przykład, który znajduje się w Help. Zaimportuj CSV, aby wykonać kolejne kroki, lub użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Linear Regression. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Zaimportuj przykładowe dane
Pobierz powyższy plik CSV i zaimportuj go do arkusza. Wybierz Comma jako separator pól, Dot jako separator dziesiętny oraz First row contains column names.
3. Przypisz kolumny wejściowe
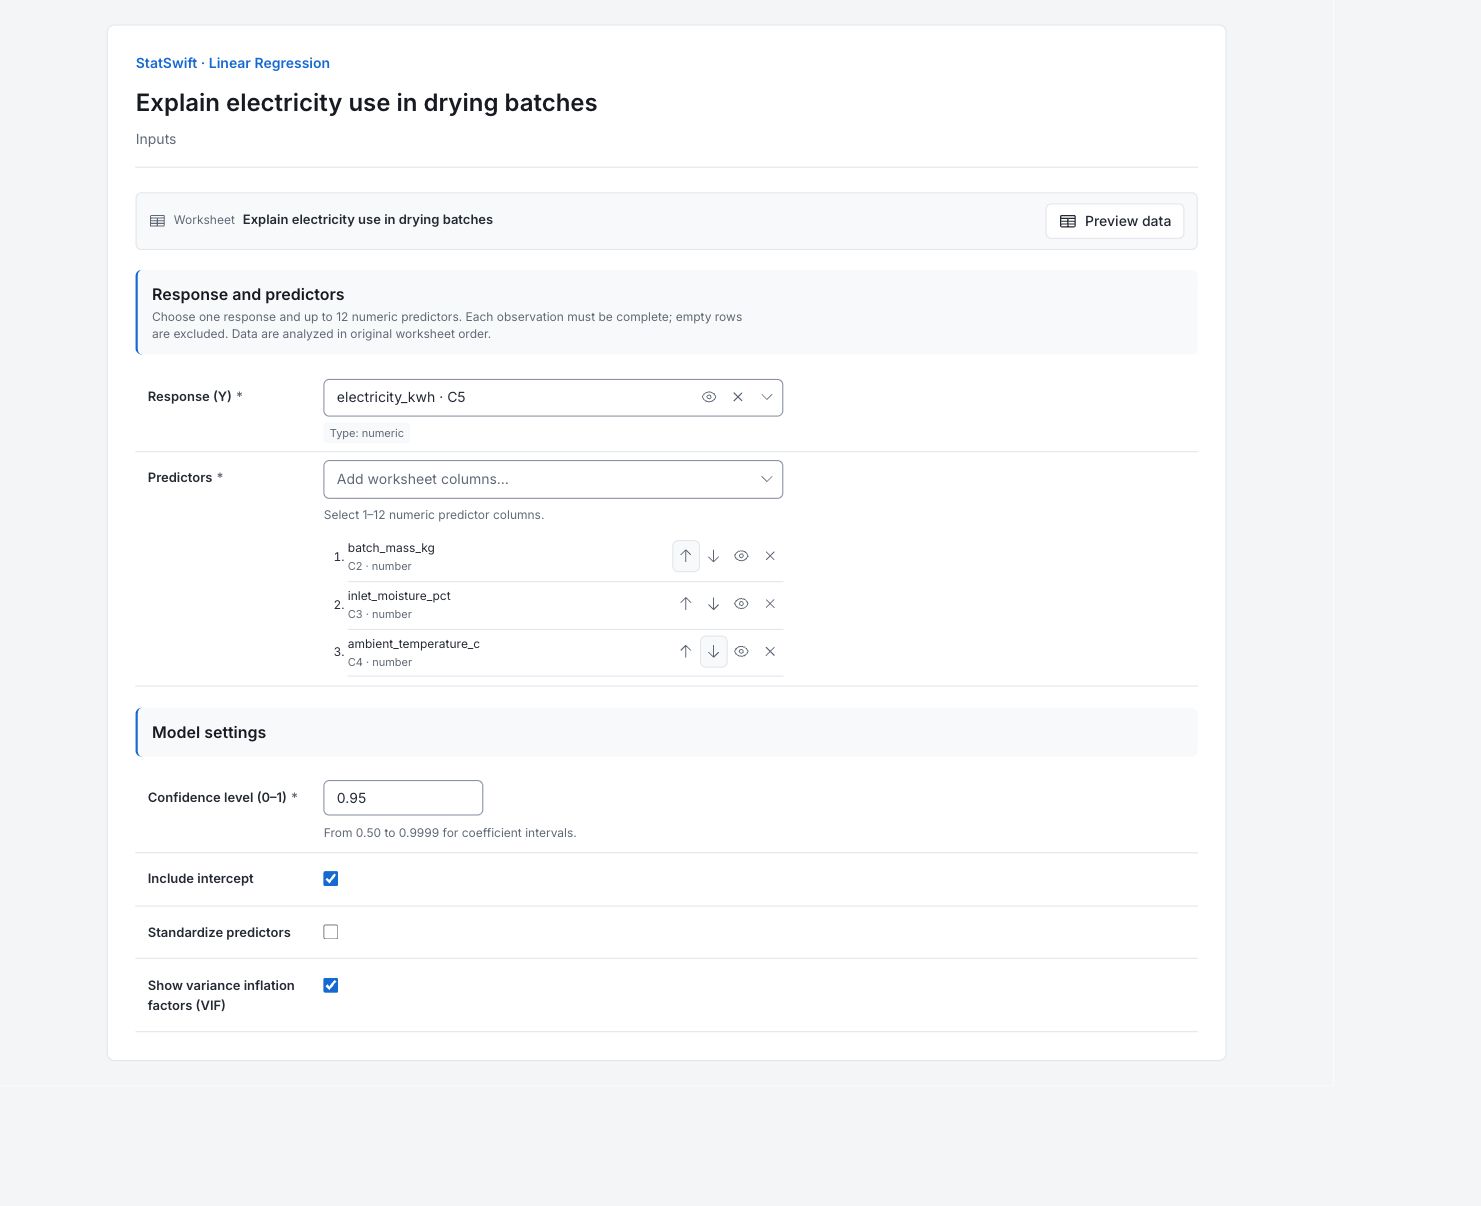
Na karcie Inputs przypisz electricity_kwh do Response (Y). Otwórz Predictors i wybierz kolejno batch_mass_kg, inlet_moisture_pct i ambient_temperature_c. Wyniki oznaczają je odpowiednio X1, X2 i X3.
4. Ustaw model
Wpisz 0.95 w Confidence level (0–1). Zaznacz Include intercept i Show variance inflation factors (VIF). Pozostaw Standardize predictors niezaznaczone, aby zachować wprowadzone jednostki.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Określ modelowaną odpowiedź
Model wykorzystuje 72 niezależne partie do opisu zużycia energii na podstawie masy, wilgotności wejściowej i temperatury otoczenia. R² wynosi około 0.8938. Opisuje to dopasowanie do tych partii; zarejestrowane związki nie dowodzą przyczynowości.
Odczytaj współczynnik w jego jednostkach
Przy stałych pozostałych predyktorach dodatkowe 10 kg wiąże się ze wzrostem zużycia o około 3.42 kWh. Wilgotność dodaje około 2.65 kWh na punkt procentowy, a temperatura około −0.753 kWh na °C. Wszystkie trzy przedziały współczynników 95% wykluczają zero. Wyraz wolny dla wszystkich zerowych predyktorów leży poza warunkami badania.
Odczytaj wykres reszt
Reszta to zmierzone zużycie energii minus dopasowane, w kWh. Obserwacja 49 jest około 11.09 kWh poniżej dopasowania i ma największą resztę bezwzględną. Sprawdź jej dokumentację i obejrzyj całą chmurę pod kątem krzywizny lub zmiany rozrzutu. Sam ten punkt nie świadczy o błędzie.

Reszty względem wartości dopasowanych Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Sprawdź ogony reszt
Wykres QQ porównuje uporządkowane reszty z normalnymi pozycjami odniesienia. Szukaj systematycznych krzywizn i nietypowych ogonów. Test Shapiro–Wilka reszt ma p = 0.4018 i nie odrzuca normalności przy 0.05; żaden wynik nie dowodzi modelu błędu. Dotyczy to reszt, a nie surowych wartości zużycia energii.

Wykres QQ reszt Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Sprawdź zastosowanie do nowych partii
VIF około 1.003–1.045 wskazuje niewielkie zawyżenie z powodu zależności liniowej między predyktorami; nie potwierdza prawidłowej postaci modelu. Ogranicz przewidywania do porównywalnych warunków: obserwowana masa 80.1–217.1 kg, wilgotność 6.05–13.57% i temperatura 15.2–27.9°C. Pozostanie w tych oddzielnych zakresach nie wystarcza, jeśli nowa kombinacja różni się od badanych. Zweryfikuj przewidywania na nowych partiach przed użyciem ich w planowaniu.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Dopasowanie regresji liniowej
R² opisuje dopasowaną zmienność; skorygowane R² uwzględnia liczbę predyktorów, a surowe skorygowane R² zachowuje wartość sprzed podanej konwencji wyświetlania. F modelu i wartość p testują predyktory łącznie. Stopnie swobody modelu i reszt określają dostępną informację. Pozostałe ustawienia dokumentują ufność, wyraz wolny i skalowanie. Są to wyniki dopasowania do badania, a nie jakość przewidywania na odłożonych danych.
| Statystyka | Wartość |
|---|---|
| R² | 0.893774 |
| Skorygowane R² | 0.889088 |
| Surowe skorygowane R² | 0.889088 |
| Konwencja skorygowanego R² | Wartości ujemne raportowane jako zero (zbiór walidacyjny) |
| F modelu | 190.715 |
| Wartość p modelu | 4.9105e-33 |
| Stopnie swobody modelu | 3 |
| Stopnie swobody reszt | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| Obserwacje | 72 |
| Zachowane predyktory | 3 |
| Parametry | 4 |
| Wiersze wejściowe | 72 |
| Wykorzystane wiersze | 72 |
| Pominięte wiersze | 0 |
| Wiersze dopasowania | 72 |
| Predyktory | X1, X2, X3 |
- Model jest statystycznie istotny. Istotne predyktory: X1, X2, X3
Współczynniki regresji
X1 to masa partii, X2 wilgotność wejściowa, a X3 temperatura otoczenia. β to oszacowany współczynnik w jednostkach odpowiedzi na jednostkę predyktora. SE to niepewność współczynnika; t i wartość p testują zerowy współczynnik; dolna i górna granica CI wyznaczają jego przedział 95%. Każde nachylenie utrzymuje pozostałe predyktory na stałym poziomie. Wyraz wolny zakłada zerowe wartości wszystkich predyktorów.
| Składnik | β | SE | t | Wartość p | Dolna granica CI | Górna granica CI |
|---|---|---|---|---|---|---|
| Wyraz wolny | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
Współczynniki inflacji wariancji
Etykiety predyktorów odpowiadają wybranej kolejności. VIF mierzy zawyżenie wariancji współczynnika wskutek zależności liniowej z innymi predyktorami. Wartości bliskie 1 sugerują niewielkie zawyżenie; nie potwierdzają liniowości, niezależności ani przyszłych przewidywań.
| Predyktor | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
ANOVA regresji
Model to zmienność dopasowana przez predyktory; reszty to zmienność niewyjaśniona. SS oznacza sumę kwadratów, DF stopnie swobody, a MS to SS podzielone przez DF. F porównuje średnie kwadraty modelu i reszt; wartość p testuje predyktory łącznie. Kreski oznaczają pozycje niedotyczące.
| Źródło | SS | DF | MS | F | Wartość p |
|---|---|---|---|---|---|
| Model | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| Reszta | 1667.76 | 68 | 24.5259 | — | — |
Podsumowanie reszt
Reszta to zaobserwowane minus dopasowane zużycie energii w kWh. Średnia, SD, minimum, kwartyle, mediana i maksimum podsumowują 72 reszty z badania. Te podsumowania nie są przedziałami predykcji dla nowej partii.
| Statystyka | Wartość |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| Mediana | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
Normalność reszt
Test sw oznacza test Shapiro–Wilka reszt modelu. Statystyka i wartość p oceniają roboczy model normalnych błędów. Odczytuj je wraz z wykresem QQ; p powyżej 0.05 nie dowodzi normalnych błędów.
| Statystyka | Wartość |
|---|---|
| Test | sw |
| Statystyka | 0.982202 |
| wartość p | 0.401846 |
Wartości dopasowane i reszty
Indeks wskazuje analizowaną partię w kolejności źródłowej. Wartość dopasowana to modelowe zużycie energii w kWh; reszta to zmierzone minus dopasowane kWh. Uwzględniono wszystkie 72 wiersze. Dodatnia wartość oznacza zużycie powyżej dopasowania, a ujemna poniżej. Dopasowania wykorzystują pomiary z tego samego badania.
| Indeks | Wartość dopasowana | Reszta |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7. Utwórz raport
Zachowaj Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, oba wykresy reszt, podsumowania i test normalności reszt oraz każdy wiersz Fitted values and residuals. Zapisz kolejność i jednostki predyktorów; opisuj zależności i oddzielnie sprawdź przyszłą jakość przewidywania. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.