

Názvy příkazů aplikace, identifikátory datových listů a hodnoty ukázkových dat zůstávají v původní podobě. Snímky obrazovky, grafy a soubory ke stažení jsou v angličtině. Vědecké příklady zachovávají anglické číselné konvence: desetinnou tečku a čárku oddělující tisíce.
Příklad: spotřeba elektřiny v sušicích dávkách
72 nezávislých dávek se spotřebou elektřiny a třemi číselnými vysvětlujícími proměnnými.
Stáhnout ukázková data (CSV v angličtině)Jde o stejný příklad jako v Help. Importujte CSV a postupujte podle kroků nebo v Help použijte Open example in a practice copy k předvyplnění vstupů.
1. Vytvořte pracovní prostředí
Na postranním panelu otevřete Basic Statistics a vyberte Linear Regression. Vytvořte analýzu, pojmenujte ji, vyberte New blank worksheet a poté Create analysis.
2. Importujte ukázková data
Stáhněte výše uvedený CSV a importujte jej do datového listu. Jako oddělovač vyberte Comma, jako desetinný oddělovač Dot a zvolte First row contains column names.
3. Přiřaďte vstupní sloupce
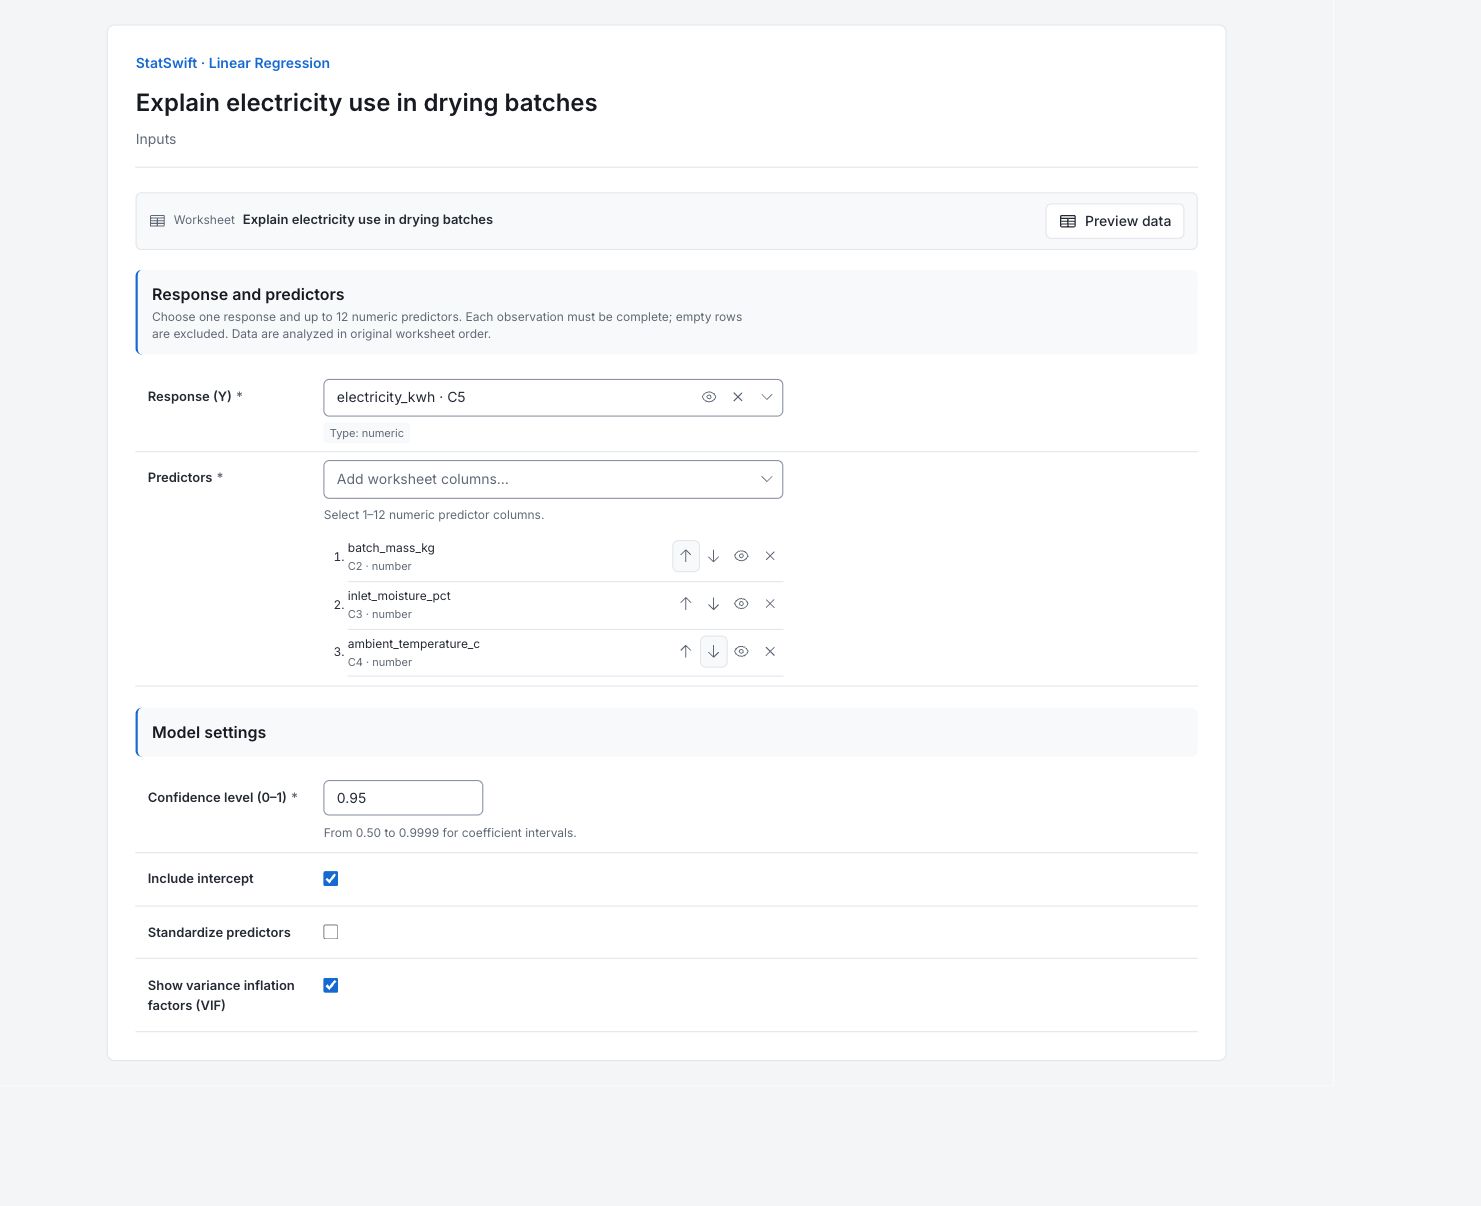
Na kartě Inputs přiřaďte electricity_kwh k Response (Y). Otevřete Predictors a v tomto pořadí vyberte batch_mass_kg, inlet_moisture_pct a ambient_temperature_c. Výsledky je označují jako X1, X2 a X3 v tomto pořadí.
4. Nastavte model
Do Confidence level (0–1) zadejte 0.95. Zaškrtněte Include intercept a Show variance inflation factors (VIF). Ponechte Standardize predictors nezaškrtnuté, aby se zachovaly zadané jednotky.
5. Spusťte analýzu
Vyberte Run analysis a poté otevřete Results.
6. Interpretovat výsledky
Určete modelovanou odezvu
Model používá 72 nezávislých dávek k popisu spotřeby elektřiny podle hmotnosti, vstupní vlhkosti a okolní teploty. R² je přibližně 0.8938. Popisuje shodu s těmito dávkami; zaznamenané vztahy neprokazují příčiny.
Přečtěte si koeficient v jeho jednotkách
Při nezměněných ostatních prediktorech je dalších 10 kg spojeno s přibližně o 3.42 kWh vyšší spotřebou. Pro vlhkost je odpovídající změna přibližně 2.65 kWh na procentní bod a pro teplotu přibližně −0.753 kWh na °C. Všechny tři 95% intervaly koeficientů vylučují nulu. Konstanta pro všechny nulové prediktory leží mimo podmínky studie.
Přečtěte si graf reziduí
Reziduum je naměřená spotřeba elektřiny minus proložená spotřeba v kWh. Pozorování 49 je přibližně 11.09 kWh pod proloženou hodnotou a má největší absolutní reziduum. Zkontrolujte jeho záznamy a v celém mraku bodů hledejte zakřivení nebo měnící se rozptýlení. Samotný bod nepovažujte za důkaz chyby.

Rezidua vůči proloženým hodnotám Zobrazit graf v plné velikosti (otevře se na nové kartě) Zkontrolujte chvosty reziduí
QQ graf porovnává uspořádaná rezidua s normálními referenčními pozicemi. Hledejte systematické zakřivení a neobvyklé chvosty. Shapirův–Wilkův test reziduí má p = 0.4018 a na hladině 0.05 normalitu nezamítá; ani jeden výsledek neprokazuje model chyb. Týká se reziduí, nikoli původních hodnot spotřeby elektřiny.

QQ graf reziduí Zobrazit graf v plné velikosti (otevře se na nové kartě) Ověřte použití pro nové dávky
VIF přibližně 1.003–1.045 ukazují malé zvětšení rozptylu způsobené lineární závislostí prediktorů; neprokazují správný tvar modelu. Predikce omezte na srovnatelné podmínky: pozorovaná hmotnost 80.1–217.1 kg, vlhkost 6.05–13.57% a teplota 15.2–27.9°C. Setrvání v těchto jednotlivých rozsazích nestačí, pokud se nová kombinace liší od studovaných. Než podle predikcí začnete plánovat, validujte je na nových dávkách.
Další podrobnosti: přečtěte si každou sekci výsledků
Úplné tabulky výsledků používají šest platných číslic, stejně jako Help.
Proložení lineární regrese
R² popisuje variabilitu zachycenou modelem; upravené R² zohledňuje počet prediktorů a upravené R² před úpravou zobrazení zachovává hodnotu před uvedenou konvencí zobrazení. F modelu a p-hodnota testují prediktory společně. Stupně volnosti modelu a reziduí zaznamenávají dostupné informace. Zbývající nastavení proložení dokumentují spolehlivost, konstantu a přeškálování. Jde o výsledky proložení studie, nikoli predikční výkonnost na vyčleněných datech.
| Statistika | Hodnota |
|---|---|
| R² | 0.893774 |
| Upravené R² | 0.889088 |
| Upravené R² před úpravou zobrazení | 0.889088 |
| Konvence upraveného R² | Záporné hodnoty uváděny jako nula (validační datový soubor) |
| F modelu | 190.715 |
| p-hodnota modelu | 4.9105e-33 |
| Stupně volnosti modelu | 3 |
| Stupně volnosti reziduí | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| Pozorování | 72 |
| Zachované prediktory | 3 |
| Parametry | 4 |
| Vstupní řádky | 72 |
| Použité řádky | 72 |
| Vynechané řádky | 0 |
| Řádky použité při proložení | 72 |
| Prediktory | X1, X2, X3 |
- Model je statisticky významný. Významné prediktory: X1, X2, X3
Regresní koeficienty
X1 je hmotnost dávky, X2 vstupní vlhkost a X3 okolní teplota. β je odhadnutý koeficient v jednotkách odezvy na jednotku prediktoru. SE je nejistota koeficientu; t a p-hodnota testují nulový koeficient; dolní a horní mez intervalu spolehlivosti ohraničují jeho 95% interval. Každá směrnice platí při nezměněných ostatních prediktorech. Konstanta předpokládá, že všechny prediktory jsou nulové.
| Člen | β | SE | t | p-hodnota | Dolní mez intervalu spolehlivosti | Horní mez intervalu spolehlivosti |
|---|---|---|---|---|---|---|
| Konstanta | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
Inflační faktory rozptylu
Popisky prediktorů odpovídají vybranému pořadí. VIF měří zvětšení rozptylu odhadu koeficientu kvůli lineární závislosti s ostatními prediktory. Hodnoty blízko 1 naznačují malé zvětšení; nevalidují linearitu, nezávislost ani budoucí predikce.
| Prediktor | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
Regresní ANOVA
Model je variabilita zachycená prediktory; Reziduum je nevysvětlená variabilita. SS je součet čtverců, DF stupně volnosti a MS je SS dělený DF. F porovnává střední čtverce modelu a reziduí; p-hodnota testuje prediktory společně. Pomlčky označují nepoužitelné položky.
| Zdroj variability | SS | DF | MS | F | p-hodnota |
|---|---|---|---|---|---|
| Model | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| Reziduum | 1667.76 | 68 | 24.5259 | — | — |
Souhrn reziduí
Reziduum je pozorovaná minus proložená spotřeba elektřiny v kWh. Průměr, směrodatná odchylka, minimum, kvartily, medián a maximum shrnují 72 reziduí studie. Tyto souhrny nejsou predikčními intervaly pro novou dávku.
| Statistika | Hodnota |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| medián | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
Normalita reziduí
Test sw označuje Shapirův–Wilkův test reziduí modelu. Statistika a p-hodnota posuzují předpokládaný normální model chyb. Čtěte je společně s QQ grafem; p nad 0.05 neprokazuje normální chyby.
| Statistika | Hodnota |
|---|---|
| Test | sw |
| Statistika | 0.982202 |
| p-hodnota | 0.401846 |
Proložené hodnoty a rezidua
Index určuje analyzovanou dávku v původním pořadí. Proložená hodnota je modelová spotřeba elektřiny v kWh; Reziduum je naměřená minus proložená spotřeba v kWh. Zahrnuto je všech 72 řádků. Kladné znamená, že spotřeba překročila proloženou hodnotu, záporné že byla nižší. Tato proložení používají vlastní měření studie.
| Index | Proložená hodnota | Reziduum |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7. Vytvořit zprávu
Zachovejte Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, oba grafy reziduí, souhrny reziduí a test jejich normality a každý řádek Fitted values and residuals. Zaznamenejte pořadí prediktorů a jednotky; popisujte souvislosti a budoucí predikční výkonnost ověřujte samostatně.
Vyberte Add to report z dokončeného výpočtu. Otevřete Choose individual items and advanced options pro výběr tabulek a grafů a poté vyberte Add to draft. Skryté položky zůstávají v uložené analýze.
Pojmenujte zprávu a doplňte účel studie a svou interpretaci. Vyberte Save, zkontrolujte Preview, poté použijte Export → Download HTML. Příklad níže obsahuje veškerý vybraný obsah včetně výsledků přesahujících jednu obrazovku.