

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : consommation d’électricité des lots de séchage
72 lots indépendants, avec consommation d’électricité et trois variables explicatives numériques.
Télécharger les données d’exemple (CSV en anglais)C’est le même exemple que dans Help. Importez le CSV pour suivre les étapes ou utilisez Open example in a practice copy dans Help pour préremplir les données d’entrée.
1. Créer l’espace de travail
Dans la barre latérale, ouvrez Basic Statistics et choisissez Linear Regression. Créez une analyse, nommez-la, sélectionnez New blank worksheet, puis choisissez Create analysis.
2. Importer les données d’exemple
Téléchargez le CSV ci-dessus et importez-le dans la feuille de données. Choisissez Comma comme délimiteur, Dot comme séparateur décimal et First row contains column names.
3. Affecter les colonnes d’entrée
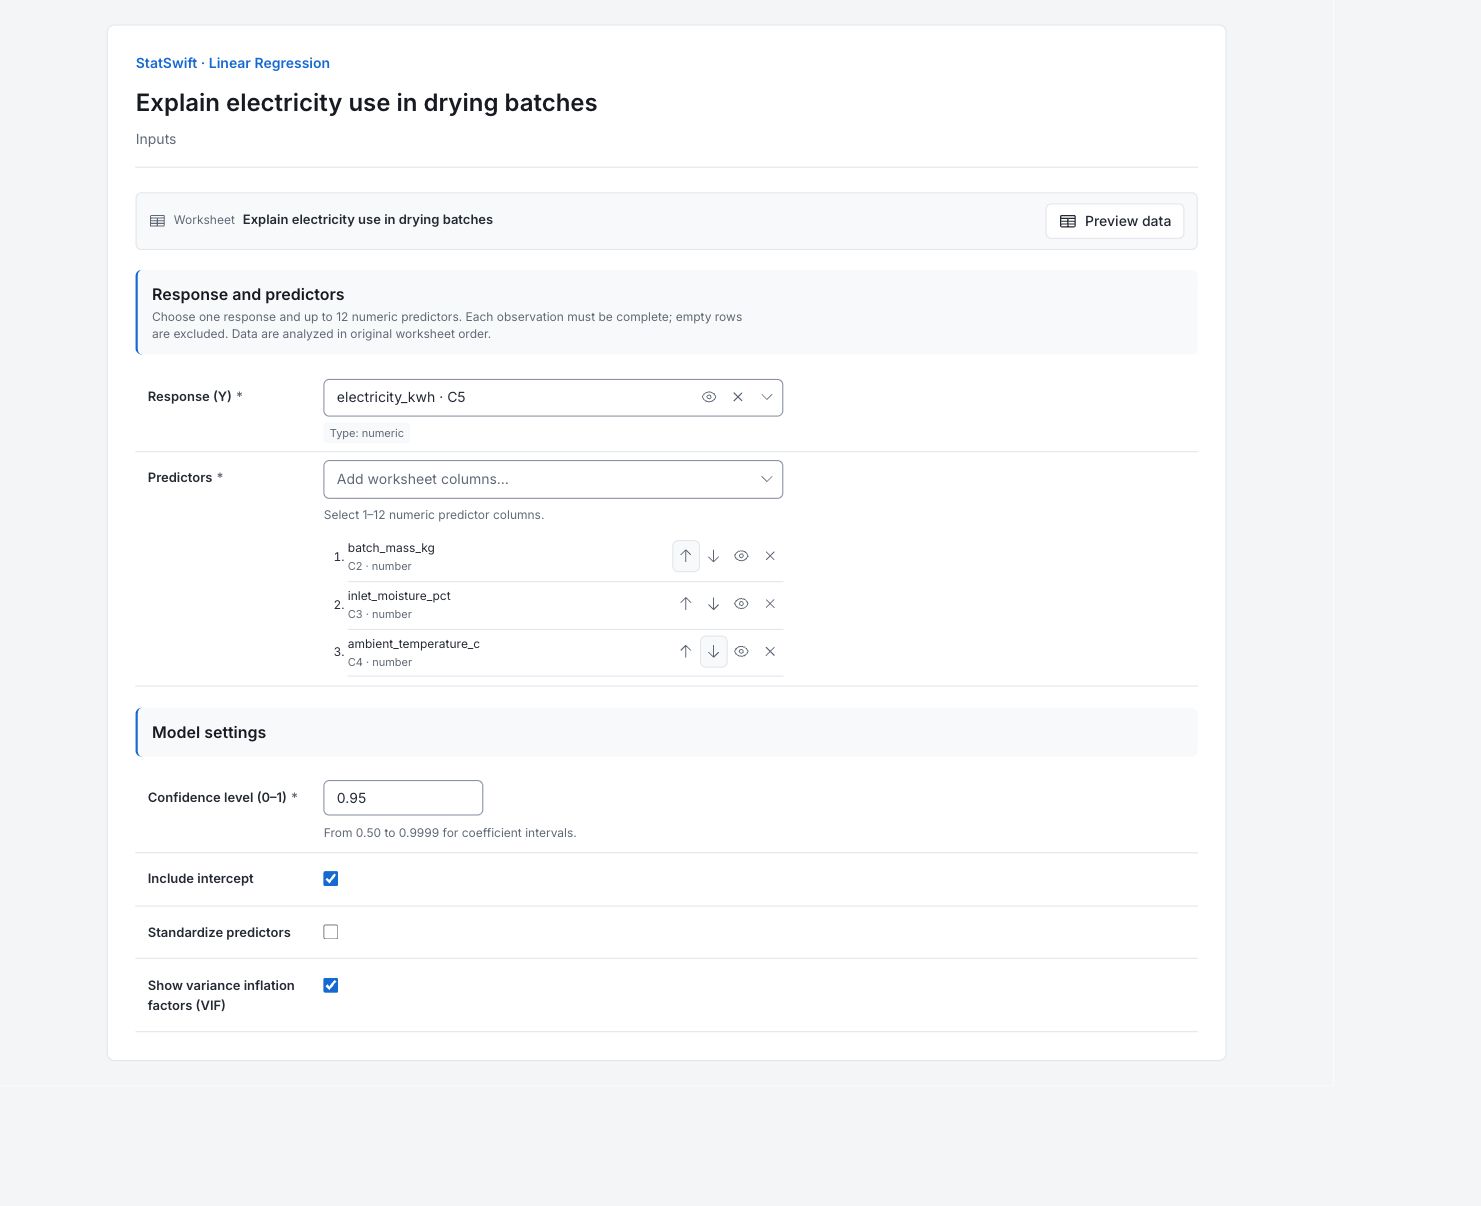
Dans Inputs, affectez electricity_kwh à Response (Y). Ouvrez Predictors et sélectionnez batch_mass_kg, inlet_moisture_pct et ambient_temperature_c, dans cet ordre. Les résultats les désignent respectivement par X1, X2 et X3.
4. Définir le modèle
Saisissez 0.95 dans Confidence level (0–1). Cochez Include intercept et Show variance inflation factors (VIF). Laissez Standardize predictors décoché pour conserver les unités saisies.
5. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
6. Interpréter les résultats
Identifier la réponse ajustée
Le modèle utilise 72 lots indépendants pour décrire la consommation d’électricité à partir de la masse, de l’humidité d’entrée et de la température ambiante. R² vaut environ 0.8938. Cela décrit l’ajustement à ces lots ; les relations enregistrées n’établissent pas de causes.
Lire un coefficient dans ses unités
Les autres prédicteurs étant maintenus fixes, 10 kg supplémentaires sont associés à environ 3.42 kWh de consommation en plus. L’humidité ajoute environ 2.65 kWh par point de pourcentage et la température environ −0.753 kWh par °C. Les trois intervalles de coefficients à 95% excluent zéro. L’ordonnée à l’origine, pour tous les prédicteurs nuls, correspond à des conditions hors de l’étude.
Lire le graphique des résidus
Un résidu est la consommation mesurée moins la consommation ajustée, en kWh. L’observation 49 est environ 11.09 kWh sous sa valeur ajustée, le plus grand résidu en valeur absolue. Vérifiez ses relevés et examinez tout le nuage pour repérer courbures ou changements de dispersion. Ne supposez pas une erreur sur la seule base de ce point.

Résidus en fonction des valeurs ajustées Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Vérifier les queues des résidus
Le graphique QQ compare les résidus ordonnés à des positions de référence normales. Recherchez des courbures systématiques et des queues inhabituelles. Le test de Shapiro–Wilk des résidus donne p = 0.4018 et ne rejette pas la normalité à 0.05 ; aucun de ces résultats ne prouve le modèle d’erreur. Cela concerne les résidus, et non les consommations brutes d’électricité.

Graphique QQ des résidus Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Vérifier l’utilisation sur de nouveaux lots
Les VIF d’environ 1.003–1.045 montrent peu d’inflation due à la dépendance linéaire entre prédicteurs ; ils n’établissent pas la bonne forme du modèle. Limitez les prédictions à des conditions comparables : masse observée 80.1–217.1 kg, humidité 6.05–13.57% et température 15.2–27.9°C. Rester dans ces intervalles séparés ne suffit pas si une nouvelle combinaison diffère de celles étudiées. Validez les prédictions sur de nouveaux lots avant de les utiliser pour planifier.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Ajustement de régression linéaire
R² décrit la variation ajustée ; le R² ajusté tient compte du nombre de prédicteurs et le R² ajusté brut conserve la valeur avant la convention d’affichage indiquée. F du modèle et la valeur p testent les prédicteurs ensemble. Les degrés de liberté du modèle et des résidus enregistrent l’information disponible. Les autres réglages documentent la confiance, l’ordonnée à l’origine et la mise à l’échelle. Ce sont des résultats d’ajustement sur l’étude, et non une performance prédictive sur des données réservées.
| Statistique | Valeur |
|---|---|
| R² | 0.893774 |
| R² ajusté | 0.889088 |
| R² ajusté brut | 0.889088 |
| Convention du R² ajusté | Valeurs négatives rapportées comme nulles (jeu de données de validation) |
| F du modèle | 190.715 |
| Valeur p du modèle | 4.9105e-33 |
| Degrés de liberté du modèle | 3 |
| Degrés de liberté résiduels | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| Observations | 72 |
| Prédicteurs retenus | 3 |
| Paramètres | 4 |
| Lignes d’entrée | 72 |
| Lignes utilisées | 72 |
| Lignes exclues | 0 |
| Lignes ajustées | 72 |
| Prédicteurs | X1, X2, X3 |
- Le modèle est statistiquement significatif. Prédicteurs significatifs : X1, X2, X3
Coefficients de régression
X1 est la masse du lot, X2 l’humidité d’entrée et X3 la température ambiante. β est le coefficient estimé dans les unités de réponse par unité du prédicteur. SE est l’incertitude du coefficient ; t et la valeur p testent un coefficient nul ; les bornes de l’IC délimitent son intervalle à 95%. Chaque pente maintient les autres prédicteurs fixes. L’ordonnée à l’origine suppose tous les prédicteurs nuls.
| Terme | β | SE | t | Valeur p | Borne inférieure de l’IC | Borne supérieure de l’IC |
|---|---|---|---|---|---|---|
| Ordonnée à l’origine | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
Facteurs d’inflation de la variance
Les libellés des prédicteurs suivent l’ordre sélectionné. Le VIF mesure l’inflation de la variance du coefficient due à la dépendance linéaire avec les autres prédicteurs. Des valeurs proches de 1 suggèrent peu d’inflation ; elles ne valident ni la linéarité, ni l’indépendance, ni les prédictions futures.
| Prédicteur | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
ANOVA de régression
Le modèle est la variation ajustée par les prédicteurs ; le résidu est la variation inexpliquée. SS désigne la somme des carrés, DF les degrés de liberté et MS le rapport SS/DF. F compare les carrés moyens du modèle et des résidus ; la valeur p teste les prédicteurs ensemble. Les tirets marquent les éléments qui ne s’appliquent pas.
| Source de variation | SS | DF | MS | F | Valeur p |
|---|---|---|---|---|---|
| Modèle | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| Résidu | 1667.76 | 68 | 24.5259 | — | — |
Résumé des résidus
Le résidu est la consommation observée moins la consommation ajustée en kWh. La moyenne, l’écart-type, le minimum, les quartiles, la médiane et le maximum résument les 72 résidus de l’étude. Ces résumés ne sont pas des intervalles de prédiction pour un nouveau lot.
| Statistique | Valeur |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| médiane | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
Normalité des résidus
Le test sw désigne Shapiro–Wilk sur les résidus du modèle. La statistique et la valeur p évaluent un modèle de travail normal des erreurs. Lisez-les avec le graphique QQ ; p supérieur à 0.05 ne prouve pas la normalité des erreurs.
| Statistique | Valeur |
|---|---|
| Test | sw |
| Statistique | 0.982202 |
| Valeur p | 0.401846 |
Valeurs ajustées et résidus
L’indice repère un lot analysé dans l’ordre source. La valeur ajustée est la consommation modélisée en kWh ; le résidu est la consommation mesurée moins la consommation ajustée en kWh. Les 72 lignes sont incluses. Un signe positif signifie une consommation supérieure à la valeur ajustée et un signe négatif une consommation inférieure. Ces ajustements utilisent les mesures de l’étude elle-même.
| Indice | Ajusté | Résidu |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7. Créer un rapport
Conservez Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, les deux graphiques des résidus, les résumés et le test de normalité des résidus, ainsi que toutes les lignes de Fitted values and residuals. Notez l’ordre et les unités des prédicteurs ; décrivez des associations et vérifiez séparément la performance prédictive future.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.