

App-Befehle, Arbeitsblattkennungen und Werte der Beispieldaten bleiben im Original erhalten. Screenshots, Diagramme und Dateien zum Herunterladen liegen im englischen Original vor. Die Zahlen in dieser Anleitung verwenden die englische Schreibweise mit Dezimalpunkt und Tausenderkomma.
Beispiel: Stromverbrauch bei Trocknungschargen
72 unabhängige Chargen mit Stromverbrauch und drei numerischen erklärenden Variablen.
Beispieldaten herunterladen (CSV, englisches Original)Dasselbe Beispiel finden Sie unter Help. Importieren Sie die CSV-Datei, um den Schritten zu folgen, oder verwenden Sie Open example in a practice copy in Help, um die Eingaben vorab ausfüllen zu lassen.
1. Arbeitsumgebung erstellen
Öffnen Sie Basic Statistics in der Seitenleiste und wählen Sie Linear Regression. Erstellen Sie eine Analyse, geben Sie ihr einen Namen, wählen Sie New blank worksheet und anschließend Create analysis.
2. Beispieldaten importieren
Laden Sie die CSV-Datei oben herunter und importieren Sie sie in das Arbeitsblatt. Wählen Sie Comma als Trennzeichen, Dot als Dezimaltrennzeichen und First row contains column names.
3. Eingabespalten zuordnen
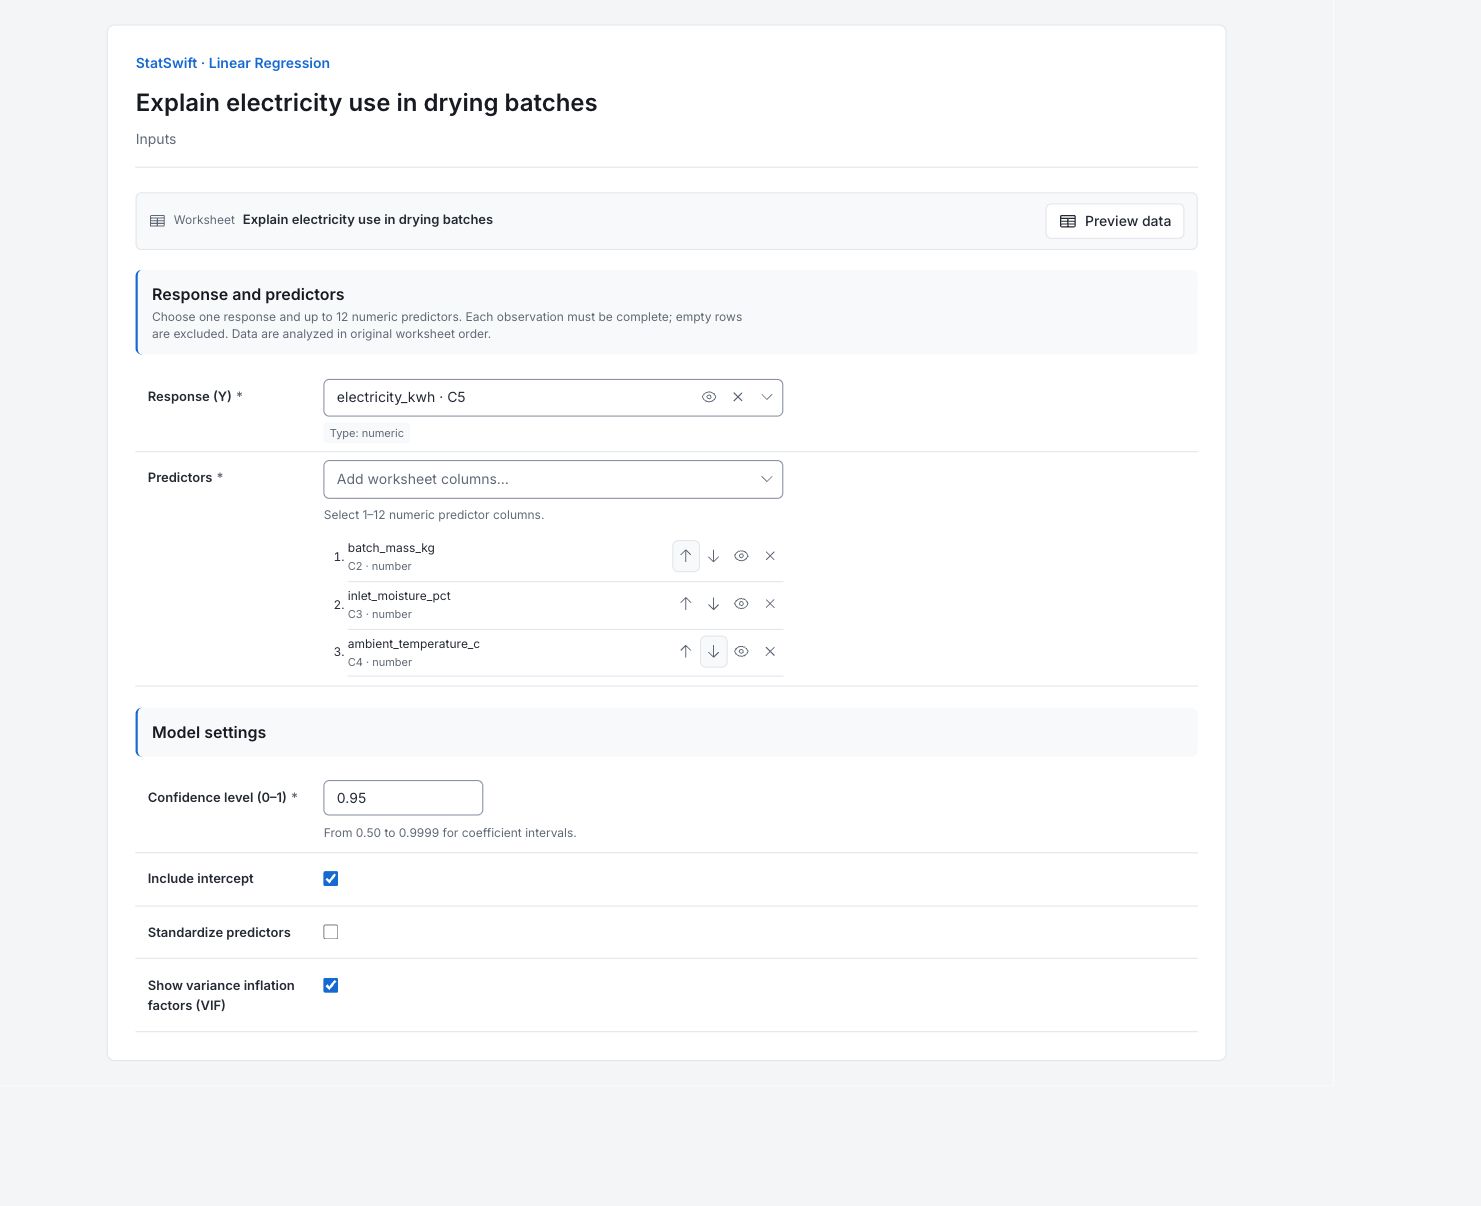
Ordnen Sie unter Inputs die Spalte electricity_kwh dem Feld Response (Y) zu. Öffnen Sie Predictors und wählen Sie batch_mass_kg, inlet_moisture_pct und ambient_temperature_c in dieser Reihenfolge. In den Ergebnissen werden sie entsprechend als X1, X2 und X3 bezeichnet.
4. Modell einstellen
Geben Sie 0.95 in Confidence level (0–1) ein. Aktivieren Sie Include intercept und Show variance inflation factors (VIF). Lassen Sie Standardize predictors deaktiviert, um die eingegebenen Einheiten beizubehalten.
5. Analyse ausführen
Wählen Sie Run analysis und öffnen Sie anschließend Results.
6. Ergebnisse interpretieren
Angepasste Zielgröße bestimmen
Das Modell verwendet 72 unabhängige Chargen, um den Stromverbrauch anhand von Masse, Eingangsfeuchte und Umgebungstemperatur zu beschreiben. R² beträgt etwa 0.8938. Dies beschreibt die Anpassung an diese Chargen; die aufgezeichneten Zusammenhänge belegen keine Ursachen.
Koeffizienten in ihren Einheiten ablesen
Bei konstant gehaltenen übrigen Prädiktoren sind zusätzliche 10 kg mit etwa 3.42 kWh Mehrverbrauch verbunden. Bei der Feuchte beträgt der entsprechende Zusammenhang etwa 2.65 kWh pro Prozentpunkt und bei der Temperatur etwa −0.753 kWh pro °C. Alle drei 95%-Konfidenzintervalle der Koeffizienten schließen null aus. Der Achsenabschnitt setzt alle Prädiktoren gleich null und liegt damit außerhalb der Untersuchungsbedingungen.
Residuendiagramm ablesen
Ein Residuum ist die Differenz zwischen dem gemessenen und dem angepassten Stromverbrauch in kWh. Beobachtung 49 liegt etwa 11.09 kWh unter ihrem angepassten Wert und hat damit das betragsmäßig größte Residuum. Prüfen Sie ihre Aufzeichnungen und untersuchen Sie die gesamte Punktwolke auf Krümmungen oder veränderliche Streuung. Leiten Sie aus diesem Punkt allein keinen Fehler ab.

Englisches Diagramm der Residuen gegen die angepassten Werte (Residuals vs fitted). Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Verteilungsenden der Residuen prüfen
Das QQ-Diagramm vergleicht die sortierten Residuen mit Referenzpositionen einer Normalverteilung. Achten Sie auf systematische Krümmungen und ungewöhnliche Verteilungsenden. Der Shapiro–Wilk-Test der Residuen ergibt p = 0.4018 und verwirft die Normalverteilung bei 0.05 nicht; keines der beiden Ergebnisse beweist das Fehlermodell. Dies betrifft die Residuen, nicht die ursprünglichen Stromverbrauchswerte.

Englisches QQ-Diagramm der Residuen (Residual QQ plot). Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Einsatz bei neuen Chargen prüfen
VIF-Werte von etwa 1.003–1.045 zeigen eine geringe Inflation durch lineare Abhängigkeit zwischen den Prädiktoren; sie belegen nicht die richtige Modellform. Beschränken Sie Vorhersagen auf vergleichbare Bedingungen: beobachtete Masse 80.1–217.1 kg, Feuchte 6.05–13.57% und Temperatur 15.2–27.9°C. Die Einhaltung dieser einzelnen Bereiche reicht nicht aus, wenn eine neue Kombination von den untersuchten Kombinationen abweicht. Validieren Sie Vorhersagen an neuen Chargen, bevor Sie darauf Planungen stützen.
Weitere Einzelheiten: die einzelnen Ergebnisabschnitte lesen
Vollständige Ergebnistabellen verwenden wie im Bereich Help sechs signifikante Stellen.
Anpassung der linearen Regression
R² beschreibt den durch das angepasste Modell erklärten Streuungsanteil; Adjusted R² berücksichtigt die Anzahl der Prädiktoren, und Raw adjusted R² bewahrt den Wert vor Anwendung der angegebenen Darstellungskonvention. Model F und Model p-value testen die Prädiktoren gemeinsam. Model DF und Residual DF dokumentieren die verfügbare Information. Die übrigen Anpassungseinstellungen dokumentieren Konfidenzniveau, Achsenabschnitt und Skalierung. Dies sind Ergebnisse der Anpassung an die Untersuchungsdaten, keine Vorhersageleistung anhand zurückgehaltener Daten.
| Kennzahl | Wert |
|---|---|
| R² | 0.893774 |
| Korrigiertes R² | 0.889088 |
| Unbegrenztes korrigiertes R² | 0.889088 |
| Konvention für korrigiertes R² | Negative Werte werden als null angegeben (Validierungsdatensatz) |
| F des Modells | 190.715 |
| p-Wert des Modells | 4.9105e-33 |
| Modellfreiheitsgrade | 3 |
| Residuenfreiheitsgrade | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| Beobachtungen | 72 |
| Beibehaltene Prädiktoren | 3 |
| Parameter | 4 |
| Eingabezeilen | 72 |
| Verwendete Zeilen | 72 |
| Ausgeschlossene Zeilen | 0 |
| Zeilen mit angepassten Werten | 72 |
| Prädiktoren | X1, X2, X3 |
- Das Modell ist statistisch signifikant. Signifikante Prädiktoren: X1, X2, X3
Regressionskoeffizienten
X1 ist die Chargenmasse, X2 die Eingangsfeuchte und X3 die Umgebungstemperatur. β ist der geschätzte Koeffizient in Einheiten der Zielgröße pro Prädiktoreinheit. SE beschreibt die Unsicherheit des Koeffizienten; t und p-value testen einen Koeffizienten von null; CI low und CI high begrenzen sein 95%-Konfidenzintervall. Jede Steigung gilt bei konstant gehaltenen übrigen Prädiktoren. Der Achsenabschnitt setzt alle Prädiktoren gleich null.
| Term | β | Standardfehler | t | p-Wert | KI-Untergrenze | KI-Obergrenze |
|---|---|---|---|---|---|---|
| Achsenabschnitt | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
Varianzinflationsfaktoren
Die Prädiktorbezeichnungen folgen der ausgewählten Reihenfolge. Der VIF misst die Inflation der Koeffizientenvarianz durch lineare Abhängigkeit von anderen Prädiktoren. Werte nahe 1 deuten auf eine geringe Inflation hin; sie bestätigen weder Linearität noch Unabhängigkeit noch künftige Vorhersagen.
| Prädiktor | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
Regressions-ANOVA
Model ist die durch die Prädiktoren angepasste Streuung; Residual ist die unerklärte Streuung. SS ist die Quadratsumme, DF sind die Freiheitsgrade und MS ist SS geteilt durch DF. F vergleicht die mittleren Quadratsummen von Modell und Residuen; p-value testet die Prädiktoren gemeinsam. Striche kennzeichnen nicht anwendbare Einträge.
| Quelle | Quadratsumme (SS) | Freiheitsgrade (DF) | Mittlere Quadratsumme (MS) | F | p-Wert |
|---|---|---|---|---|---|
| Modell | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| Residuum | 1667.76 | 68 | 24.5259 | — | — |
Residuenübersicht
Residual ist der beobachtete Stromverbrauch minus der angepasste Stromverbrauch in kWh. Mittelwert, Standardabweichung, Minimum, Quartile, Median und Maximum fassen die 72 Residuen der Untersuchung zusammen. Diese Übersichten sind keine Vorhersageintervalle für eine neue Charge.
| Kennzahl | Wert |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| Median | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
Normalverteilung der Residuen
Der Wert sw unter Test bedeutet Shapiro–Wilk-Test auf Modellresiduen. Statistic und p-value bewerten ein Arbeitsmodell mit normalverteilten Fehlern. Lesen Sie sie zusammen mit dem QQ-Diagramm; ein p-Wert über 0.05 beweist keine normalverteilten Fehler.
| Kennzahl | Wert |
|---|---|
| Test | sw |
| Kennzahl | 0.982202 |
| p-Wert | 0.401846 |
Angepasste Werte und Residuen
Index verortet eine analysierte Charge in der Reihenfolge der Quelldaten. Fitted ist der modellierte Stromverbrauch in kWh; Residual ist der gemessene Verbrauch minus der angepasste Verbrauch in kWh. Alle 72 Zeilen sind enthalten. Positiv bedeutet, dass der Verbrauch den angepassten Wert überstieg, negativ, dass er darunter lag. Diese angepassten Werte verwenden die Messwerte der Untersuchung selbst.
| Index | Angepasster Wert | Residuum |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7. Bericht erstellen
Behalten Sie Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, beide Residuendiagramme, die Residuenübersichten und den Normalitätstest sowie jede Zeile von Fitted values and residuals im englischen Bericht. Dokumentieren Sie die Reihenfolge und Einheiten der Prädiktoren; beschreiben Sie Zusammenhänge und prüfen Sie die Vorhersageleistung für künftige Daten gesondert.
Wählen Sie Add to report im abgeschlossenen Analyselauf. Öffnen Sie Choose individual items and advanced options zur Auswahl von Tabellen und Diagrammen und wählen Sie anschließend Add to draft. Ausgeblendete Elemente bleiben in der gespeicherten Analyse erhalten.
Geben Sie dem Bericht einen Namen und ergänzen Sie den Zweck der Untersuchung sowie Ihre Interpretation. Wählen Sie Save, prüfen Sie Preview und verwenden Sie anschließend Export → Download HTML. Das folgende Beispiel enthält den gesamten ausgewählten Inhalt, auch Ergebnisse, die über eine Bildschirmansicht hinausgehen.