

ऐप के कमांड, वर्कशीट के पहचानकर्ता और उदाहरण डेटा के मान अपने मूल रूप में हैं। स्क्रीनशॉट, चार्ट और डाउनलोड अंग्रेज़ी में हैं। वैज्ञानिक उदाहरणों में मूल दशमलव बिंदु और हज़ारों के लिए अल्पविराम सुरक्षित हैं; वेबसाइट की कीमतें और गिनती स्थानीय स्वरूप में दिखाई जाती हैं।
उदाहरण: बैच सुखाने में बिजली की खपत
72 स्वतंत्र बैच, जिनमें बिजली की खपत और तीन संख्यात्मक व्याख्यात्मक चर हैं।
उदाहरण डेटा डाउनलोड करें (CSV)यही उदाहरण Help में इस्तेमाल किया गया है। चरणों का पालन करने के लिए CSV आयात करें, या इनपुट पहले से भरने के लिए Help में Open example in a practice copy इस्तेमाल करें।
1. कार्यक्षेत्र बनाएँ
साइडबार में Basic Statistics खोलें और Linear Regression चुनें। विश्लेषण बनाएँ, उसे नाम दें, New blank worksheet चुनें और फिर Create analysis चुनें।
2. उदाहरण डेटा आयात करें
ऊपर दिया CSV डाउनलोड करके वर्कशीट में आयात करें। विभाजक के लिए Comma, दशमलव चिह्न के लिए Dot और First row contains column names चुनें।
3. इनपुट कॉलम चुनें
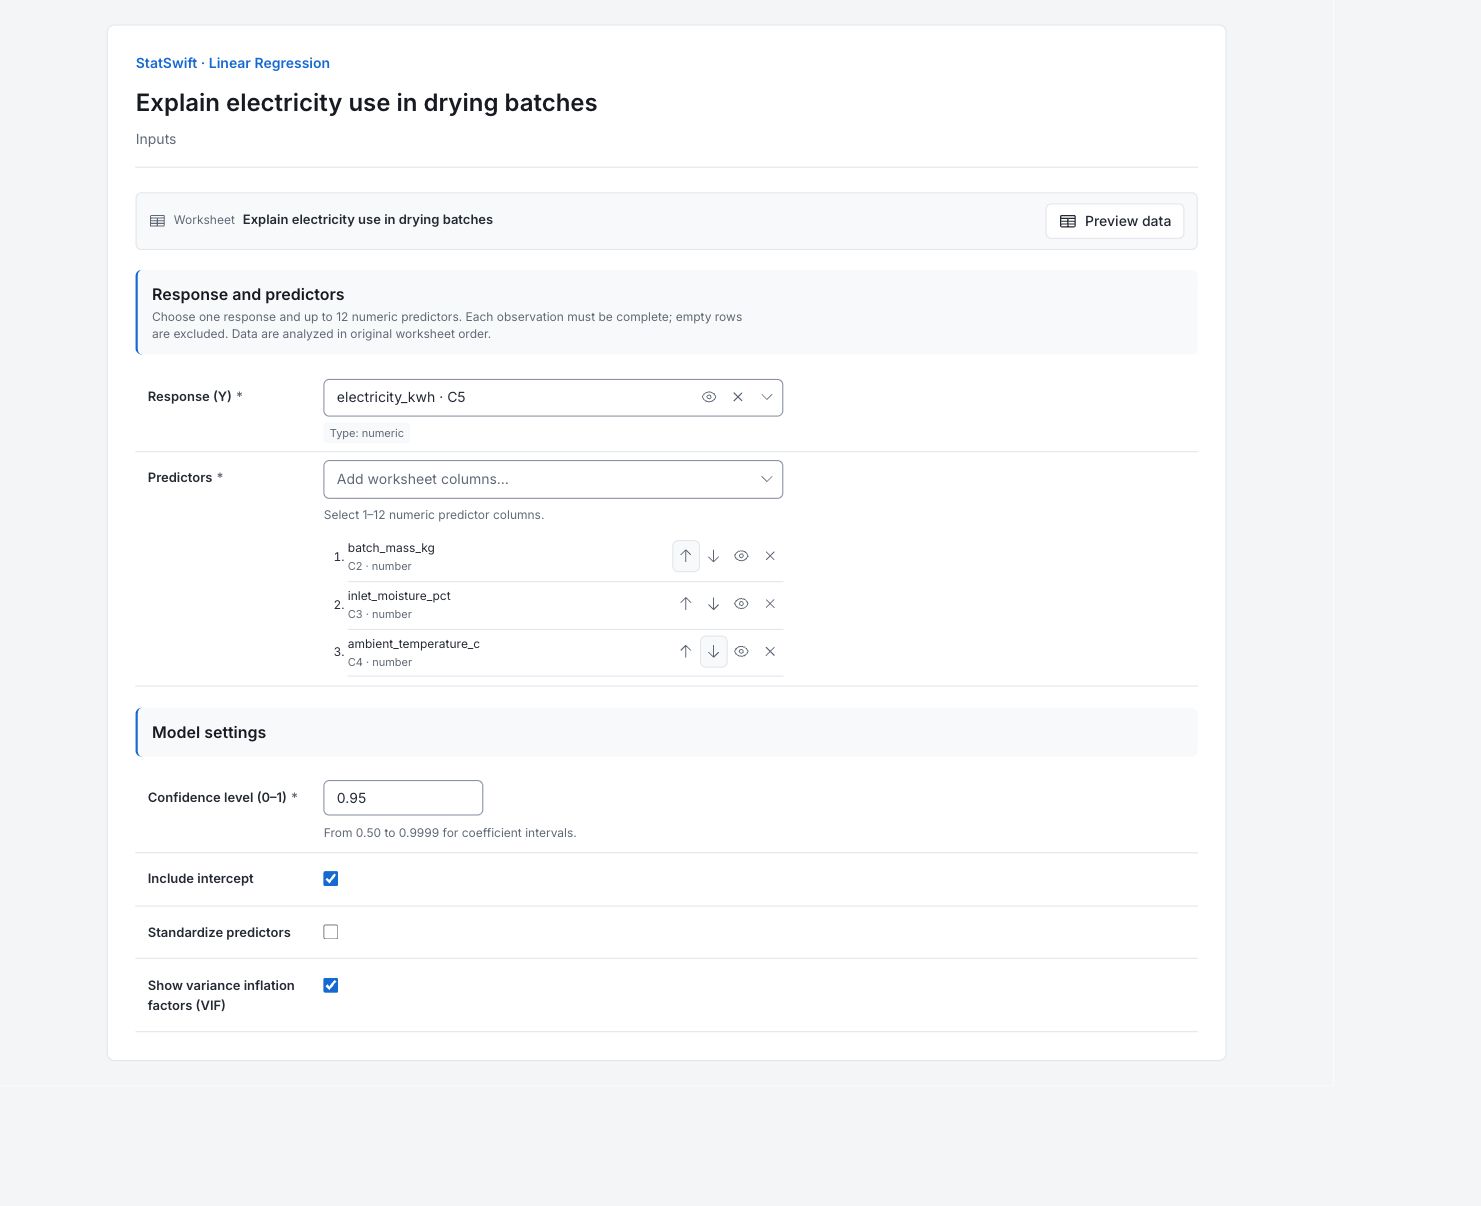
Inputs में electricity_kwh को Response (Y) से जोड़ें। Predictors खोलें और batch_mass_kg, inlet_moisture_pct तथा ambient_temperature_c इसी क्रम में चुनें। परिणाम उन्हें क्रमशः X1, X2 और X3 के लेबल देते हैं।
4. मॉडल सेट करें
Confidence level (0–1) में 0.95 दर्ज करें। Include intercept और Show variance inflation factors (VIF) चुनें। दर्ज इकाइयाँ बनाए रखने के लिए Standardize predictors को अचयनित रहने दें।
5. विश्लेषण चलाएँ
Run analysis चुनें, फिर Results खोलें।
6। परिणामों की व्याख्या करें
फ़िट की गई प्रतिक्रिया पहचानें
मॉडल द्रव्यमान, प्रवेश नमी और परिवेश तापमान से बिजली की खपत का वर्णन करने के लिए 72 स्वतंत्र बैच इस्तेमाल करता है। R² लगभग 0.8938 है। यह इन बैचों पर फ़िट का वर्णन करता है; दर्ज संबंध कारण स्थापित नहीं करते हैं।
गुणांक को उसकी इकाइयों में पढ़ें
दूसरे पूर्वानुमानक स्थिर रखते हुए, अतिरिक्त 10 kg का संबंध लगभग 3.42 kWh अधिक खपत से है। नमी का संबंध प्रति प्रतिशत अंक लगभग 2.65 kWh और तापमान का प्रति °C लगभग −0.753 kWh से है। तीनों गुणांकों के 95% अंतराल शून्य को शामिल नहीं करते हैं। सभी पूर्वानुमानक शून्य होने का अवरोधक अध्ययन की परिस्थितियों से बाहर है।
अवशेष आलेख पढ़ें
अवशेष मापी गई बिजली घटा फ़िट की गई बिजली है, kWh में। प्रेक्षण 49 अपने फ़िट से लगभग 11.09 kWh नीचे है, जो सबसे बड़ा निरपेक्ष अवशेष है। उसके अभिलेख जाँचें और पूरे बिंदु-समूह में वक्रता या बदलते फैलाव को देखें। केवल उस बिंदु से त्रुटि न मानें।

फ़िट किए गए मानों के सापेक्ष अवशेष पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) अवशेषों की पूँछ जाँचें
QQ आलेख क्रमबद्ध अवशेषों की तुलना सामान्य वितरण के संदर्भ स्थानों से करता है। व्यवस्थित वक्रता और असामान्य पूँछ देखें। अवशेषों के Shapiro–Wilk परीक्षण का p = 0.4018 है और वह 0.05 पर सामान्यता को अस्वीकार नहीं करता है; दोनों में से कोई परिणाम त्रुटि मॉडल सिद्ध नहीं करता है। यह अवशेषों के बारे में है, बिजली के मूल मानों के बारे में नहीं।

अवशेषों का QQ आलेख पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) नए बैचों पर उपयोग की जाँच करें
लगभग 1.003–1.045 के VIF पूर्वानुमानकों के बीच रेखीय निर्भरता से कम प्रसरण वृद्धि दिखाते हैं; वे मॉडल का सही रूप स्थापित नहीं करते हैं। पूर्वानुमान तुलनीय परिस्थितियों में रखें: देखा गया द्रव्यमान 80.1–217.1 kg, नमी 6.05–13.57% और तापमान 15.2–27.9°C। यदि नया संयोजन अध्ययन किए गए संयोजनों से अलग हो तो इन अलग-अलग मान-क्षेत्रों के भीतर रहना पर्याप्त नहीं है। पूर्वानुमानों से योजना बनाने से पहले नए बैचों पर उनका सत्यापन करें।
और जानकारी: परिणाम का हर खंड पढ़ें
परिणामों की पूरी तालिकाओं में Help की तरह छह सार्थक अंक हैं।
रेखीय प्रतिगमन का फ़िट
R² फ़िट की गई परिवर्तनशीलता बताता है; समायोजित R² पूर्वानुमानकों की संख्या का ध्यान रखता है और अपरिष्कृत समायोजित R² बताई गई प्रदर्शन परिपाटी से पहले का मान रखता है। मॉडल F और p-मान पूर्वानुमानकों का एक साथ परीक्षण करते हैं। मॉडल DF और अवशेष DF उपलब्ध जानकारी दर्ज करते हैं। बची हुई फ़िट सेटिंग विश्वास, अवरोधक और स्केलिंग का विवरण देती हैं। ये अध्ययन पर फ़िट के परिणाम हैं, अलग रखे गए डेटा पर पूर्वानुमान प्रदर्शन नहीं।
| सांख्यिक | मान |
|---|---|
| R² | 0.893774 |
| समायोजित R² | 0.889088 |
| मूल समायोजित R² | 0.889088 |
| समायोजित R² की परिपाटी | ऋणात्मक मानों को शून्य दिखाया गया है (सत्यापन डेटा) |
| मॉडल का F | 190.715 |
| मॉडल का p-मान | 4.9105e-33 |
| मॉडल का DF | 3 |
| अवशेष का DF | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| प्रेक्षण | 72 |
| रखे गए पूर्वानुमानक | 3 |
| प्राचल | 4 |
| इनपुट पंक्तियाँ | 72 |
| इस्तेमाल की गई पंक्तियाँ | 72 |
| हटाई गई पंक्तियाँ | 0 |
| फिट में इस्तेमाल हुई पंक्तियाँ | 72 |
| पूर्वानुमानक | X1, X2, X3 |
- मॉडल सांख्यिकीय रूप से सार्थक है। सार्थक पूर्वानुमानक: X1, X2, X3
प्रतिगमन गुणांक
X1 बैच द्रव्यमान है, X2 प्रवेश नमी और X3 परिवेश तापमान। β प्रतिक्रिया की इकाई प्रति पूर्वानुमानक की इकाई में अनुमानित गुणांक है। SE गुणांक की अनिश्चितता है; t और p-मान शून्य गुणांक का परीक्षण करते हैं; विश्वास अंतराल की निचली और ऊपरी सीमाएँ उसके 95% अंतराल को बाँधती हैं। हर ढलान दूसरे पूर्वानुमानक स्थिर रखती है। अवरोधक सभी पूर्वानुमानक शून्य मानता है।
| पद | β | SE | t | p-मान | विश्वास अंतराल की निचली सीमा | विश्वास अंतराल की ऊपरी सीमा |
|---|---|---|---|---|---|---|
| अंतःखंड | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
प्रसरण वृद्धि गुणक
पूर्वानुमानकों के लेबल चुने गए क्रम का अनुसरण करते हैं। VIF दूसरे पूर्वानुमानकों से रेखीय निर्भरता के कारण गुणांक के प्रसरण में वृद्धि मापता है। 1 के निकट मान कम वृद्धि सुझाते हैं; वे रेखीयता, स्वतंत्रता या भविष्य के पूर्वानुमानों का सत्यापन नहीं करते हैं।
| पूर्वानुमानक | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
प्रतिगमन ANOVA
मॉडल पूर्वानुमानकों से फ़िट की गई परिवर्तनशीलता है; अवशेष अस्पष्ट रह गई परिवर्तनशीलता है। SS वर्गों का योग है, DF स्वतंत्रता की कोटि और MS, SS को DF से भाग देने पर मिलता है। F मॉडल और अवशेष माध्य वर्गों की तुलना करता है; p-मान पूर्वानुमानकों का एक साथ परीक्षण करता है। डैश लागू न होने वाली प्रविष्टियाँ दर्शाते हैं।
| स्रोत | SS | DF | MS | F | p-मान |
|---|---|---|---|---|---|
| मॉडल | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| अवशेष | 1667.76 | 68 | 24.5259 | — | — |
अवशेषों का सारांश
अवशेष kWh में देखी गई बिजली घटा फ़िट की गई बिजली है। औसत, SD, न्यूनतम, चतुर्थक, माध्यिका और अधिकतम अध्ययन के 72 अवशेषों का सार देते हैं। ये सारांश नए बैच के पूर्वानुमान अंतराल नहीं हैं।
| सांख्यिक | मान |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| माध्यिका | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
अवशेषों की सामान्यता
परीक्षण sw का मतलब मॉडल के अवशेषों पर Shapiro–Wilk है। सांख्यिक और p-मान सामान्य कार्यकारी त्रुटि मॉडल का आकलन करते हैं। उन्हें QQ आलेख के साथ पढ़ें; p का 0.05 से अधिक होना सामान्य त्रुटियाँ सिद्ध नहीं करता है।
| सांख्यिक | मान |
|---|---|
| परीक्षण | sw |
| सांख्यिक | 0.982202 |
| p-मान | 0.401846 |
फ़िट किए गए मान और अवशेष
सूचकांक मूल क्रम में विश्लेषित बैच का स्थान बताता है। फ़िट किया गया मान kWh में मॉडल की बिजली खपत है; अवशेष मापी गई घटा फ़िट की गई kWh है। सभी 72 पंक्तियाँ शामिल हैं। धनात्मक का मतलब खपत उसके फ़िट से अधिक थी और ऋणात्मक का मतलब कम थी। ये फ़िट अध्ययन के अपने माप इस्तेमाल करते हैं।
| सूचकांक | फ़िट किया गया | अवशेष |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7। रिपोर्ट बनाएँ
Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, दोनों अवशेष आलेख, अवशेष सारांश और सामान्यता परीक्षण तथा Fitted values and residuals की हर पंक्ति रखें। पूर्वानुमानकों का क्रम और इकाइयाँ दर्ज करें; संबंधों का वर्णन करें और भविष्य के पूर्वानुमान प्रदर्शन की जाँच अलग से करें।
चुनें: Add to report पूरे हो चुके विश्लेषण से। खोलें: Choose individual items and advanced options —तालिकाएँ और चार्ट चुनने के लिए; फिर चुनें: Add to draft। छिपाए गए आइटम सहेजे गए विश्लेषण में बने रहते हैं।
रिपोर्ट को नाम दें और अध्ययन का उद्देश्य तथा अपनी व्याख्या जोड़ें। चुनें: Save, फिर देखें: Preview, और फिर इस्तेमाल करें: Export → Download HTML। नीचे दिए गए उदाहरण में चुनी गई पूरी सामग्री है, जिसमें एक स्क्रीन से आगे के परिणाम भी शामिल हैं।