

Los comandos de la aplicación, los identificadores de las hojas de trabajo y los valores de los datos de ejemplo conservan su redacción original. Las capturas de pantalla, los gráficos y las descargas están en inglés. Los ejemplos conservan la notación numérica original en inglés: punto decimal y coma como separador de millares.
Ejemplo: consumo eléctrico en lotes de secado
72 lotes independientes, con consumo eléctrico y tres variables explicativas numéricas.
Descargar los datos de ejemplo (CSV, columnas en inglés)Es el mismo ejemplo que se utiliza en Help. Importa el CSV para seguir los pasos o utiliza Open example in a practice copy en Help para rellenar previamente las entradas.
1. Crear el espacio de trabajo
En la barra lateral, abre Basic Statistics y elige Linear Regression. Crea un análisis, ponle un nombre, selecciona New blank worksheet y elige Create analysis.
2. Importar los datos de ejemplo
Descarga el CSV anterior e impórtalo en la hoja de trabajo. Elige Comma como delimitador, Dot como separador decimal y First row contains column names.
3. Asignar las columnas de entrada
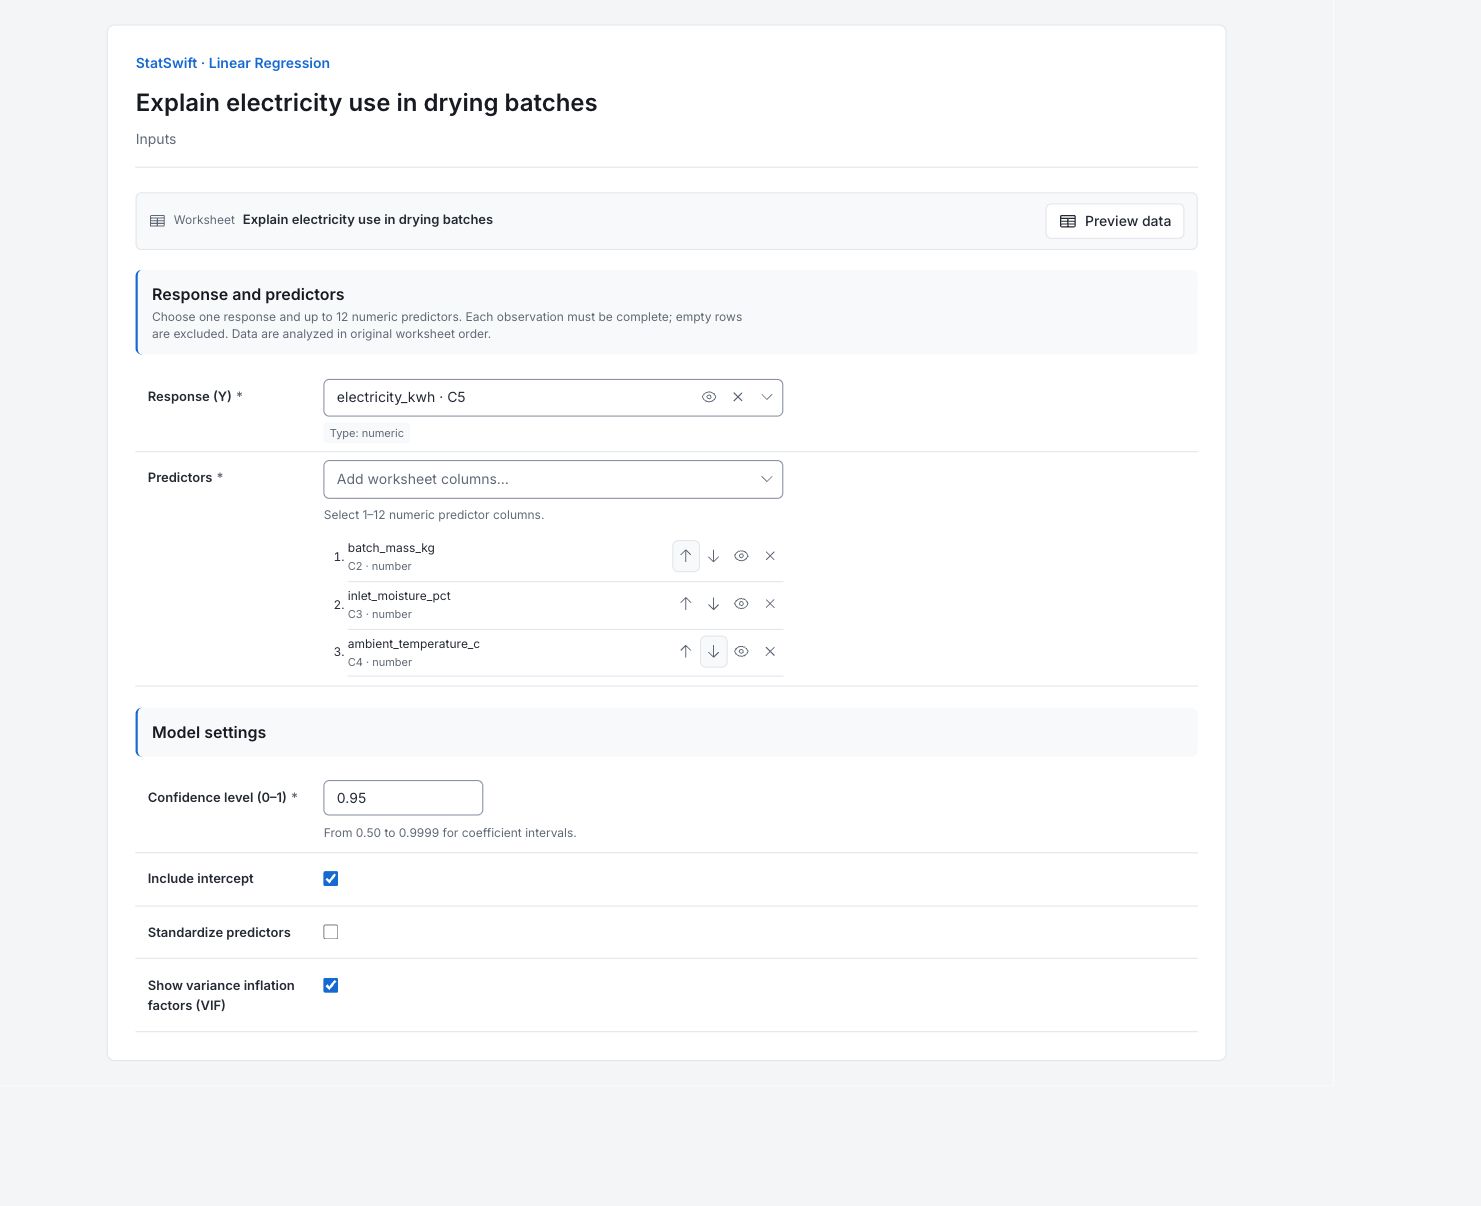
En Inputs, asigna electricity_kwh a Response (Y). Abre Predictors y selecciona batch_mass_kg, inlet_moisture_pct y ambient_temperature_c, en ese orden. Los resultados los etiquetan como X1, X2 y X3, respectivamente.
4. Configurar el modelo
Introduce 0.95 en Confidence level (0–1). Marca Include intercept y Show variance inflation factors (VIF). Deja Standardize predictors sin marcar para conservar las unidades introducidas.
5. Ejecutar el análisis
Elige Run analysis y abre Results.
6. Interpretar los resultados
Identificar la respuesta ajustada
El modelo utiliza 72 lotes independientes para describir el consumo eléctrico a partir de la masa, la humedad de entrada y la temperatura ambiente. R² es aproximadamente 0.8938. Esto describe el ajuste a estos lotes; las relaciones registradas no establecen causas.
Leer un coeficiente en sus unidades
Manteniendo fijos los demás predictores, 10 kg adicionales se asocian con unos 3.42 kWh más de consumo. La humedad añade unos 2.65 kWh por punto porcentual y la temperatura, unos −0.753 kWh por °C. Los tres intervalos del 95% de los coeficientes excluyen el cero. La ordenada en el origen para todos los predictores iguales a cero queda fuera de las condiciones del estudio.
Leer el gráfico de residuos
Un residuo es el consumo eléctrico medido menos el ajustado, en kWh. La observación 49 está unos 11.09 kWh por debajo de su valor ajustado y tiene el mayor residuo en valor absoluto. Revisa sus registros y examina toda la nube para detectar curvaturas o cambios de dispersión. No supongas que es un error solo por ese punto.

Gráfico en inglés de residuos frente a valores ajustados Ver gráfico a tamaño completo (se abre en una nueva pestaña) Comprobar las colas de los residuos
El gráfico QQ compara los residuos ordenados con las posiciones de referencia normales. Busca curvaturas sistemáticas y colas inusuales. El contraste de Shapiro–Wilk de los residuos tiene p = 0.4018 y no rechaza la normalidad a 0.05; ninguno de estos resultados demuestra el modelo de errores. Esto concierne a los residuos, no a los valores brutos de consumo eléctrico.

Gráfico QQ de residuos, en inglés Ver gráfico a tamaño completo (se abre en una nueva pestaña) Comprobar el uso en nuevos lotes
Los VIF de aproximadamente 1.003–1.045 muestran poca inflación por dependencia lineal entre los predictores; no demuestran que la forma del modelo sea la correcta. Limita las predicciones a condiciones comparables: masa observada de 80.1–217.1 kg, humedad de 6.05–13.57% y temperatura de 15.2–27.9°C. Mantenerse dentro de esos rangos por separado no basta si una nueva combinación difiere de las estudiadas. Valida las predicciones en nuevos lotes antes de planificar a partir de ellas.
Más detalles: leer cada sección de resultados
Las tablas de resultados completas utilizan seis cifras significativas, como en Help.
Ajuste de regresión lineal
R² describe la variación ajustada; R² ajustado tiene en cuenta el número de predictores, y R² ajustado bruto conserva el valor anterior a la convención de presentación indicada. F del modelo y el valor p contrastan los predictores conjuntamente. Los grados de libertad del modelo y de los residuos registran la información disponible. Los demás ajustes documentan la confianza, la ordenada en el origen y el escalado. Son resultados del ajuste al estudio, no del desempeño predictivo en datos reservados para validación.
| Estadístico | Valor |
|---|---|
| R² | 0.893774 |
| R² ajustado | 0.889088 |
| R² ajustado sin limitar | 0.889088 |
| Convención del R² ajustado | Los valores negativos se presentan como cero (conjunto de datos de validación) |
| F del modelo | 190.715 |
| Valor p del modelo | 4.9105e-33 |
| Grados de libertad del modelo | 3 |
| Grados de libertad de los residuos | 68 |
| AIC | 438.592 |
| BIC | 447.699 |
| Observaciones | 72 |
| Variables predictoras conservadas | 3 |
| Parámetros | 4 |
| Filas de entrada | 72 |
| Filas utilizadas | 72 |
| Filas excluidas | 0 |
| Filas ajustadas | 72 |
| Variables predictoras | X1, X2, X3 |
- El modelo es estadísticamente significativo. Predictores significativos: X1, X2, X3
Coeficientes de regresión
X1 es la masa del lote, X2 la humedad de entrada y X3 la temperatura ambiente. β es el coeficiente estimado en unidades de respuesta por unidad del predictor. SE es la incertidumbre del coeficiente; t y el valor p contrastan un coeficiente nulo; los límites inferior y superior del IC delimitan su intervalo del 95%. Cada pendiente mantiene fijos los demás predictores. La ordenada en el origen supone que todos los predictores son cero.
| Término | β | SE | t | Valor p | Límite inferior del IC | Límite superior del IC |
|---|---|---|---|---|---|---|
| Intercepto | 28.8348 | 5.20051 | 5.5446 | 5.20972e-7 | 18.4573 | 39.2122 |
| X1 | 0.342474 | 0.0147858 | 23.1623 | 5.58816e-34 | 0.312969 | 0.371979 |
| X2 | 2.64786 | 0.278707 | 9.50051 | 4.24797e-14 | 2.09171 | 3.20401 |
| X3 | -0.752958 | 0.161902 | -4.65069 | 0.0000157443 | -1.07603 | -0.429887 |
Factores de inflación de la varianza
Las etiquetas de los predictores siguen el orden seleccionado. VIF mide la inflación de la varianza del coeficiente por dependencia lineal con otros predictores. Los valores próximos a 1 sugieren poca inflación; no validan la linealidad, la independencia ni las predicciones futuras.
| Predictor | VIF |
|---|---|
| X1 | 1.04507 |
| X2 | 1.04345 |
| X3 | 1.00284 |
ANOVA de la regresión
El modelo es la variación ajustada por los predictores; el residuo es la variación no explicada. SS es la suma de cuadrados, DF los grados de libertad y MS es SS dividido por DF. F compara los cuadrados medios del modelo y de los residuos; el valor p contrasta los predictores conjuntamente. Las rayas marcan las entradas no aplicables.
| Fuente | SS | DF | MS | F | Valor p |
|---|---|---|---|---|---|
| Modelo | 14032.3 | 3 | 4677.45 | 190.715 | 4.9105e-33 |
| Residuo | 1667.76 | 68 | 24.5259 | — | — |
Resumen de residuos
El residuo es el consumo eléctrico observado menos el ajustado, en kWh. La media, la desviación estándar, el mínimo, los cuartiles, la mediana y el máximo resumen los 72 residuos del estudio. Estos resúmenes no son intervalos de predicción para un nuevo lote.
| Estadístico | Valor |
|---|---|
| mean | -3.75009e-14 |
| sd | 4.8466 |
| min | -11.088 |
| q1 | -3.95264 |
| mediana | 0.706102 |
| q3 | 3.15057 |
| max | 10.0148 |
Normalidad de los residuos
El contraste sw indica Shapiro–Wilk sobre los residuos del modelo. El estadístico y el valor p evalúan un modelo de trabajo con errores normales. Léelos junto con el gráfico QQ; un valor p superior a 0.05 no demuestra que los errores sean normales.
| Estadístico | Valor |
|---|---|
| Prueba | sw |
| Estadístico | 0.982202 |
| Valor p | 0.401846 |
Valores ajustados y residuos
El índice localiza un lote analizado en el orden de origen. El valor ajustado es el consumo eléctrico del modelo en kWh; el residuo es el consumo medido menos el ajustado en kWh. Se incluyen las 72 filas. Un signo positivo significa que el consumo superó su valor ajustado y uno negativo, que fue menor. Estos ajustes utilizan las propias mediciones del estudio.
| Índice | Valor ajustado | Residuo |
|---|---|---|
| 1 | 76.8375 | -3.81753 |
| 2 | 111.443 | -2.13264 |
| 3 | 75.7204 | 1.14955 |
| 4 | 73.4656 | 3.88444 |
| 5 | 100.348 | -2.22753 |
| 6 | 95.3359 | -7.58587 |
| 7 | 61.8309 | 8.55906 |
| 8 | 106.66 | 7.07966 |
| 9 | 74.3682 | 0.981848 |
| 10 | 99.8278 | 7.0722 |
| 11 | 97.5272 | 2.16277 |
| 12 | 104.194 | 0.365946 |
| 13 | 94.7032 | 1.26677 |
| 14 | 85.201 | -6.62098 |
| 15 | 79.8409 | -8.93085 |
| 16 | 80.5206 | 3.12941 |
| 17 | 84.9566 | -6.02665 |
| 18 | 93.7188 | 1.90123 |
| 19 | 90.0313 | -3.88125 |
| 20 | 94.0478 | -1.20783 |
| 21 | 114.851 | -6.16149 |
| 22 | 92.2695 | -4.23952 |
| 23 | 96.6762 | 6.52381 |
| 24 | 66.6088 | -2.5788 |
| 25 | 76.9681 | -3.57805 |
| 26 | 90.0441 | 1.4559 |
| 27 | 95.2115 | 2.02854 |
| 28 | 108.518 | 7.58219 |
| 29 | 88.2918 | 9.85815 |
| 30 | 77.943 | 1.38699 |
| 31 | 112.115 | -0.604855 |
| 32 | 80.9672 | -0.84725 |
| 33 | 93.5637 | 1.61629 |
| 34 | 75.9464 | 6.92363 |
| 35 | 81.2173 | 3.64274 |
| 36 | 67.877 | -6.48696 |
| 37 | 83.1836 | 1.18643 |
| 38 | 83.2826 | -4.13263 |
| 39 | 62.5775 | 1.63248 |
| 40 | 77.0167 | -1.19671 |
| 41 | 74.7452 | 10.0148 |
| 42 | 62.3518 | -6.91183 |
| 43 | 72.1913 | -6.30129 |
| 44 | 103.086 | 4.32423 |
| 45 | 77.018 | 2.35204 |
| 46 | 106.022 | -5.8115 |
| 47 | 101.478 | 2.57173 |
| 48 | 78.4989 | 1.67105 |
| 49 | 97.358 | -11.088 |
| 50 | 90.0492 | -0.529165 |
| 51 | 104.944 | -0.953625 |
| 52 | 91.5789 | 5.68115 |
| 53 | 71.2582 | 1.67181 |
| 54 | 84.7296 | 0.430356 |
| 55 | 103.353 | -3.93251 |
| 56 | 70.0678 | 3.20216 |
| 57 | 99.8221 | 4.06795 |
| 58 | 78.7868 | 4.27315 |
| 59 | 102.688 | 7.0117 |
| 60 | 96.268 | -7.12799 |
| 61 | 89.2849 | 4.64514 |
| 62 | 71.7717 | -1.67166 |
| 63 | 77.974 | 2.30597 |
| 64 | 85.5329 | -6.52289 |
| 65 | 72.9776 | -0.0575804 |
| 66 | 102.704 | -4.1637 |
| 67 | 74.6012 | -6.77125 |
| 68 | 106.379 | -4.28947 |
| 69 | 103.197 | 3.13337 |
| 70 | 116.943 | -4.01301 |
| 71 | 68.0824 | -1.86244 |
| 72 | 102.321 | 5.51867 |
7. Crear un informe
Conserva Linear regression fit, Regression coefficients, Variance inflation factors, Regression ANOVA, ambos gráficos de residuos, los resúmenes de residuos y el contraste de normalidad, y todas las filas de Fitted values and residuals. Anota el orden de los predictores y las unidades; describe asociaciones y comprueba por separado el desempeño predictivo futuro.
Selecciona Add to report de la ejecución completada. Abre Choose individual items and advanced options para seleccionar tablas y gráficos y, a continuación, selecciona Add to draft. Los elementos ocultos se conservan en el análisis guardado.
Asigna un nombre al informe y añade el objetivo del estudio y tu interpretación. Selecciona Save, revisa Preview, y después utiliza Export → Download HTML. El ejemplo siguiente contiene todo el contenido seleccionado, incluidos los resultados que no caben en una sola pantalla.