

앱 명령어, 워크시트 식별자 및 예제 데이터 값은 원문 그대로 유지됩니다. 스크린샷, 차트 및 다운로드 파일은 영어로 제공됩니다. 예제는 영어 원문의 숫자 표기를 유지하며, 소수점에는 마침표를, 천 단위 구분에는 쉼표를 사용합니다.
예제: 포장 시간
이 예제는 세 포장 구역의 주문 90건을 기록합니다. 포장 시간의 단위는 초이며, 각 주문의 품목 수와 소포 질량도 기록되어 있습니다.
예제 데이터 다운로드(CSV, 열 이름은 영어)Help에서 사용하는 예제와 같습니다. CSV에는 가져올 관측값이 들어 있습니다.
1. 분석 만들기
사이드바에서 Plots를 열고 분석을 만듭니다. 이름을 입력하고 New blank worksheet를 선택한 뒤 Create analysis를 선택합니다.
2. 데이터 가져오기
Worksheet에서 Import를 선택합니다. 다운로드한 CSV를 선택하거나 내용을 붙여넣습니다. 구분 기호는 Comma, 소수점 기호는 Decimal dot으로 지정하고 First row contains column names를 선택합니다. 가져올 내용을 미리 확인한 뒤 Import into worksheet를 선택합니다.
3. 입력 열 지정
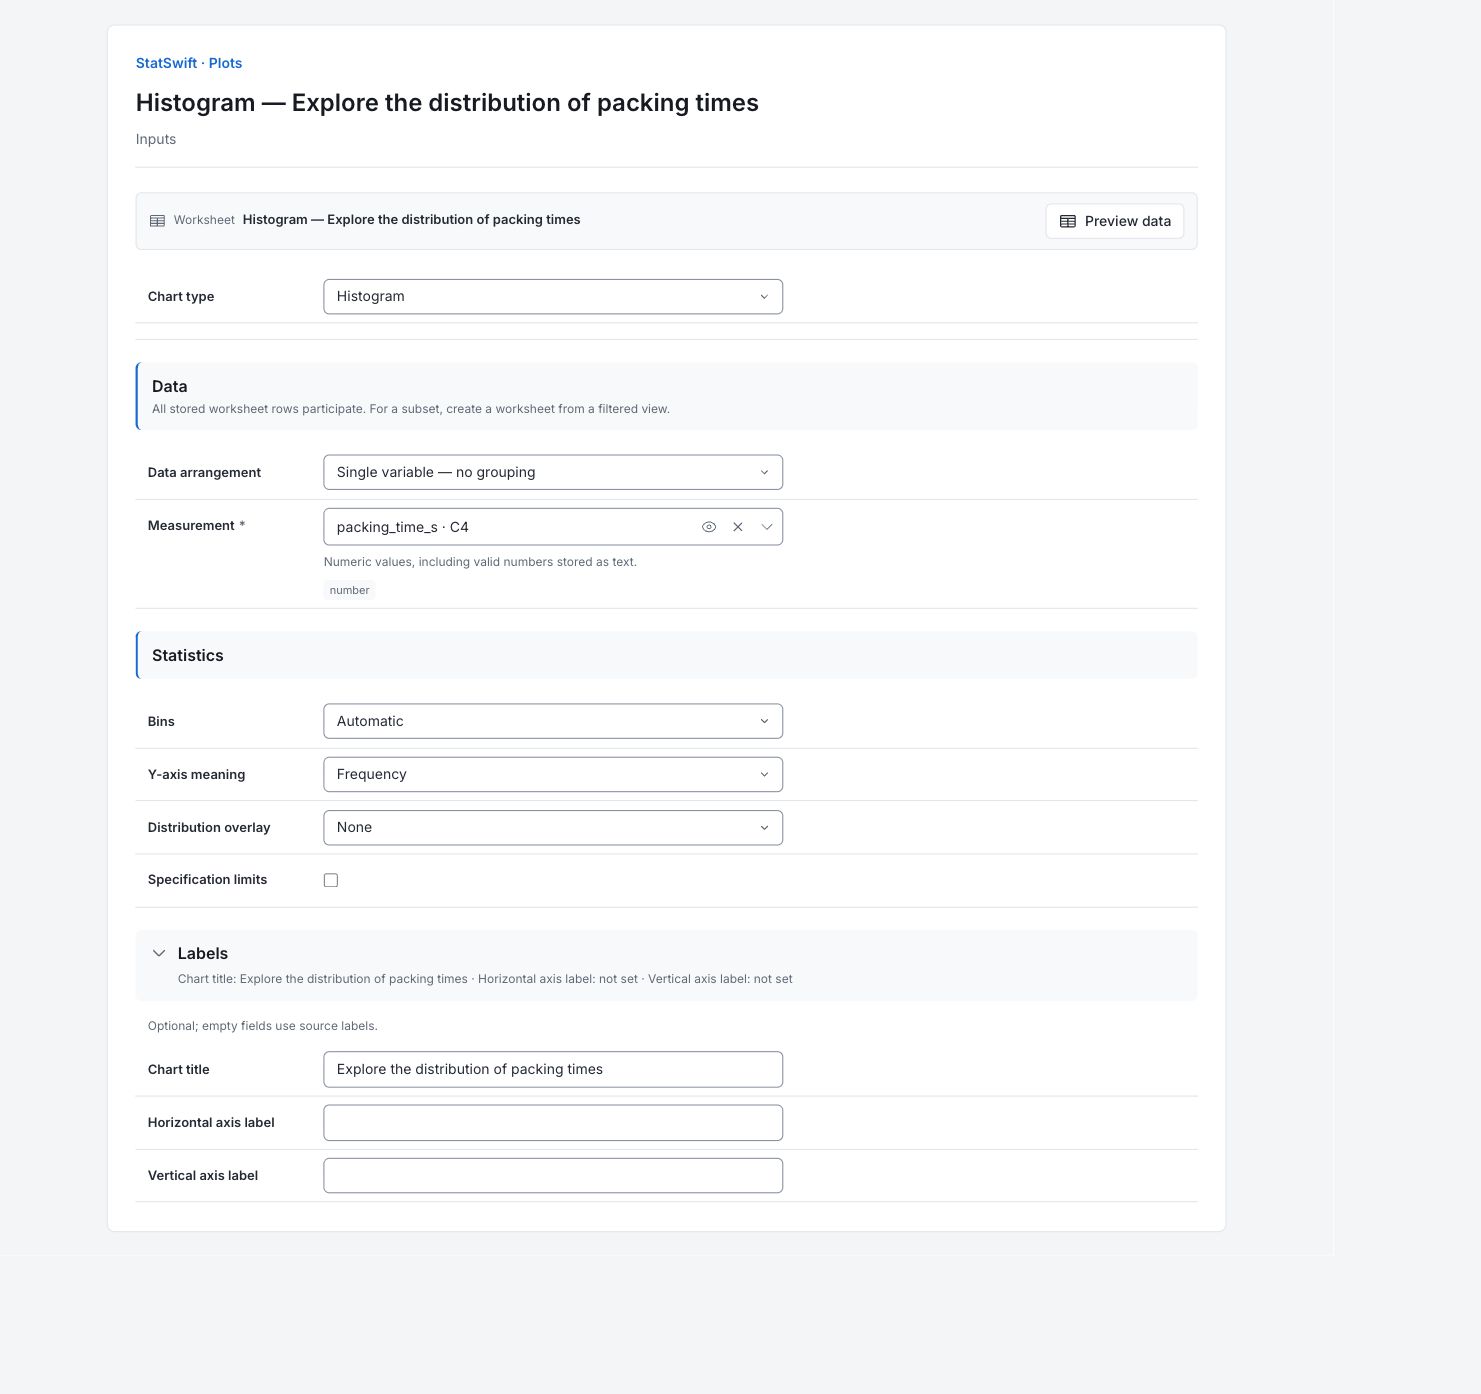
Inputs의 Chart type에서 Histogram을 선택합니다. Data arrangement에서는 Single variable — no grouping을 선택합니다.
Measurement의 열 선택기를 열어 packing_time_s를 선택합니다. 각 주문의 포장 시간이 초 단위로 들어 있습니다.
4. 차트 옵션 설정
Statistics에서 Bins는 Automatic, Y-axis meaning은 Frequency, Distribution overlay는 None으로 설정합니다. Specification limits는 선택하지 않은 상태로 둡니다.
Labels를 열고 Chart title에 Explore the distribution of packing times를 입력합니다. 원래 레이블을 사용하도록 Horizontal axis label과 Vertical axis label은 비워 둡니다.
5. 차트 만들기
Create chart를 선택하고 Results를 엽니다. 차트를 이 가이드와 비교하기 전에 Data used를 확인합니다. 저장된 워크시트의 모든 행이 분석에 포함되며, 워크시트를 정렬하거나 필터링해도 분석에 사용하는 표본은 바뀌지 않습니다.
6. 결과 해석
막대 읽기
가로축은 초 단위의 포장 시간입니다. 각 막대는 포장 시간이 해당 구간에 속하는 주문의 수입니다. 막대가 높을수록 주문이 많은 것이며, 개별 주문의 시간이 더 길다는 뜻은 아닙니다.

영어 차트: 주문 90건 전체의 포장 시간을 자동으로 정한 20초 구간별로 집계한 결과. 차트를 원본 크기로 보기 (새 탭에서 열림) 주문이 가장 많은 구간 찾기
자동으로 정한 계급의 폭은 20초입니다. 140–160초 구간에 주문이 가장 많으며, 90건 중 15건입니다. 기록된 최단 시간은 59.9초, 최장 시간은 252.5초입니다.
집단 구성 고려
이 막대들은 세 포장 구역의 데이터를 합친 것입니다. 서로 다른 주문과 작업량이 분포 모양에 함께 반영됩니다. 측정값을 바꾸지 않고도 계급을 변경하면 모양이 달라질 수 있습니다.
다음 비교 선택
포장 구역별 상자그림 가이드로 구역을 비교할 수 있습니다. 인력 배치를 바꾸기 전에 품목 수가 비슷한 주문을 비교하고, 모든 계급과 데이터 요약을 확인합니다. 데이터를 합친 이 히스토그램은 주문에 시간이 더 걸린 이유를 설명하지는 않습니다.
자세히 보기: 각 결과 섹션 읽기
전체 결과 표는 Help와 동일하게 유효숫자 여섯 자리로 표시합니다.
사용한 데이터
워크시트 행 수는 90, 전체 계열의 분석 대상 관측값 수는 90, 제외한 관측값 수는 0입니다. 원본의 모든 행을 사용합니다. 실행 결과를 비교할 때는 이 개수를 확인하고 예제의 열 지정을 유지합니다. 워크시트 정렬과 필터는 분석에 사용하는 표본을 바꾸지 않습니다.
저장된 모든 행을 원래 순서대로 검토합니다. 워크시트 정렬과 필터는 분석에 사용하는 표본을 바꾸지 않습니다.
| 워크시트 행 수 | 전체 계열의 분석 대상 관측값 수 | 제외한 관측값 수 |
|---|---|---|
| 90 | 90 | 0 |
데이터 요약
계열은 측정 항목이나 집단을 나타냅니다. 유효값과 결측값은 개수이며, 평균과 중앙값은 중심을 설명합니다. 표본 표준편차(SD)는 산포를 설명합니다. 최솟값과 최댓값은 관측된 양 끝값이며, Q1과 Q3 사이에는 가운데 절반이 들어 있습니다. 이 요약은 기록된 관측값을 설명하며, 합격 판정 한계가 아닙니다.
| 계열 | 유효값 수 | 결측값 수 | 평균 | 표본 표준편차 | 최솟값 | Q1 | 중앙값 | Q3 | 최댓값 |
|---|---|---|---|---|---|---|---|---|---|
| packing_time_s | 90 | 0 | 150.572 | 45.2425 | 59.9 | 115.125 | 152.9 | 184.675 | 252.5 |
히스토그램 계급
각 구간의 하단 경계, 상단 경계, 개수를 모두 확인합니다. 이 도수 차트에서 도수는 막대의 높이이며 개수와 같습니다. 11개 계급의 개수 합계는 90입니다. 이 예제에서는 자동 계급 설정으로 20초 구간을 선택했습니다.
| 계열 | 하단 경계 | 상단 경계 | 개수 | 도수 |
|---|---|---|---|---|
| packing_time_s | 40 | 60 | 1 | 1 |
| packing_time_s | 60 | 80 | 4 | 4 |
| packing_time_s | 80 | 100 | 8 | 8 |
| packing_time_s | 100 | 120 | 14 | 14 |
| packing_time_s | 120 | 140 | 10 | 10 |
| packing_time_s | 140 | 160 | 15 | 15 |
| packing_time_s | 160 | 180 | 11 | 11 |
| packing_time_s | 180 | 200 | 12 | 12 |
| packing_time_s | 200 | 220 | 10 | 10 |
| packing_time_s | 220 | 240 | 4 | 4 |
| packing_time_s | 240 | 260 | 1 | 1 |
7. 보고서 만들기
앱 원본 차트와 Data used, Data summary, Histogram bins를 함께 남깁니다. 열 지정과 차트 옵션을 기록합니다. 분석의 배경과 특이한 관측값에 대해 확인한 내용을 포함합니다. 차트의 단위와 단계별 해석에서 설명한 한계를 함께 남깁니다.
완료된 실행 결과에서 Add to report 항목을 선택합니다. 표와 차트를 선택하려면 Choose individual items and advanced options 항목을 엽니다. 그런 다음 Add to draft 항목을 선택합니다. 숨긴 항목은 저장된 분석에 남아 있습니다.
보고서 이름을 정하고 분석 목적과 해석을 추가합니다. Save 항목을 선택하고 Preview에서 내용을 확인한 뒤 Export → Download HTML을 사용합니다. 아래 예시는 한 화면에 다 보이지 않는 결과까지 포함하여 선택한 콘텐츠 전체를 보여 줍니다.