

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: napełnienia butelek poniżej 245 mL
Załóż normalny rozkład napełnienia butelek ze średnią 250 mL i odchyleniem standardowym 2.5 mL. Są to podane parametry modelu, a nie oszacowania dopasowane przez ten kalkulator.
Pobierz zestawienie scenariuszy (CSV, język angielski)To ten sam przykład, który znajduje się w Help. CSV zawiera scenariusze referencyjne. Wprowadź wybrany scenariusz ręcznie na karcie Inputs; import nie konfiguruje tego kalkulatora. Użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Normal Distribution Plot. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Wprowadź rozkład
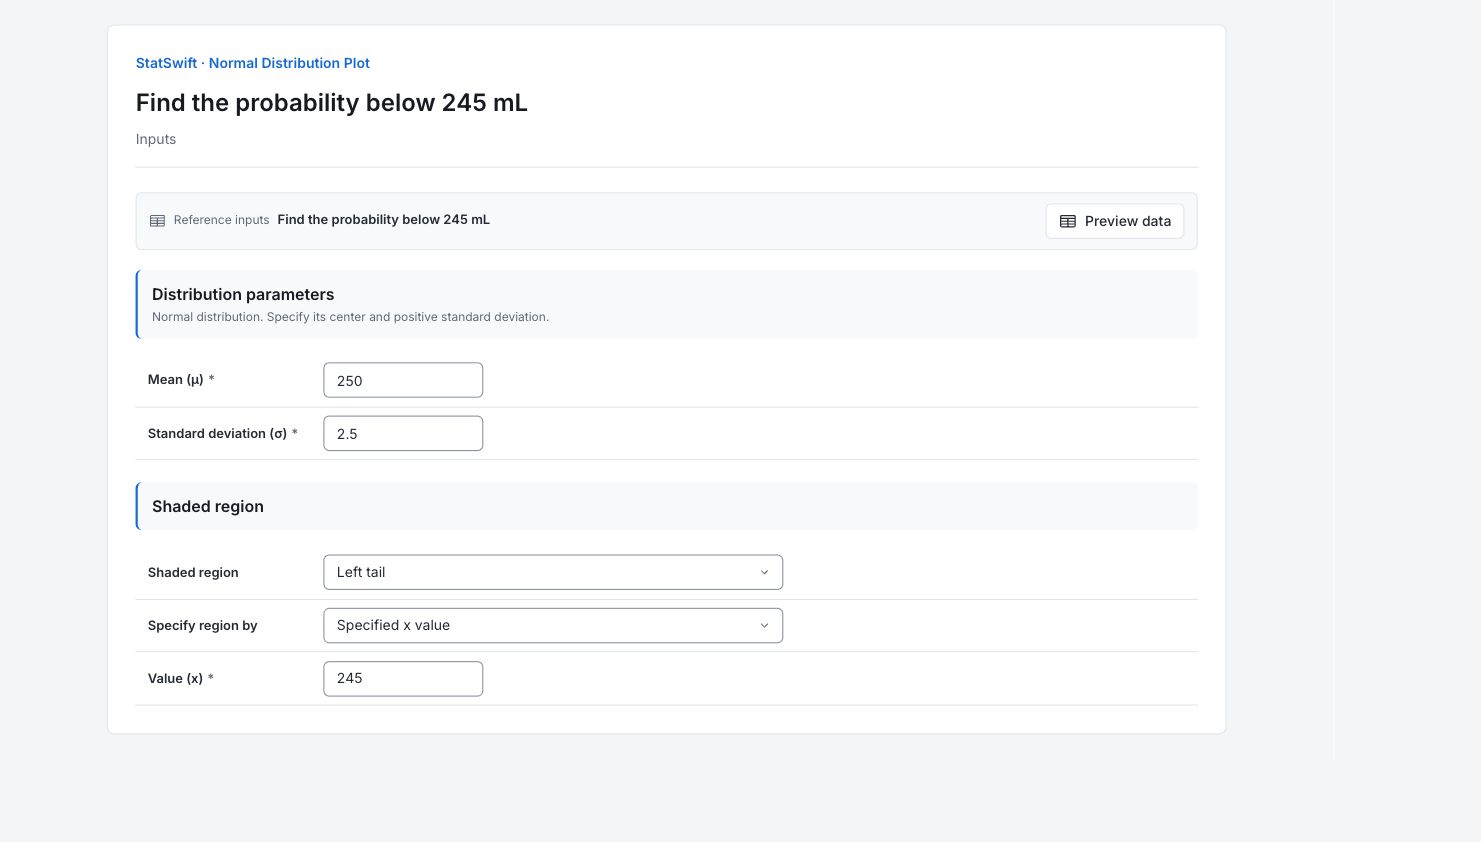
Na karcie Inputs wpisz 250 w Mean (μ) i 2.5 w Standard deviation (σ), oba w mL.
3. Wybierz zacieniowany obszar
Wybierz Left tail w Shaded region i Specified x value w Specify region by. Wpisz 245 w Value (x). Nie przypisuje się kolumn arkusza.
4. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
5. Zinterpretuj wyniki
Sprawdź założony model
Załóż normalny rozkład napełnienia butelek ze średnią 250 mL i odchyleniem standardowym 2.5 mL. Są to podane parametry modelu, a nie oszacowania dopasowane przez ten kalkulator.
Odczytaj zacieniowane pole
Zacieniowane pole na lewo od 245 mL wynosi 0.0227501, czyli około 2.275%. To modelowe prawdopodobieństwo napełnienia butelki poniżej 245 mL.

Modelowy udział poniżej 245 mL przy rozkładzie normalnym ze średnią 250 mL i SD 2.5 mL. Wykres pozostaje w języku angielskim. Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Zachowaj poprawną interpretację
Wysokość krzywej oznacza gęstość. Prawdopodobieństwo to zacieniowane pole, a nie wysokość przy 245 mL.
Zastosuj wynik do pytania
Porównaj modelowy ogon ze zdefiniowanym wymaganiem napełnienia. Sprawdź reprezentatywne pomiary napełnienia, zanim potraktujesz to modelowe prawdopodobieństwo jako rzeczywisty udział niedopełnień.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Podsumowanie rozkładu normalnego
Średnia μ określa środek; odchylenie standardowe σ określa rozrzut w mL. Zacieniowany obszar wskazuje wybrane pole. Dane obszaru określają, czy wprowadzono wartość, czy prawdopodobieństwo. Zacieniowane prawdopodobieństwo to pole pod krzywą; granica x1 i, jeśli pokazano, granica x2 wyznaczają jego krańce w mL. Wysokość krzywej oznacza gęstość. Prawdopodobieństwo to zacieniowane pole, a nie wysokość przy 245 mL.
| Statystyka | Wartość |
|---|---|
| Średnia μ | 250 |
| Odchylenie standardowe σ | 2.5 |
| Zacieniowany obszar | left |
| Dane wejściowe obszaru | x |
| Prawdopodobieństwo obszaru | 0.0227501 |
| Granica x1 | 245 |
- Cieniowanie obejmuje ±4σ, chyba że żądany obszar leży dalej.
6. Utwórz raport
Zachowaj razem Normal distribution plot i Normal distribution summary. Zapisz podaną średnią i SD, wybrany obszar, dane wejściowe i otrzymane prawdopodobieństwo lub granicę. Wysokość krzywej oznacza gęstość. Prawdopodobieństwo to zacieniowane pole, a nie wysokość przy 245 mL. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.