

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : force de compression des matériaux de calage
64 éprouvettes indépendantes : 32 de chaque matériau de calage.
Télécharger les données d’exemple (CSV en anglais)C’est le même exemple que dans Help. Importez le CSV pour suivre les étapes ou utilisez Open example in a practice copy dans Help pour préremplir les données d’entrée.
1. Créer l’espace de travail
Dans la barre latérale, ouvrez Basic Statistics et choisissez Means: Two-Sample (t). Créez une analyse, nommez-la, sélectionnez New blank worksheet, puis choisissez Create analysis.
2. Importer les données d’exemple
Téléchargez le CSV ci-dessus et importez-le dans la feuille de données. Choisissez Comma comme délimiteur, Dot comme séparateur décimal et First row contains column names.
3. Affecter les colonnes d’entrée
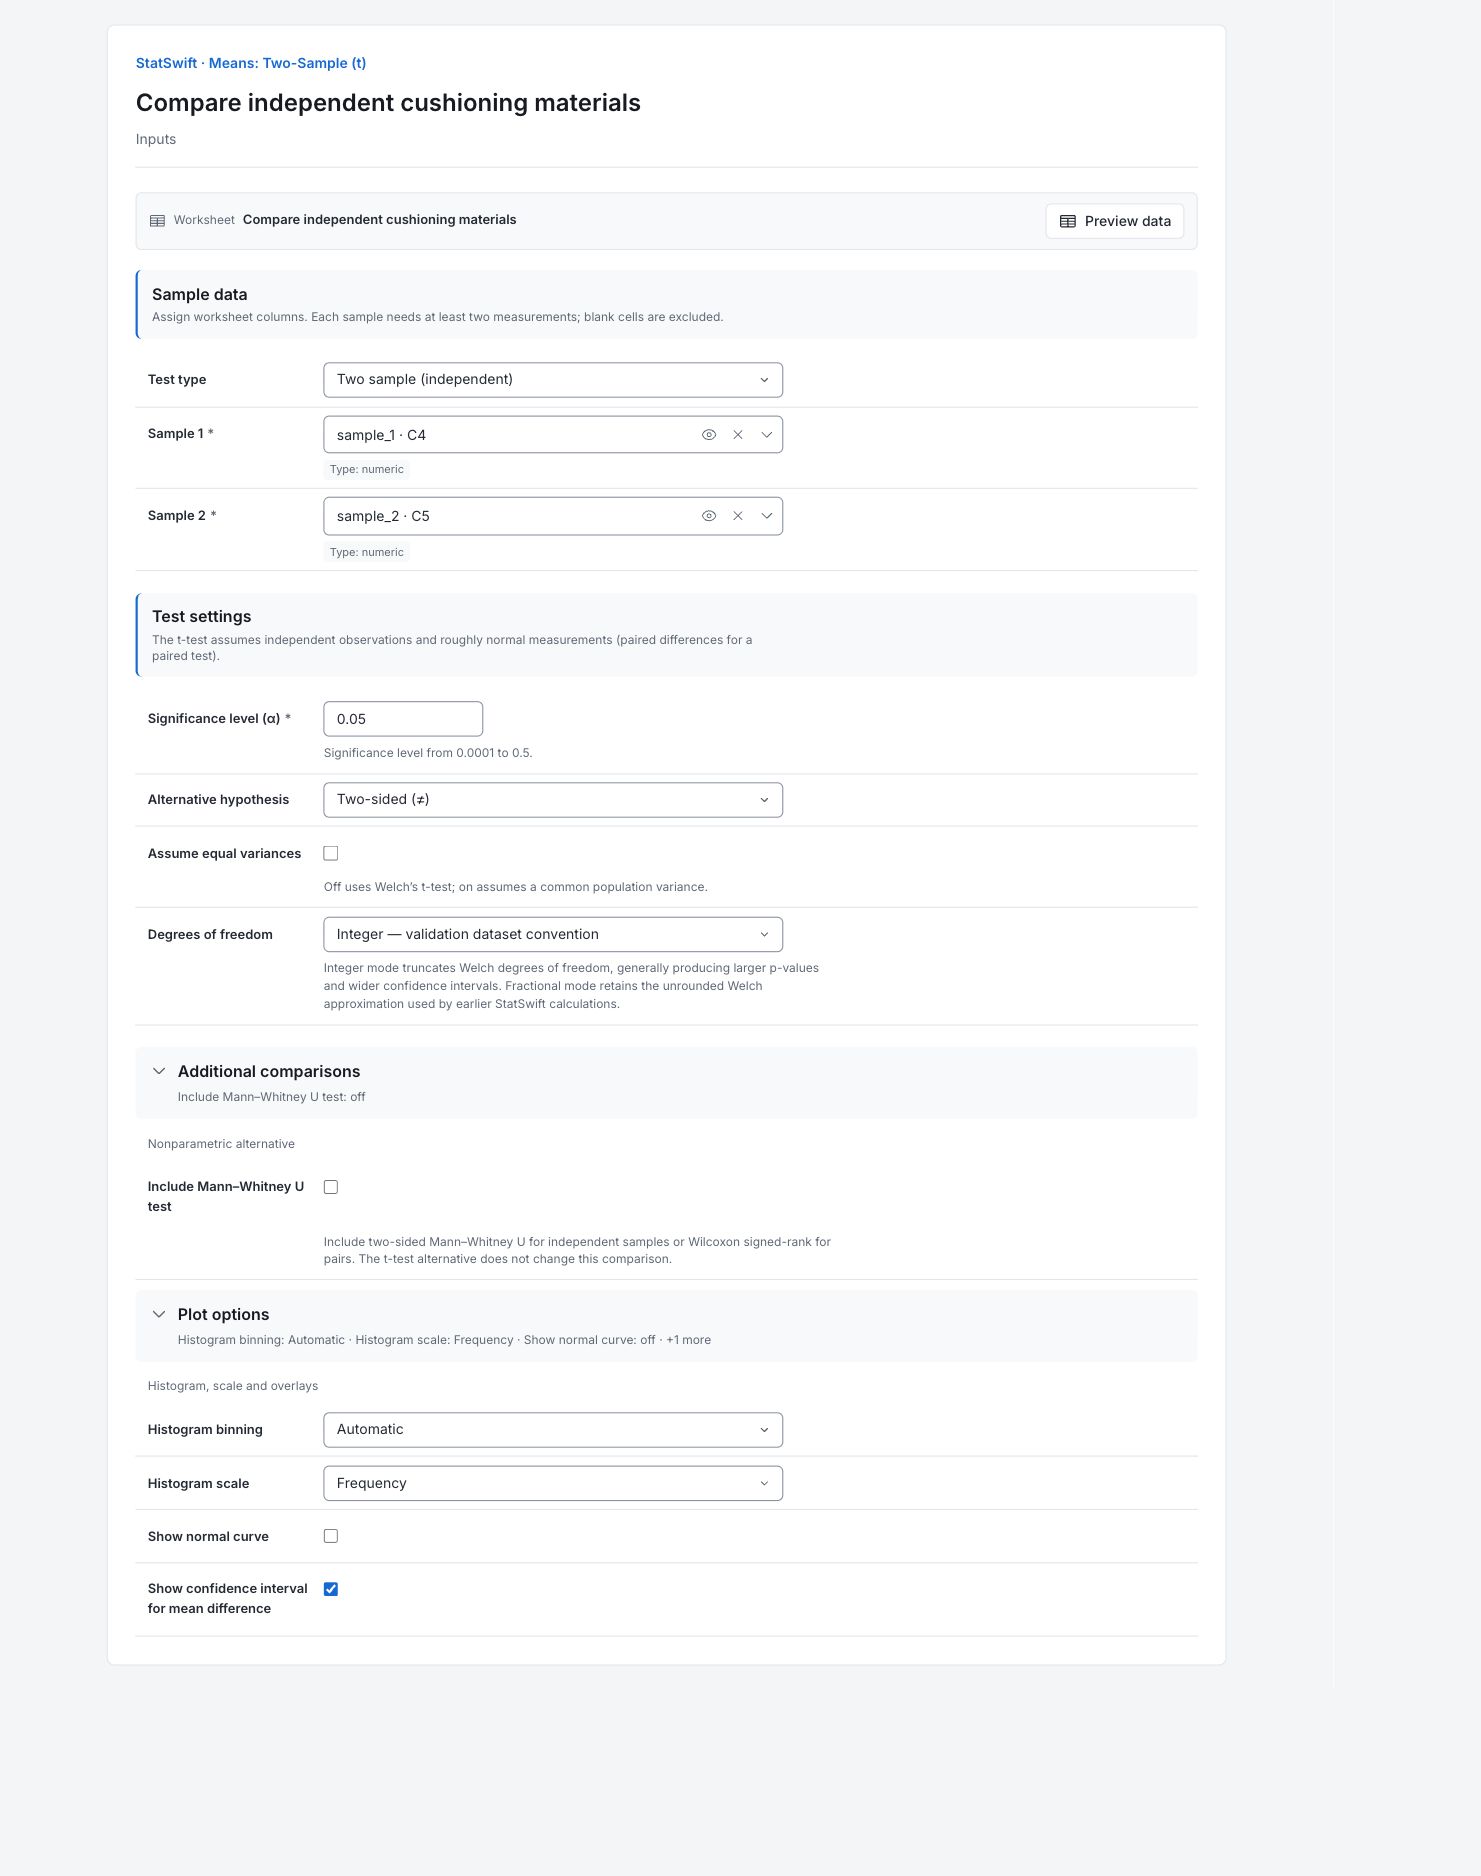
Dans Inputs, choisissez Two sample (independent) pour Test type. Affectez sample_1 à Sample 1 et sample_2 à Sample 2. Ces colonnes contiennent respectivement Foam A et Foam B. Les éprouvettes sont indépendantes ; partager une ligne de feuille ne crée pas une paire. Les cellules vides hors de chaque échantillon de 32 éprouvettes sont intentionnelles, et non des lectures appariées manquantes.
4. Définir le test et les graphiques
Saisissez 0.05 dans Significance level (α) et choisissez Two-sided (≠) pour Alternative hypothesis. Laissez Assume equal variances décoché. Choisissez Integer — validation dataset convention pour Degrees of freedom afin de reproduire ce résultat de Welch. Cela arrondit 56.3241 à l’entier inférieur 56. Ouvrez Additional comparisons et laissez Include Mann–Whitney U test décoché.
Ouvrez Plot options. Réglez Histogram binning sur Automatic et Histogram scale sur Frequency. Laissez Show normal curve décoché et cochez Show confidence interval for mean difference.
5. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
6. Interpréter les résultats
Identifier les échantillons indépendants
Chaque matériau est représenté par 32 éprouvettes distinctes. L’échantillon 1 est Foam A et l’échantillon 2 Foam B. La comparaison porte sur leurs forces moyennes de compression de population, avec le test de Welch.
Lire la différence et l’intervalle
Foam A moins Foam B vaut en moyenne 5.625 N. L’intervalle à 95% est de −0.901–12.151 N et contient zéro ; p = 0.08975. Au seuil de 5%, l’étude n’établit pas de différence. Elle n’établit pas non plus l’équivalence. Cet exemple utilise 56 degrés de liberté entiers.

Intervalle de confiance de la différence Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Comparer les formes des échantillons
Les boîtes montrent la moitié centrale de chaque échantillon, avec la médiane à l’intérieur. Les moustaches et les signalements par barrières décrivent les observations, et non des limites d’acceptation. Foam B a un écart-type d’échantillon plus grand : environ 14.96 N contre 10.77 N pour Foam A.

Boîtes à moustaches des échantillons Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Lire l’histogramme
La hauteur des barres compte les mesures dans des intervalles de valeurs. Comparez la forme et la dispersion sans traiter les barres comme des limites de confiance. L’indépendance vient de l’utilisation d’éprouvettes différentes, et non de ce graphique.

Histogramme des échantillons Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Déterminer ce que le résultat étaye
Comparez l’intervalle complet de différence à l’amélioration nécessaire pour décider du matériau de calage. Des données supplémentaires peuvent être utiles si cet intervalle est trop large ; p supérieur à 0.05 ne prouve pas une performance égale.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Test t à deux échantillons
La différence de moyenne est échantillon 1 moins échantillon 2 ; l’erreur-type mesure son incertitude. La statistique t est la différence divisée par l’erreur-type. Les degrés de liberté, alpha, l’hypothèse alternative, la méthode et le niveau de confiance documentent l’inférence. Les bornes de l’IC délimitent la différence de moyennes de population. La convention des degrés de liberté indique Welch entier. Les degrés de liberté de Welch non arrondis sont 56.3241 ; ceux utilisés sont 56. Ce réglage influe sur les valeurs p et la largeur de l’intervalle.
| Statistique | Valeur |
|---|---|
| Statistique t | 1.72662 |
| Degrés de liberté | 56 |
| Convention des degrés de liberté | Entier — convention du jeu de données de validation |
| Degrés de liberté de Welch non arrondis | 56.3241 |
| Degrés de liberté utilisés | 56 |
| Valeur p | 0.0897498 |
| Différence de moyenne | 5.625 |
| Erreur-type | 3.25782 |
| α | 0.05 |
| Hypothèse alternative | two-sided |
| Méthode | Test t de Welch |
| Niveau de confiance (%) | 95 |
| Borne inférieure de l’IC | -0.90119 |
| Borne supérieure de l’IC | 12.1512 |
- Ne pas rejeter H₀ (μ₁ − μ₂ = 0) à α=0.05 (p=0.0897)
- H₀: μ₁ − μ₂ = 0
- H₁: μ₁ − μ₂ ≠ 0
Résumés des échantillons
n compte les lectures ; la moyenne, la médiane, le minimum, le maximum et l’étendue décrivent chaque échantillon. L’écart-type est la dispersion de l’échantillon, SE l’incertitude de sa moyenne et l’IQR la dispersion de la moitié centrale. Chaque matériau est représenté par 32 éprouvettes indépendantes.
| Échantillon | n | Moyenne | Écart-type | SE | Médiane | Minimum | Maximum | Étendue | IQR |
|---|---|---|---|---|---|---|---|---|---|
| Échantillon 1 | 32 | 184.925 | 10.766 | 1.90318 | 185.15 | 168.4 | 209.2 | 40.8 | 16.9 |
| Échantillon 2 | 32 | 179.3 | 14.9573 | 2.6441 | 178.2 | 145.7 | 211.7 | 66 | 20.9 |
Coordonnées des boîtes à moustaches
Q1 et Q3 encadrent la moitié centrale, avec la médiane entre eux. L’IQR est Q3 moins Q1. Les barrières inférieure et supérieure utilisent 1.5 × IQR ; les moustaches se terminent aux observations extrêmes comprises entre les barrières. Ces coordonnées ne sont pas des limites d’acceptation.
| Échantillon | Q1 | Médiane | Q3 | IQR | Barrière inférieure | Barrière supérieure | Moustache inférieure | Moustache supérieure |
|---|---|---|---|---|---|---|---|---|
| Échantillon 1 | 175.85 | 185.15 | 192.75 | 16.9 | 150.5 | 218.1 | 168.4 | 209.2 |
| Échantillon 2 | 170.275 | 178.2 | 191.175 | 20.9 | 138.925 | 222.525 | 145.7 | 211.7 |
Signalements de la boîte à moustaches
Chaque ligne identifierait un échantillon, une ligne de feuille et une valeur au-delà d’une barrière. Ce tableau vide signifie qu’aucun des échantillons n’a de signalement par barrière. Un signalement appellerait une investigation, et non une suppression automatique.
| Échantillon | Ligne de la feuille | Valeur |
|---|
Aucune ligne n’a été renvoyée pour cette section.
7. Créer un rapport
Conservez Two-sample t-test complet, Sample summaries, les coordonnées et les signalements des boîtes à moustaches, l’intervalle de différence, les boîtes à moustaches et l’histogramme. Précisez échantillon 1 moins échantillon 2 et la convention entière des degrés de liberté de Welch.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.