

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: rodzaj usługi przewozowej i stan przesyłki przy dostawie
Tabela obserwowanych liczebności 3 x 3 reprezentuje 600 różnych przesyłek.
Pobierz przykładowe dane (CSV, po angielsku)To ten sam przykład, którego użyto w sekcji Help. Zaimportuj plik CSV, aby wykonać opisane kroki, albo wybierz Open example in a practice copy w Help, aby automatycznie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Categorical: Independence (χ²). Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Zaimportuj przykładowe dane
Pobierz powyższy plik CSV i zaimportuj go do arkusza. Jako separator wybierz Comma, jako separator dziesiętny Dot i zaznacz First row contains column names.
3. Przypisz kolumny liczebności
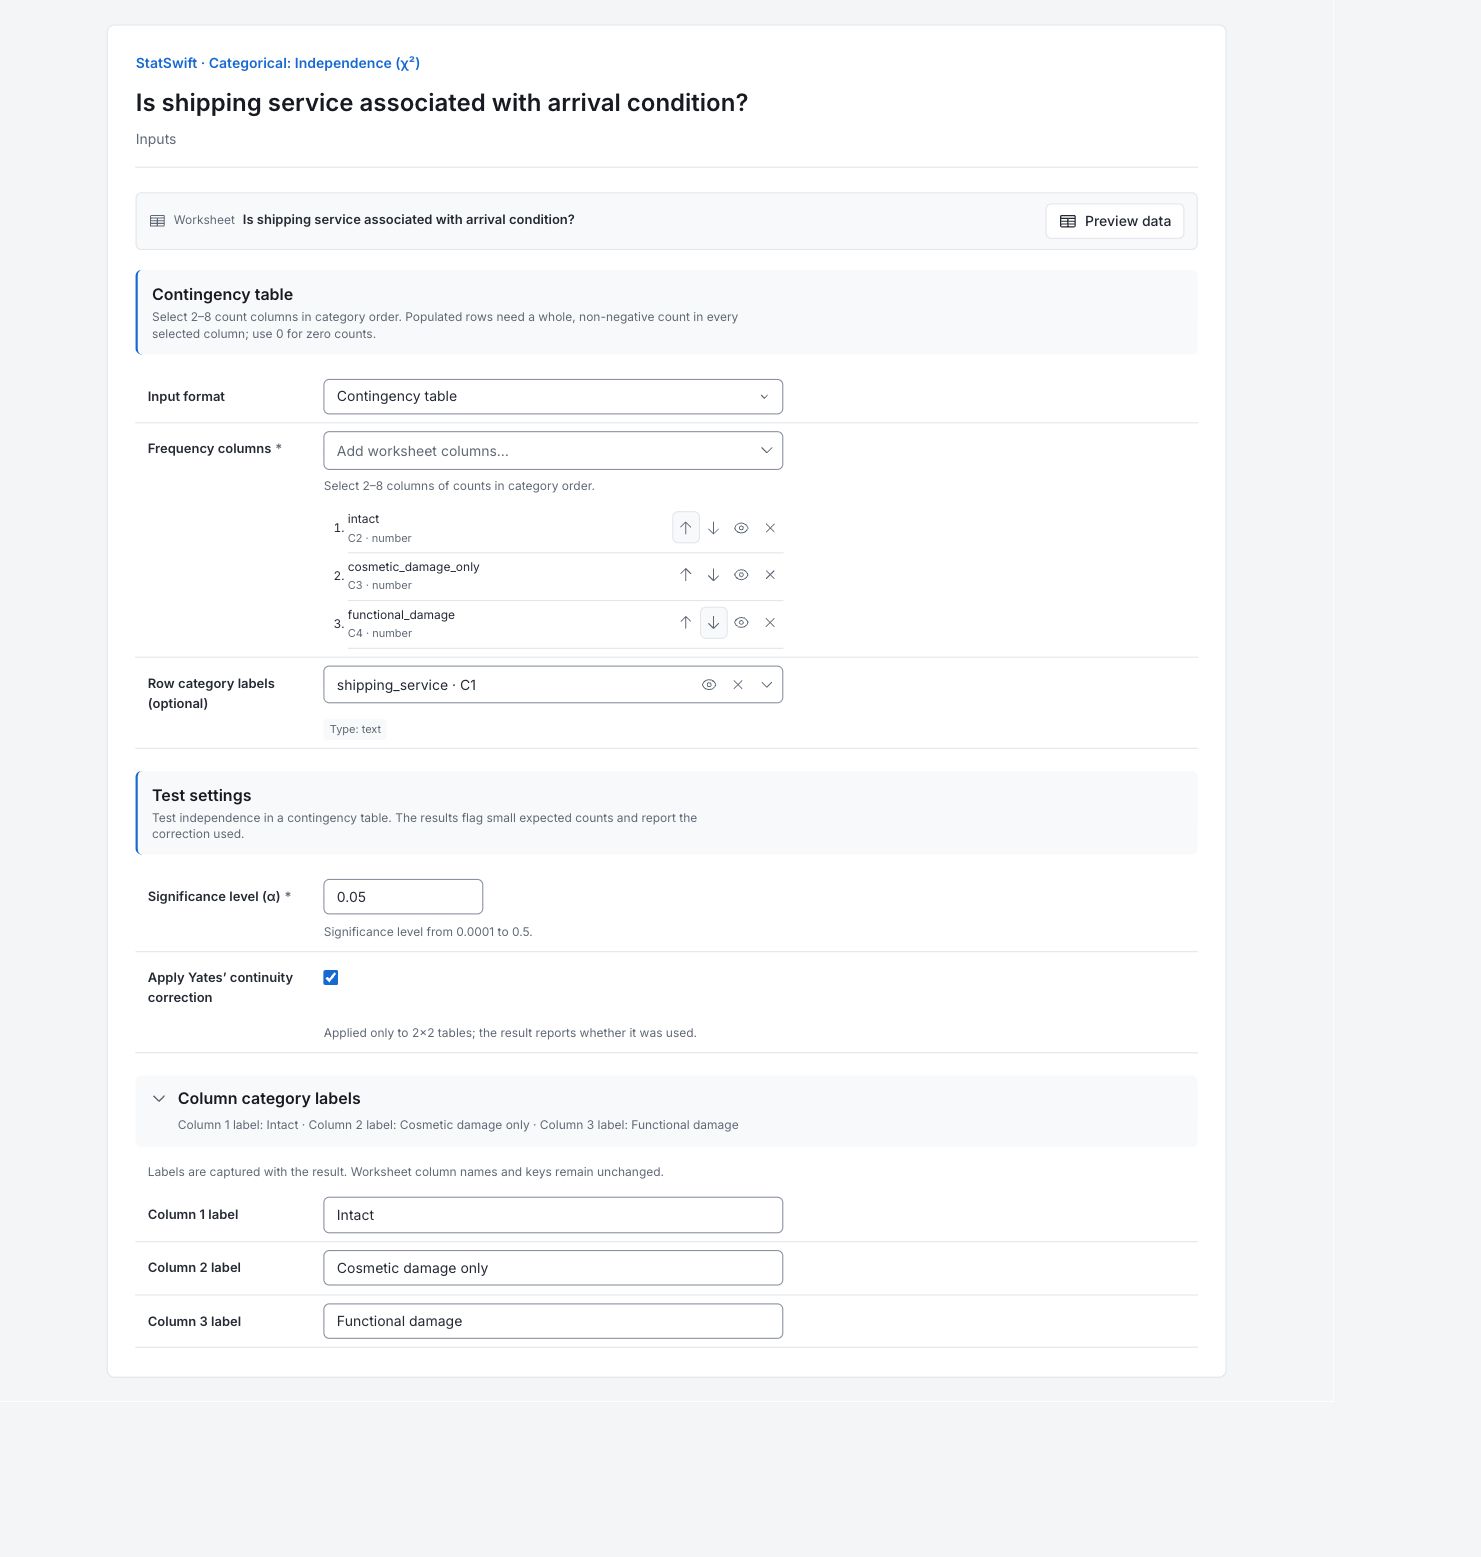
Na karcie Inputs ustaw Input format na Contingency table. Otwórz Frequency columns i wybierz kolejno intact, cosmetic_damage_only oraz functional_damage. Przypisz shipping_service do Row category labels (optional). Plik CSV zawiera już tabelę liczebności; nie traktuj każdego jej wiersza jako jednej przesyłki.
4. Ustaw test i etykiety kategorii
Wpisz 0.05 w Significance level (α) i zaznacz Apply Yates’ continuity correction. Otwórz Column category labels. Wpisz Intact w Column 1 label, Cosmetic damage only w Column 2 label, a Functional damage w Column 3 label. Zachowaj zaznaczenie, aby odtworzyć zapisany przykład. Nie wpływa ono na tę tabelę 3×3: poprawka Yatesa dotyczy wyłącznie tabel 2×2.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Odczytaj obserwowane liczebności
Trzy wiersze usług i trzy kolumny stanu przesyłki reprezentują 600 różnych przesyłek. Każda przesyłka należy do jednej usługi i jednej rozłącznej kategorii stanu przy dostawie. Na przykład Consolidated obejmuje 160 przesyłek nienaruszonych, 38 wyłącznie z uszkodzeniem kosmetycznym i 22 z uszkodzeniem funkcjonalnym.
Odczytaj test zależności
χ² wynosi 11.2614 przy 4 stopniach swobody; p = 0.02378. Na poziomie 5% istnieją podstawy do stwierdzenia zależności. Najmniejsza oczekiwana liczebność wynosi 14.7 i żadna nie jest mniejsza niż 5. Dla tej tabeli 3×3 nie zastosowano poprawki Yatesa.
Porównaj liczebności obserwowane i oczekiwane
Liczebności oczekiwane wynikają z obserwowanych sum dla usług i stanów przesyłki przy założeniu niezależności. Dla wyłącznie kosmetycznych uszkodzeń w Consolidated zaobserwowano 38 przesyłek wobec 27.867 oczekiwanych. Liczebności oczekiwane tworzą model porównawczy, a nie cele jakościowe klienta.
Zlokalizuj największe różnice
Reszta dla uszkodzeń wyłącznie kosmetycznych w Consolidated wynosi około +1.92, a w Express około −1.84. Znak dodatni oznacza liczebność większą od oczekiwanej, a ujemny — mniejszą. Uszkodzenia wyłącznie kosmetyczne dotyczą 38/220 przesyłek Consolidated (17.3%) wobec 14/180 przesyłek Express (7.8%). Te komórki nie są osobnymi testami z korektą.
Zbadaj okoliczności przed zmianą zasad
Porównaj asortyment, opakowania i warunki przewozu między usługami. Ta zależność obserwacyjna nie dowodzi, że wybór usługi powoduje uszkodzenia.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Test niezależności chi-kwadrat
χ² podsumowuje różnice między liczebnościami obserwowanymi i oczekiwanymi. Degrees of freedom wynosi 4, a p-value dotyczy niezależności. Alpha wynosi 0.05. Wiersze Requested i Used Yates odróżniają wybrane ustawienie od faktycznie zastosowanej poprawki. Kontrole liczebności oczekiwanych opisują poprawność przybliżenia; tutaj każda z nich wynosi co najmniej 14.7.
| Statystyka | Wartość |
|---|---|
| Statystyka χ² | 11.2614 |
| Stopnie swobody | 4 |
| wartość p | 0.0237781 |
| Alfa | 0.05 |
| Żądana poprawka Yatesa | true |
| Zastosowana poprawka Yatesa | false |
| Czy występuje liczebność oczekiwana poniżej 5 | false |
| Komórki z liczebnością oczekiwaną poniżej 5 | 0 |
| Najmniejsza liczebność oczekiwana | 14.7 |
- Wyniki wskazują na zależność (p=0.0238).
Liczebności obserwowane
Każdy wiersz usługi zawiera obserwowane liczebności trzech rozłącznych kategorii stanu przesyłki. Pokazano wszystkie dziewięć komórek, których suma wynosi 600 przesyłek. Porównuj udziały względem sumy dla danej usługi, a nie wyłącznie surowe liczby uszkodzeń.
| Kategoria wiersza | Bez uszkodzeń | Tylko uszkodzenia wizualne | Uszkodzenie funkcjonalne |
|---|---|---|---|
| Standard | 160 | 24 | 16 |
| Express | 155 | 14 | 11 |
| Consolidated | 160 | 38 | 22 |
Liczebności oczekiwane
Przy niezależności liczebność oczekiwana = suma dla usługi × suma dla stanu / 600. Wartości dziesiętne są liczebnościami modelowymi, a nie dodatkowymi przesyłkami ani progami akceptacji. Porównuj każdą komórkę z odpowiadającą jej komórką liczebności obserwowanych.
| Kategoria wiersza | Bez uszkodzeń | Tylko uszkodzenia wizualne | Uszkodzenie funkcjonalne |
|---|---|---|---|
| Standard | 158.333 | 25.3333 | 16.3333 |
| Express | 142.5 | 22.8 | 14.7 |
| Consolidated | 174.167 | 27.8667 | 17.9667 |
Reszty standaryzowane
Każda reszta to (liczebność obserwowana − oczekiwana) / pierwiastek kwadratowy z liczebności oczekiwanej. Znak wskazuje nadwyżkę lub niedobór, a wielkość pomaga znaleźć źródła ogólnej zależności. Nie są to osobne testy komórek z korektą na wielokrotne porównania.
| Kategoria wiersza | Bez uszkodzeń | Tylko uszkodzenia wizualne | Uszkodzenie funkcjonalne |
|---|---|---|---|
| Standard | 0.132453 | -0.264906 | -0.0824786 |
| Express | 1.04713 | -1.84296 | -0.965035 |
| Consolidated | -1.07346 | 1.9196 | 0.951547 |
7. Utwórz raport
Zachowaj Chi-square independence test, wszystkie Observed counts, Expected counts i Standardized residuals, definicje kategorii oraz kontrole liczebności oczekiwanych. Zaznacz, że poprawka Yatesa była wybrana, lecz nie została użyta, oraz że zależność nie dowodzi przyczyny.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.