

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: 小袋充填量のサンプルサイズ
基準平均から2 gの差を検出するため、標準偏差(SD)を4 gと仮定し、検出力90%を目標として、独立した小袋充填量の測定を計画します。
計画の参照データをダウンロード(CSV、列名は英語)Help で使用している例と同じです。CSVには参照用のシナリオが記載されています。選んだ計画用の値を Inputs に手入力します。CSVをインポートしても、この計算ツールは設定されません。Helpの Open example in a practice copy を使用すると、入力値をあらかじめ設定できます。
1. ワークスペースを作成
サイドバーで Basic Statistics を開き、Power & Sample Size を選択します。分析を作成して名前を付け、New blank worksheet を選択してから Create analysis を選択します。
2. 調査を選択
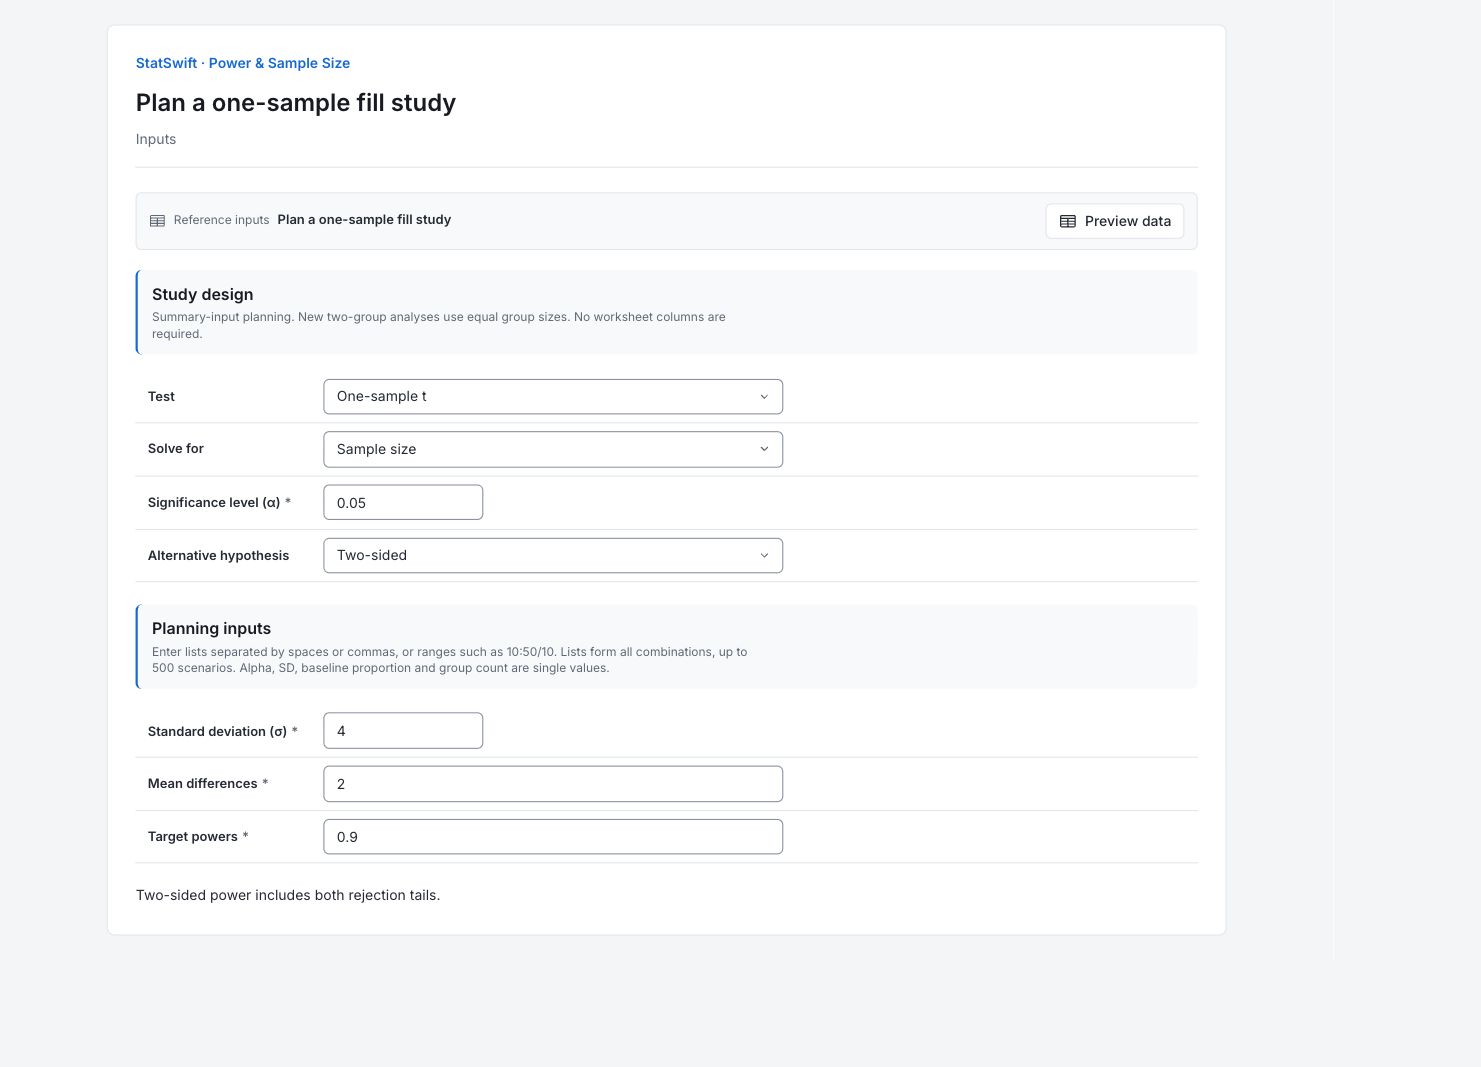
Inputs で、Test に One-sample t、Solve for に Sample size を選択します。Significance level (α) に 0.05 を入力し、Alternative hypothesis で Two-sided を選択します。
3. 計画用の値を入力
このシナリオでは、各項目に一つの値を入力します。ワークシートの列は割り当てません。
Standard deviation (σ) に 4 を入力します。
Mean differences に 2 を入力します。
Target powers に 0.9 を入力します。
4. 分析を実行
Run analysis を選択し、Results を開きます。
5. 結果を解釈
計画した調査を確認
基準平均から2 gの差を検出するため、標準偏差(SD)を4 gと仮定し、検出力90%を目標として、独立した小袋充填量の測定を計画します。
計算された計画を確認
計画上の最小サンプルサイズは44袋です。計算された検出力は0.900031で、目標の0.9をわずかに上回ります。43袋の場合、検出力は0.893050です。
検出力曲線を確認
曲線は観測数を44個として計算しています。差が+2 gまたは−2 gのとき、検出力は約90%です。ゼロに近い小さな差は検出しにくくなります。

英語のグラフ:効果に対する検出力。 グラフを原寸で表示 (新しいタブで開きます) 前提を理解する
検出力とは、入力した前提のもとで指定した差が実際に存在するときに、計画した検定がその差を検出する確率です。仮説が正しい確率ではなく、有意な結果を保証するものでもありません。この方法は、互いに独立で正規分布に従う観測値と、母標準偏差(SD)が4 gという仮定のもとで、一標本の非心t分布に基づいて計算します。ここでは、基準平均自体を第二の標本から推定するわけではありません。
標本の収集方法を決める
2 gが検出する価値のある最小の差であることと、4 gが計画用の標準偏差(SD)として妥当であることを確認します。収集する小袋の数を決める際は、使用できない測定値が生じることも見込みます。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
検出力とサンプルサイズのシナリオ
「シナリオ」は行と入力値を対応させます。「分岐」は求めた効果の方向を記録し、ダッシュは該当しないことを示します。二群の計画では「サンプルサイズ」は各群の数で、「総観測数」は両群の合計です。「平均差」または「比較対象の比率」は、計画で想定する効果です。「目標検出力」は要求値で、「計算された検出力」は計算結果です。「一つ小さいサンプルサイズでの検出力」は、各群の観測数を一つ減らした場合を確認します。DFは、該当する場合のt検定の自由度です。「計算状況」と「詳細」は、シナリオを計算できたかどうかを記録します。計画上の最小サンプルサイズは44袋です。計算された検出力は0.900031で、目標の0.9をわずかに上回ります。43袋の場合、検出力は0.893050です。
| シナリオ | 分岐 | サンプルサイズ | 総観測数 | 平均差 | 目標検出力 | 計算された検出力 | 一つ小さいサンプルサイズでの検出力 | 自由度(DF) | 計算状況 | 詳細 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 44 | 44 | 2 | 0.9 | 0.900031 | 0.89305 | 43 | ok | — |
- 求められない分岐も、計算状況と入力値を残します。ペアはそれぞれ二つの観測値として数えます。直前のサンプルサイズでの検出力は、そのサイズが有効な場合にのみ表示します。
計画の計算方法
「方法」と「計算方式の識別子」は、使用した計算を特定します。αの0.05は検定の有意水準で、「対立仮説」の両側は両方向を含みます。「求める量」は計算対象を示します。「仮定」と「計画用標準偏差(SD)」または「基準比率」は、結果が依存する前提を記録します。この方法は、互いに独立で正規分布に従う観測値と、母標準偏差(SD)が4 gという仮定のもとで、一標本の非心t分布に基づいて計算します。ここでは、基準平均自体を第二の標本から推定するわけではありません。
| 設定 | 値 |
|---|---|
| 方法 | 一標本t検定 |
| 計算方式の識別子 | noncentral-t-v1 |
| α | 0.05 |
| 対立仮説 | two-sided |
| 求める量 | サンプルサイズ |
| 仮定 | 独立な正規分布の観測値。母標準偏差は推定値を使用します。 |
| 計画用標準偏差(SD) | 4 |
- 結果と曲線上の点は、この実行時に記録されています。サンプルサイズは整数であり、目標検出力と計算された検出力は区別します。
シナリオの入力値
「シナリオ」は結果の行番号に対応します。「入力値」は適用したシナリオの値を記録します。これらは計画上の仮定であり、観測された測定値ではありません。この例では、各項目に一つの値を入力して、一つのシナリオを作成しています。
| シナリオ | 入力値 |
|---|---|
| 1 | {"delta":2,"power":0.9} |
記録された検出力曲線の値
各行は、サンプルサイズ、平均差または比較対象の比率、その計算上の検出力を示します。グラフの元となる記録値をすべて含みます。二群の計画では、サンプルサイズは各群の数です。検出力はゼロから一の範囲で読み、0.9は90%を意味します。曲線は観測数を44個として計算しています。差が+2 gまたは−2 gのとき、検出力は約90%です。ゼロに近い小さな差は検出しにくくなります。
| サンプルサイズ | 平均差 | 検出力 |
|---|---|---|
| 44 | -2.5 | 0.981762 |
| 44 | -2.41667 | 0.974804 |
| 44 | -2.33333 | 0.965746 |
| 44 | -2.25 | 0.954168 |
| 44 | -2.16667 | 0.939633 |
| 44 | -2.08333 | 0.921717 |
| 44 | -2 | 0.900031 |
| 44 | -1.91667 | 0.874253 |
| 44 | -1.83333 | 0.844165 |
| 44 | -1.75 | 0.80968 |
| 44 | -1.66667 | 0.770866 |
| 44 | -1.58333 | 0.727969 |
| 44 | -1.5 | 0.681415 |
| 44 | -1.41667 | 0.631805 |
| 44 | -1.33333 | 0.579891 |
| 44 | -1.25 | 0.526551 |
| 44 | -1.16667 | 0.472738 |
| 44 | -1.08333 | 0.419435 |
| 44 | -1 | 0.367602 |
| 44 | -0.916667 | 0.318127 |
| 44 | -0.833333 | 0.271787 |
| 44 | -0.75 | 0.229213 |
| 44 | -0.666667 | 0.19088 |
| 44 | -0.583333 | 0.157098 |
| 44 | -0.5 | 0.128031 |
| 44 | -0.416667 | 0.103714 |
| 44 | -0.333333 | 0.0840861 |
| 44 | -0.25 | 0.0690308 |
| 44 | -0.166667 | 0.058409 |
| 44 | -0.0833333 | 0.0520945 |
| 44 | 0 | 0.05 |
| 44 | 0.0833333 | 0.0520945 |
| 44 | 0.166667 | 0.058409 |
| 44 | 0.25 | 0.0690308 |
| 44 | 0.333333 | 0.0840861 |
| 44 | 0.416667 | 0.103714 |
| 44 | 0.5 | 0.128031 |
| 44 | 0.583333 | 0.157098 |
| 44 | 0.666667 | 0.19088 |
| 44 | 0.75 | 0.229213 |
| 44 | 0.833333 | 0.271787 |
| 44 | 0.916667 | 0.318127 |
| 44 | 1 | 0.367602 |
| 44 | 1.08333 | 0.419435 |
| 44 | 1.16667 | 0.472738 |
| 44 | 1.25 | 0.526551 |
| 44 | 1.33333 | 0.579891 |
| 44 | 1.41667 | 0.631805 |
| 44 | 1.5 | 0.681415 |
| 44 | 1.58333 | 0.727969 |
| 44 | 1.66667 | 0.770866 |
| 44 | 1.75 | 0.80968 |
| 44 | 1.83333 | 0.844165 |
| 44 | 1.91667 | 0.874253 |
| 44 | 2 | 0.900031 |
| 44 | 2.08333 | 0.921717 |
| 44 | 2.16667 | 0.939633 |
| 44 | 2.25 | 0.954168 |
| 44 | 2.33333 | 0.965746 |
| 44 | 2.41667 | 0.974804 |
| 44 | 2.5 | 0.981762 |
- 記録されたすべての曲線は、この表とそのCSVエクスポートに含まれます。グラフには、選択した最大12種類のサンプルサイズを表示します。
6. レポートを作成
Power and sample size scenarios、Planning method、Scenario input values、Power versus effect グラフと、その記録値の表全体を残します。検出する価値のある差、計画用のばらつきまたは比率、標本の割り付け、計算方法を記録します。この方法は、互いに独立で正規分布に従う観測値と、母標準偏差(SD)が4 gという仮定のもとで、一標本の非心t分布に基づいて計算します。ここでは、基準平均自体を第二の標本から推定するわけではありません。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。