

ऐप के कमांड, वर्कशीट के पहचानकर्ता और उदाहरण डेटा के मान अपने मूल रूप में हैं। स्क्रीनशॉट, चार्ट और डाउनलोड अंग्रेज़ी में हैं। वैज्ञानिक उदाहरणों में मूल दशमलव बिंदु और हज़ारों के लिए अल्पविराम सुरक्षित हैं; वेबसाइट की कीमतें और गिनती स्थानीय स्वरूप में दिखाई जाती हैं।
उदाहरण: सैशे भराव के लिए नमूना आकार
4 g के माने गए SD और 90% परीक्षण शक्ति के साथ संदर्भ औसत से 2 g का अंतर पहचानने के लिए सैशे भराव के स्वतंत्र मापों की योजना बनाएँ।
योजना का संदर्भ डाउनलोड करें (CSV)यह Help में इस्तेमाल किया गया वही उदाहरण है। CSV में संदर्भ परिदृश्य दिए गए हैं। चुने गए नियोजन मान Inputs में स्वयं दर्ज करें; उसे आयात करने से यह कैलकुलेटर सेट नहीं होता है। इनपुट पहले से भरने के लिए Help में Open example in a practice copy इस्तेमाल करें।
1. कार्यक्षेत्र बनाएँ
साइडबार में Basic Statistics खोलें और Power & Sample Size चुनें। विश्लेषण बनाएँ, उसे नाम दें, New blank worksheet चुनें और फिर Create analysis चुनें।
2. अध्ययन चुनें
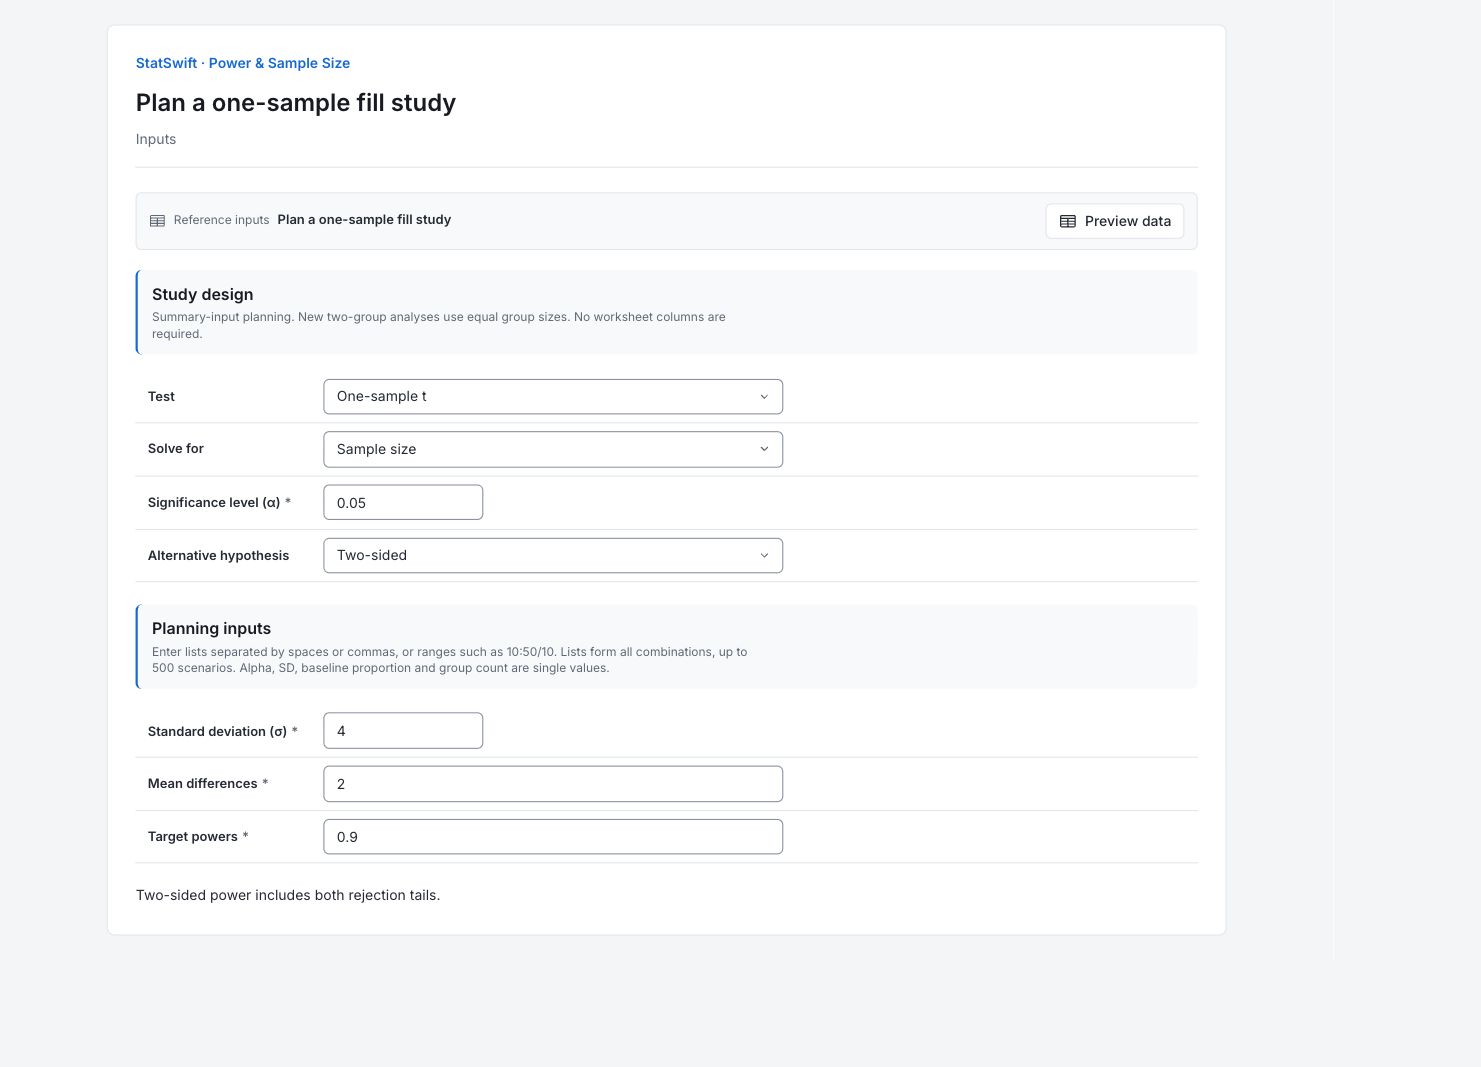
Inputs में Test के लिए One-sample t और Solve for के लिए Sample size चुनें। Significance level (α) में 0.05 दर्ज करें और Alternative hypothesis के लिए Two-sided चुनें।
3. योजना के मान दर्ज करें
इस परिदृश्य के लिए हर फ़ील्ड में एक मान दर्ज करें। वर्कशीट का कोई कॉलम नहीं जोड़ा जाता है।
Standard deviation (σ) में 4 दर्ज करें।
Mean differences में 2 दर्ज करें।
Target powers में 0.9 दर्ज करें।
4. विश्लेषण चलाएँ
Run analysis चुनें, फिर Results खोलें।
5। परिणामों की व्याख्या करें
नियोजित अध्ययन जाँचें
4 g के माने गए SD और 90% परीक्षण शक्ति के साथ संदर्भ औसत से 2 g का अंतर पहचानने के लिए सैशे भराव के स्वतंत्र मापों की योजना बनाएँ।
गणना की गई योजना पढ़ें
सबसे छोटा नियोजित नमूना 44 सैशे है। प्राप्त शक्ति 0.900031 है, जो 0.9 के लक्ष्य से कुछ अधिक है। 43 सैशे पर शक्ति 0.893050 है।
शक्ति वक्र का अनुसरण करें
वक्र 44 प्रेक्षण इस्तेमाल करता है। +2 g या −2 g के अंतर पर शक्ति लगभग 90% है। शून्य के निकट छोटे अंतर पहचानना कठिन होता है।

प्रभाव के सापेक्ष परीक्षण शक्ति पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) मान्यताएँ समझें
परीक्षण शक्ति वह संभावना है कि दर्ज मान्यताओं के अंतर्गत नियोजित परीक्षण निर्दिष्ट अंतर के वास्तविक होने पर उसे पहचान लेगा। यह परिकल्पना के सही होने की संभावना नहीं है और सार्थक परिणाम की गारंटी नहीं देती है। विधि स्वतंत्र सामान्य प्रेक्षणों और समष्टि के 4 g के माने गए SD के साथ एक-नमूना गैर-केंद्रीय t गणना इस्तेमाल करती है। यहाँ संदर्भ औसत स्वयं किसी दूसरे नमूने से अनुमानित नहीं है।
नमूना कैसे लें, यह तय करें
पुष्टि करें कि 2 g सबसे छोटा अंतर है जिसे पहचानना उपयोगी है और 4 g नियोजन के लिए उचित SD है। कितने सैशे लेने हैं, यह तय करते समय अनुपयोगी मापों की गुंजाइश रखें।
और जानकारी: परिणाम का हर खंड पढ़ें
परिणामों की पूरी तालिकाओं में Help की तरह छह सार्थक अंक हैं।
परीक्षण शक्ति और नमूना आकार के परिदृश्य
परिदृश्य इस पंक्ति को उसके इनपुट मानों से जोड़ता है। शाखा हल की गई प्रभाव दिशा दर्ज करती है; डैश का मतलब है कि वह लागू नहीं है। दो समूहों की योजनाओं में नमूना आकार प्रति समूह है; कुल प्रेक्षण दोनों समूह गिनते हैं। औसत अंतर या तुलना अनुपात नियोजित प्रभाव है। लक्षित शक्ति माँगी गई शक्ति है; प्राप्त शक्ति गणना का परिणाम है। पिछले आकार की शक्ति हर समूह में एक कम प्रेक्षण की जाँच करती है। जहाँ लागू हो, DF t-परीक्षण की स्वतंत्रता की कोटि है। स्थिति और विवरण दर्ज करते हैं कि परिदृश्य की गणना हुई या नहीं। सबसे छोटा नियोजित नमूना 44 सैशे है। प्राप्त शक्ति 0.900031 है, जो 0.9 के लक्ष्य से कुछ अधिक है। 43 सैशे पर शक्ति 0.893050 है।
| परिदृश्य | शाखा | नमूना आकार | कुल प्रेक्षण | औसत का अंतर | लक्षित शक्ति | प्राप्त शक्ति | पिछले आकार की शक्ति | DF | स्थिति | विवरण |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 44 | 44 | 2 | 0.9 | 0.900031 | 0.89305 | 43 | ok | — |
- अनुपलब्ध शाखाओं के साथ उनकी स्थिति और इनपुट मान बने रहते हैं। हर युग्म में दो प्रेक्षण गिने जाते हैं। पिछले आकार की परीक्षण शक्ति तभी दी जाती है जब वह आकार वैध हो।
नियोजन विधि
विधि और अंशांकन इस्तेमाल की गई गणना की पहचान करते हैं। अल्फ़ा 0.05 परीक्षण का सार्थकता स्तर है; द्विपक्षीय वैकल्पिक परिकल्पना दोनों दिशाएँ शामिल करती है। हल की जाने वाली मात्रा गणना की जा रही मात्रा बताती है। मान्यताएँ और नियोजन का SD या आधार अनुपात दर्ज करते हैं कि परिणाम किन बातों पर निर्भर है। विधि स्वतंत्र सामान्य प्रेक्षणों और समष्टि के 4 g के माने गए SD के साथ एक-नमूना गैर-केंद्रीय t गणना इस्तेमाल करती है। यहाँ संदर्भ औसत स्वयं किसी दूसरे नमूने से अनुमानित नहीं है।
| सेटिंग | मान |
|---|---|
| विधि | एक-नमूना t |
| गणना का कैलिब्रेशन | noncentral-t-v1 |
| α | 0.05 |
| वैकल्पिक परिकल्पना | two-sided |
| किसकी गणना करनी है | नमूना आकार |
| मान्यताएँ | स्वतंत्र सामान्य प्रेक्षण; अनुमानित समष्टि मानक विचलन। |
| योजना के लिए मानक विचलन | 4 |
- परिणाम और वक्र के बिंदु इस विश्लेषण के साथ दर्ज हैं। नमूना आकार पूर्ण संख्याएँ हैं; लक्षित शक्ति और प्राप्त शक्ति अलग हैं।
परिदृश्य के इनपुट मान
परिदृश्य क्रमांकित परिणाम पंक्ति से मेल खाता है। इनपुट सक्रिय परिदृश्य के मान दर्ज करते हैं; ये नियोजन की मान्यताएँ हैं, देखे गए माप नहीं। यहाँ एकल-मान इनपुट से एक परिदृश्य बनता है।
| परिदृश्य | इनपुट |
|---|---|
| 1 | {"delta":2,"power":0.9} |
दर्ज किए गए शक्ति वक्र के मान
हर पंक्ति नमूना आकार, औसत अंतर या तुलना अनुपात और उसकी गणना की गई शक्ति देती है। ये ऐप के आलेख के पीछे दर्ज किए गए सभी मान हैं। दो समूहों की योजनाओं में आकार प्रति समूह है। शक्ति को शून्य और एक के बीच पढ़ें; 0.9 का मतलब 90% है। वक्र 44 प्रेक्षण इस्तेमाल करता है। +2 g या −2 g के अंतर पर शक्ति लगभग 90% है। शून्य के निकट छोटे अंतर पहचानना कठिन होता है।
| नमूना आकार | औसत का अंतर | परीक्षण शक्ति |
|---|---|---|
| 44 | -2.5 | 0.981762 |
| 44 | -2.41667 | 0.974804 |
| 44 | -2.33333 | 0.965746 |
| 44 | -2.25 | 0.954168 |
| 44 | -2.16667 | 0.939633 |
| 44 | -2.08333 | 0.921717 |
| 44 | -2 | 0.900031 |
| 44 | -1.91667 | 0.874253 |
| 44 | -1.83333 | 0.844165 |
| 44 | -1.75 | 0.80968 |
| 44 | -1.66667 | 0.770866 |
| 44 | -1.58333 | 0.727969 |
| 44 | -1.5 | 0.681415 |
| 44 | -1.41667 | 0.631805 |
| 44 | -1.33333 | 0.579891 |
| 44 | -1.25 | 0.526551 |
| 44 | -1.16667 | 0.472738 |
| 44 | -1.08333 | 0.419435 |
| 44 | -1 | 0.367602 |
| 44 | -0.916667 | 0.318127 |
| 44 | -0.833333 | 0.271787 |
| 44 | -0.75 | 0.229213 |
| 44 | -0.666667 | 0.19088 |
| 44 | -0.583333 | 0.157098 |
| 44 | -0.5 | 0.128031 |
| 44 | -0.416667 | 0.103714 |
| 44 | -0.333333 | 0.0840861 |
| 44 | -0.25 | 0.0690308 |
| 44 | -0.166667 | 0.058409 |
| 44 | -0.0833333 | 0.0520945 |
| 44 | 0 | 0.05 |
| 44 | 0.0833333 | 0.0520945 |
| 44 | 0.166667 | 0.058409 |
| 44 | 0.25 | 0.0690308 |
| 44 | 0.333333 | 0.0840861 |
| 44 | 0.416667 | 0.103714 |
| 44 | 0.5 | 0.128031 |
| 44 | 0.583333 | 0.157098 |
| 44 | 0.666667 | 0.19088 |
| 44 | 0.75 | 0.229213 |
| 44 | 0.833333 | 0.271787 |
| 44 | 0.916667 | 0.318127 |
| 44 | 1 | 0.367602 |
| 44 | 1.08333 | 0.419435 |
| 44 | 1.16667 | 0.472738 |
| 44 | 1.25 | 0.526551 |
| 44 | 1.33333 | 0.579891 |
| 44 | 1.41667 | 0.631805 |
| 44 | 1.5 | 0.681415 |
| 44 | 1.58333 | 0.727969 |
| 44 | 1.66667 | 0.770866 |
| 44 | 1.75 | 0.80968 |
| 44 | 1.83333 | 0.844165 |
| 44 | 1.91667 | 0.874253 |
| 44 | 2 | 0.900031 |
| 44 | 2.08333 | 0.921717 |
| 44 | 2.16667 | 0.939633 |
| 44 | 2.25 | 0.954168 |
| 44 | 2.33333 | 0.965746 |
| 44 | 2.41667 | 0.974804 |
| 44 | 2.5 | 0.981762 |
- दर्ज किए गए सभी वक्र इस तालिका और उसके CSV निर्यात में शामिल हैं; आलेख अधिकतम 12 चुने गए नमूना आकार दिखाता है।
6। रिपोर्ट बनाएँ
Power and sample size scenarios, Planning method, Scenario input values, ऐप का Power versus effect आलेख और उसके दर्ज किए गए मानों की पूरी तालिका रखें। पहचानने योग्य महत्वपूर्ण अंतर, नियोजन का फैलाव या अनुपात, नमूना आवंटन और विधि दर्ज करें। विधि स्वतंत्र सामान्य प्रेक्षणों और समष्टि के 4 g के माने गए SD के साथ एक-नमूना गैर-केंद्रीय t गणना इस्तेमाल करती है। यहाँ संदर्भ औसत स्वयं किसी दूसरे नमूने से अनुमानित नहीं है।
चुनें: Add to report पूरे हो चुके विश्लेषण से। खोलें: Choose individual items and advanced options —तालिकाएँ और चार्ट चुनने के लिए; फिर चुनें: Add to draft। छिपाए गए आइटम सहेजे गए विश्लेषण में बने रहते हैं।
रिपोर्ट को नाम दें और अध्ययन का उद्देश्य तथा अपनी व्याख्या जोड़ें। चुनें: Save, फिर देखें: Preview, और फिर इस्तेमाल करें: Export → Download HTML। नीचे दिए गए उदाहरण में चुनी गई पूरी सामग्री है, जिसमें एक स्क्रीन से आगे के परिणाम भी शामिल हैं।