

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: liczebność próby napełnienia saszetek
Zaplanuj niezależne pomiary napełnienia saszetek, aby wykryć różnicę 2 g od średniej referencyjnej, przy założonym SD 4 g i mocy 90%.
Pobierz zestawienie planistyczne (CSV, język angielski)To ten sam przykład, który znajduje się w Help. CSV zawiera scenariusze referencyjne. Wprowadź wybrane wartości planistyczne ręcznie na karcie Inputs; import nie konfiguruje tego kalkulatora. Użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Power & Sample Size. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Wybierz badanie
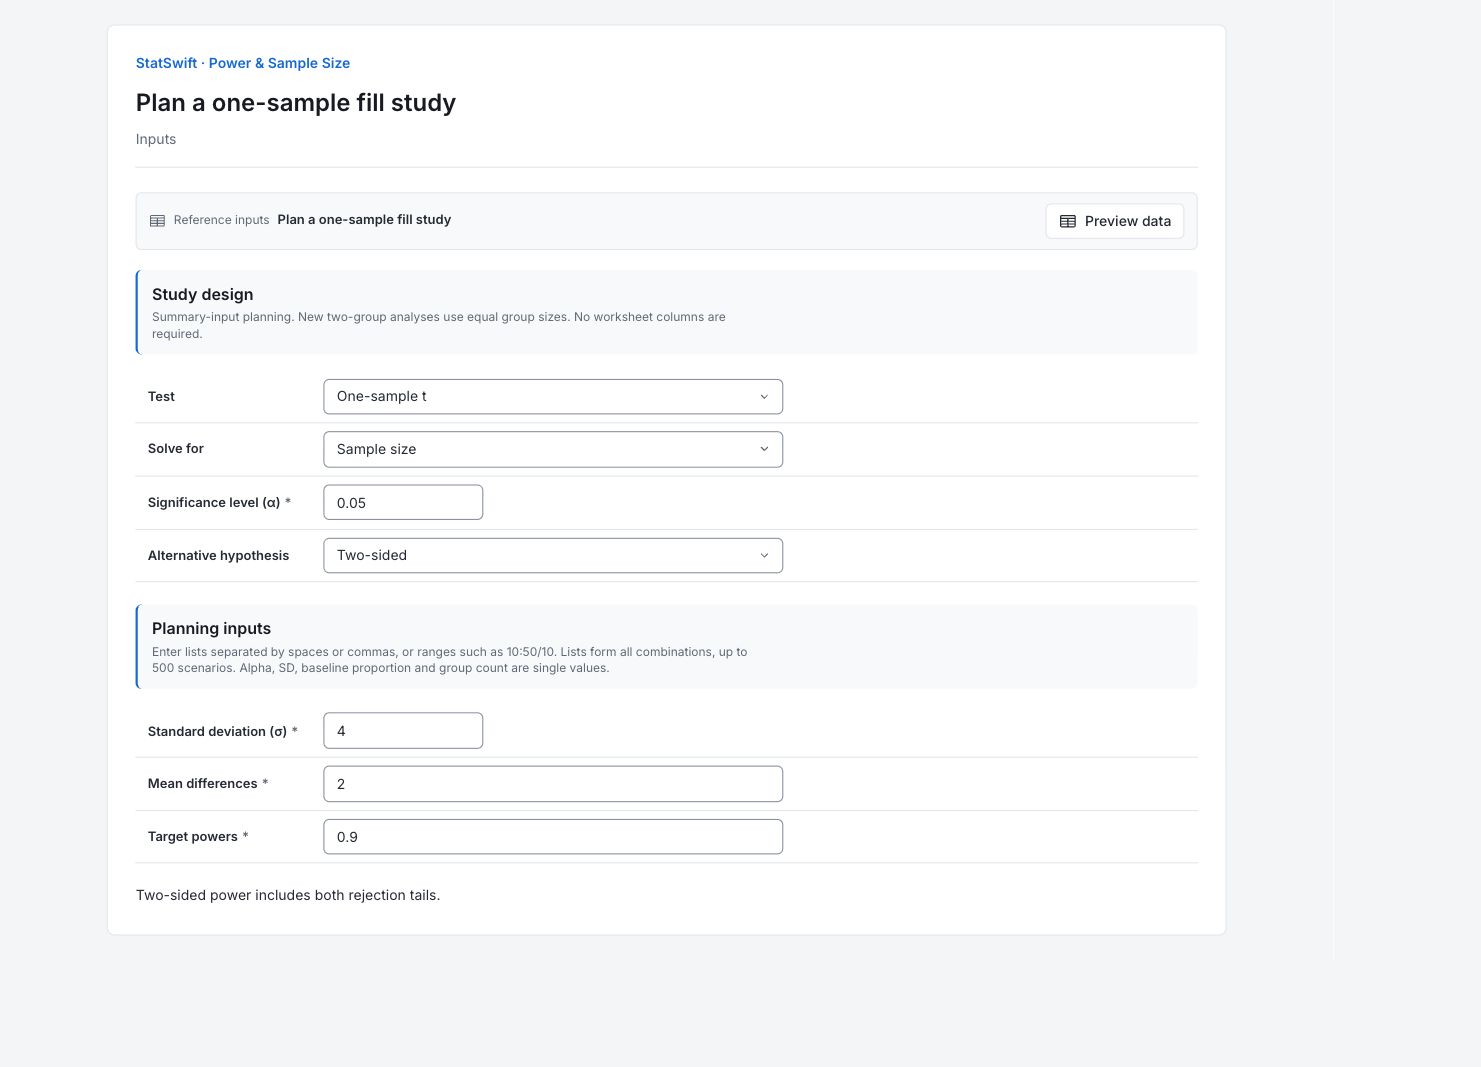
Na karcie Inputs wybierz One-sample t w Test i Sample size w Solve for. Wpisz 0.05 w Significance level (α) i wybierz Two-sided w Alternative hypothesis.
3. Wprowadź wartości planistyczne
Wprowadź po jednej wartości w każdym polu dla tego scenariusza. Nie przypisuje się kolumn arkusza.
Wpisz 4 w Standard deviation (σ).
Wpisz 2 w Mean differences.
Wpisz 0.9 w Target powers.
4. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
5. Zinterpretuj wyniki
Sprawdź planowane badanie
Zaplanuj niezależne pomiary napełnienia saszetek, aby wykryć różnicę 2 g od średniej referencyjnej, przy założonym SD 4 g i mocy 90%.
Odczytaj obliczony plan
Najmniejsza planowana próba to 44 saszetki. Moc osiągnięta wynosi 0.900031, tuż powyżej celu 0.9. Przy 43 saszetkach moc wynosi 0.893050.
Prześledź krzywą mocy
Krzywa wykorzystuje 44 obserwacje. Przy różnicy +2 g lub −2 g moc wynosi około 90%. Mniejsze różnice, bliższe zeru, są trudniejsze do wykrycia.

Moc względem efektu Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Zrozum założenia
Moc to prawdopodobieństwo wykrycia określonej różnicy przez planowany test, gdy ta różnica rzeczywiście istnieje, przy wprowadzonych założeniach. Nie jest prawdopodobieństwem prawdziwości hipotezy i nie gwarantuje istotnego wyniku. Metoda wykorzystuje obliczenie z niecentralnym rozkładem t dla jednej próby z niezależnymi normalnymi obserwacjami i założonym SD populacji 4 g. Sama średnia referencyjna nie jest tutaj szacowana z drugiej próby.
Zdecyduj, jak zebrać próbę
Potwierdź, że 2 g to najmniejsza różnica warta wykrycia, a 4 g to zasadne planowane SD. Uwzględnij niezdatne pomiary przy ustalaniu liczby saszetek do pobrania.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Scenariusze mocy i liczebności próby
Scenariusz łączy wiersz z danymi wejściowymi. Gałąź określa kierunek rozwiązanego efektu; kreska oznacza, że nie dotyczy. Liczebność próby jest podawana na grupę w planach dwugrupowych; całkowita liczba obserwacji zlicza obie grupy. Różnica średnich lub proporcja porównawcza to planowany efekt. Moc docelowa jest żądaniem; moc osiągnięta jest obliczonym wynikiem. Moc przy poprzedniej liczebności sprawdza o jedną obserwację mniej na grupę. DF to stopnie swobody testu t, jeśli dotyczą. Status i szczegóły informują, czy scenariusz został obliczony. Najmniejsza planowana próba to 44 saszetki. Moc osiągnięta wynosi 0.900031, tuż powyżej celu 0.9. Przy 43 saszetkach moc wynosi 0.893050.
| Scenariusz | Gałąź | Liczebność próby | Całkowita liczba obserwacji | Różnica średnich | Moc docelowa | Moc osiągnięta | Moc przy poprzedniej liczebności | DF | Status | Szczegóły |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 44 | 44 | 2 | 0.9 | 0.900031 | 0.89305 | 43 | ok | — |
- Niedostępne gałęzie zachowują status i dane wejściowe. Każda para liczy dwie obserwacje. Moc przy poprzedniej liczebności jest podawana tylko wtedy, gdy ta liczebność jest poprawna.
Metoda planowania
Metoda i kalibracja określają użyte obliczenie. Alfa 0.05 to poziom istotności testu; dwustronna alternatywa obejmuje oba kierunki. Pole obliczanej wielkości określa szukaną wartość. Założenia oraz planowane SD lub proporcja bazowa opisują, od czego zależy wynik. Metoda wykorzystuje obliczenie z niecentralnym rozkładem t dla jednej próby z niezależnymi normalnymi obserwacjami i założonym SD populacji 4 g. Sama średnia referencyjna nie jest tutaj szacowana z drugiej próby.
| Ustawienie | Wartość |
|---|---|
| Metoda | Test t dla jednej próby |
| Kalibracja | noncentral-t-v1 |
| Alfa | 0.05 |
| Hipoteza alternatywna | two-sided |
| Wyznaczana wielkość | Liczebność próby |
| Założenia | Niezależne obserwacje z rozkładu normalnego; szacowane odchylenie standardowe populacji. |
| Planowane odchylenie standardowe | 4 |
- Wyniki i punkty krzywej zapisano z tym uruchomieniem. Liczebności próby są całkowite; moc docelowa i osiągnięta są odrębne.
Dane wejściowe scenariusza
Scenariusz odpowiada numerowanemu wierszowi wyników. Dane wejściowe zawierają aktywne wartości scenariusza; są to założenia planistyczne, a nie obserwowane pomiary. Pojedyncze wartości wejściowe tworzą tutaj jeden scenariusz.
| Scenariusz | Dane wejściowe |
|---|---|
| 1 | {"delta":2,"power":0.9} |
Zapisane wartości krzywej mocy
Każdy wiersz podaje liczebność próby, różnicę średnich lub proporcję porównawczą oraz obliczoną moc. Są to wszystkie zapisane wartości natywnego wykresu. W planach dwugrupowych liczebność dotyczy jednej grupy. Moc odczytuje się między zerem a jednością; 0.9 oznacza 90%. Krzywa wykorzystuje 44 obserwacje. Przy różnicy +2 g lub −2 g moc wynosi około 90%. Mniejsze różnice, bliższe zeru, są trudniejsze do wykrycia.
| Liczebność próby | Różnica średnich | Moc |
|---|---|---|
| 44 | -2.5 | 0.981762 |
| 44 | -2.41667 | 0.974804 |
| 44 | -2.33333 | 0.965746 |
| 44 | -2.25 | 0.954168 |
| 44 | -2.16667 | 0.939633 |
| 44 | -2.08333 | 0.921717 |
| 44 | -2 | 0.900031 |
| 44 | -1.91667 | 0.874253 |
| 44 | -1.83333 | 0.844165 |
| 44 | -1.75 | 0.80968 |
| 44 | -1.66667 | 0.770866 |
| 44 | -1.58333 | 0.727969 |
| 44 | -1.5 | 0.681415 |
| 44 | -1.41667 | 0.631805 |
| 44 | -1.33333 | 0.579891 |
| 44 | -1.25 | 0.526551 |
| 44 | -1.16667 | 0.472738 |
| 44 | -1.08333 | 0.419435 |
| 44 | -1 | 0.367602 |
| 44 | -0.916667 | 0.318127 |
| 44 | -0.833333 | 0.271787 |
| 44 | -0.75 | 0.229213 |
| 44 | -0.666667 | 0.19088 |
| 44 | -0.583333 | 0.157098 |
| 44 | -0.5 | 0.128031 |
| 44 | -0.416667 | 0.103714 |
| 44 | -0.333333 | 0.0840861 |
| 44 | -0.25 | 0.0690308 |
| 44 | -0.166667 | 0.058409 |
| 44 | -0.0833333 | 0.0520945 |
| 44 | 0 | 0.05 |
| 44 | 0.0833333 | 0.0520945 |
| 44 | 0.166667 | 0.058409 |
| 44 | 0.25 | 0.0690308 |
| 44 | 0.333333 | 0.0840861 |
| 44 | 0.416667 | 0.103714 |
| 44 | 0.5 | 0.128031 |
| 44 | 0.583333 | 0.157098 |
| 44 | 0.666667 | 0.19088 |
| 44 | 0.75 | 0.229213 |
| 44 | 0.833333 | 0.271787 |
| 44 | 0.916667 | 0.318127 |
| 44 | 1 | 0.367602 |
| 44 | 1.08333 | 0.419435 |
| 44 | 1.16667 | 0.472738 |
| 44 | 1.25 | 0.526551 |
| 44 | 1.33333 | 0.579891 |
| 44 | 1.41667 | 0.631805 |
| 44 | 1.5 | 0.681415 |
| 44 | 1.58333 | 0.727969 |
| 44 | 1.66667 | 0.770866 |
| 44 | 1.75 | 0.80968 |
| 44 | 1.83333 | 0.844165 |
| 44 | 1.91667 | 0.874253 |
| 44 | 2 | 0.900031 |
| 44 | 2.08333 | 0.921717 |
| 44 | 2.16667 | 0.939633 |
| 44 | 2.25 | 0.954168 |
| 44 | 2.33333 | 0.965746 |
| 44 | 2.41667 | 0.974804 |
| 44 | 2.5 | 0.981762 |
- Wszystkie zapisane krzywe są zawarte w tej tabeli i jej eksporcie CSV; wykres pokazuje najwyżej 12 wybranych liczebności prób.
6. Utwórz raport
Zachowaj Power and sample size scenarios, Planning method, Scenario input values, natywny wykres Power versus effect i pełną tabelę zapisanych wartości. Zapisz różnicę wartą wykrycia, planowany rozrzut lub proporcje, przydział próby i metodę. Metoda wykorzystuje obliczenie z niecentralnym rozkładem t dla jednej próby z niezależnymi normalnymi obserwacjami i założonym SD populacji 4 g. Sama średnia referencyjna nie jest tutaj szacowana z drugiej próby. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.