

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: 不適合ラベルがちょうど二枚となる確率
25枚のラベルを検査します。各ラベルが不適合となる確率は4%で、他のラベルとは独立していると仮定します。
計算例の参照データをダウンロード(CSV、列名は英語)Help と同じ例を使用しています。CSVには参照用の計算例が記載されています。選んだ例を Inputs に手入力します。CSVをインポートしても、この計算ツールは設定されません。Helpの Open example in a practice copy で、入力値をあらかじめ設定できます。
1. ワークスペースを作成
サイドバーで Basic Statistics を開き、Distributions を選択します。分析を作成して名前を入力し、New blank worksheet を選んで、Create analysis を選択します。
2. 計算の種類を選択
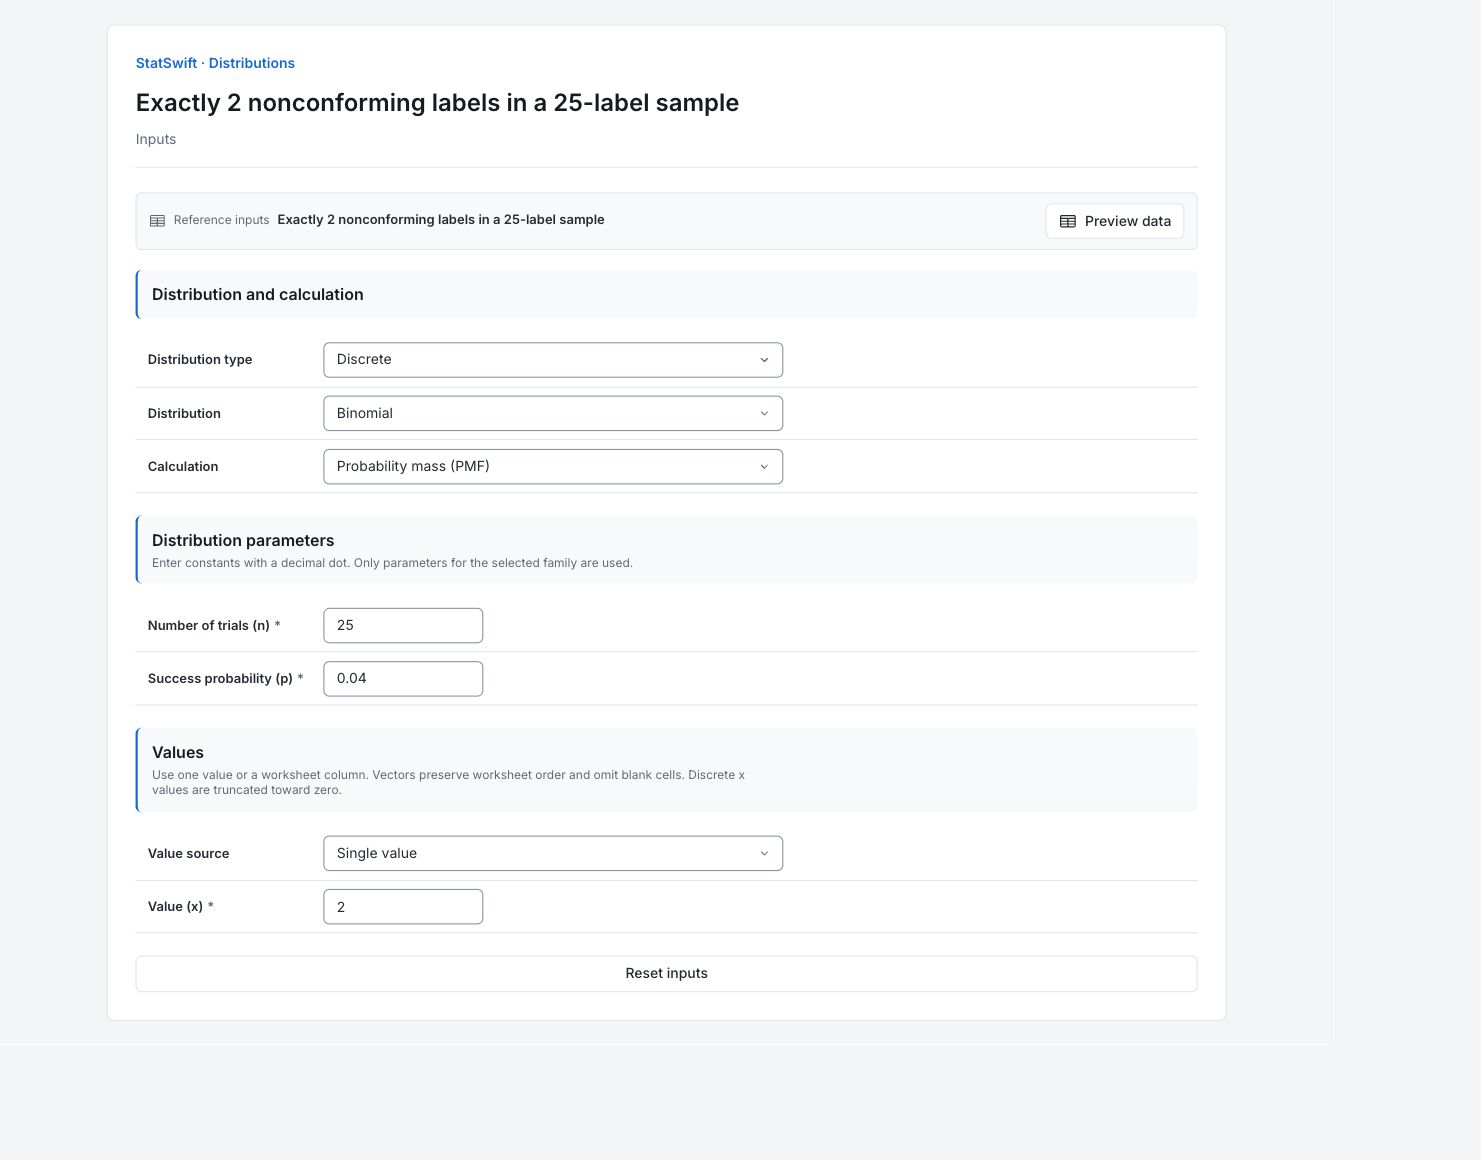
Inputs で、Distribution type に Discrete、Distribution に Binomial、Calculation に Probability mass (PMF) を選択します。
3. モデルを入力
Number of trials (n) に 25、Success probability (p) に 0.04 を入力します。ここでの「成功」は、不適合ラベルを見つけることを意味します。
4. 求める値を指定
Value source に Single value を選び、Value (x) に 2 を入力します。ワークシートの列は割り当てません。
5. 分析を実行
Run analysis を選択し、Results を開きます。
6. 結果を解釈
求める量を確認
25枚のラベルを検査します。各ラベルが不適合となる確率は4%で、他のラベルとは独立していると仮定します。
計算結果を確認
PMFは0.187707、約18.77%です。このモデルの下で、25枚中ちょうど二枚の不適合ラベルが見つかる確率を表します。
結果の意味を理解
ちょうど二枚という条件には、ゼロ枚や一枚は含まれません。二枚以下の確率には、累積確率を使用します。
モデルを慎重に適用
抽出するラベルについて、不適合の確率が同じで、互いに独立しているという仮定が妥当か確認します。不適合がバッチごとに集中して生じると、このモデルは適切でない場合があります。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
分布の値
xは、確率を求めたい件数です。PMFはP(X = x)で、ちょうどその件数となる確率を表します。ちょうど二枚という条件には、ゼロ枚や一枚は含まれません。二枚以下の確率には、累積確率を使用します。
| x | PMF |
|---|---|
| 2 | 0.187707 |
分布の要約
種類は、連続値と整数の件数を区別します。分布はモデルの名称です。計算の種類には、PMF(特定の件数の確率)、PDF(密度)、CDF(累積確率)、ICDF(分位点)が記録されます。残りの行には、使用しているパラメーターが記録されます。これらはInputsで入力した仮定です。
| 設定 | 値 |
|---|---|
| 種類 | Discrete |
| 分布 | Binomial |
| 計算 | PMF |
| 試行回数(n) | 25 |
| 成功確率(p) | 0.04 |
- 二項分布(n=25, p=0.04)
7. レポートを作成
Distribution values(または分位点の表)と Distribution summary を残します。モデルの仮定、時間の単位または件数を数える区間、何を求めたかを明記します。ちょうど二枚という条件には、ゼロ枚や一枚は含まれません。二枚以下の確率には、累積確率を使用します。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。