

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : exactement deux étiquettes non conformes
Inspectez 25 étiquettes. Supposez que chacune a une probabilité de non-conformité de 4%, indépendamment des autres.
Télécharger les scénarios de référence (CSV en anglais)C’est le même exemple que dans Help. Le CSV liste des scénarios de référence. Saisissez le scénario choisi manuellement dans Inputs ; l’importation ne configure pas ce calculateur. Utilisez Open example in a practice copy dans Help pour préremplir les données d’entrée.
1. Créer l’espace de travail
Dans la barre latérale, ouvrez Basic Statistics et choisissez Distributions. Créez une analyse, nommez-la, sélectionnez New blank worksheet, puis choisissez Create analysis.
2. Choisir le calcul
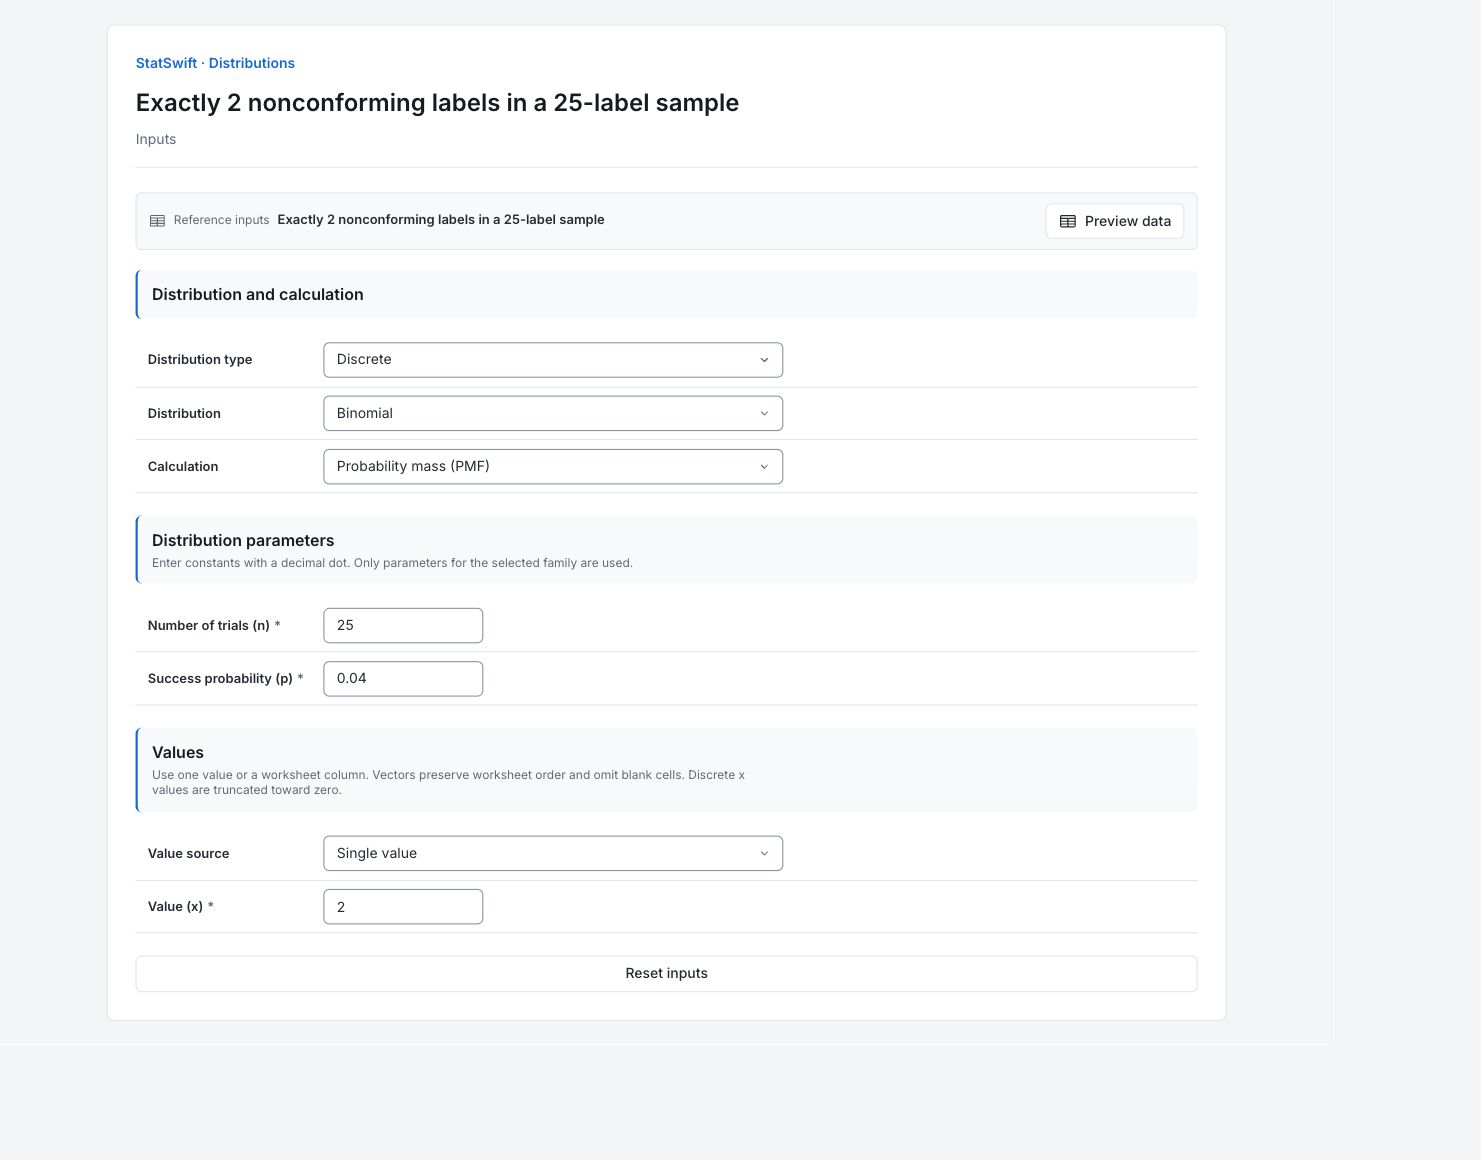
Dans Inputs, choisissez Discrete pour Distribution type, Binomial pour Distribution, puis Probability mass (PMF) pour Calculation.
3. Saisir le modèle
Saisissez 25 dans Number of trials (n) et 0.04 dans Success probability (p). Ici, un « succès » signifie trouver une étiquette non conforme.
4. Saisir la question
Choisissez Single value pour Value source. Saisissez 2 dans Value (x). Aucune colonne de feuille n’est affectée.
5. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
6. Interpréter les résultats
Vérifier la question
Inspectez 25 étiquettes. Supposez que chacune a une probabilité de non-conformité de 4%, indépendamment des autres.
Lire la valeur calculée
La PMF vaut 0.187707, soit environ 18.77%. Sous ce modèle, c’est la probabilité de trouver exactement deux étiquettes non conformes parmi 25.
Comprendre le résultat
Exactement deux exclut les effectifs de zéro ou un. Pour au plus deux, utilisez plutôt la probabilité cumulée.
Utiliser le modèle avec discernement
Vérifiez que l’hypothèse d’une même probabilité de non-conformité et celle d’indépendance sont raisonnables pour les étiquettes échantillonnées. Un regroupement par lots peut rendre ce modèle inapproprié.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Valeurs de la loi
x est l’effectif demandé. La PMF est P(X = x), la probabilité d’obtenir exactement cet effectif. Exactement deux exclut les effectifs de zéro ou un. Pour au plus deux, utilisez plutôt la probabilité cumulée.
| x | PMF |
|---|---|
| 2 | 0.187707 |
Résumé de la loi
Le type distingue les valeurs continues des effectifs entiers. La loi désigne le modèle. Le calcul indique PMF (probabilité d’un effectif exact), PDF (densité), CDF (probabilité cumulée) ou ICDF (quantile). Les autres lignes enregistrent les paramètres actifs ; ce sont des hypothèses saisies dans Inputs.
| Réglage | Valeur |
|---|---|
| Type | Discrete |
| Loi | Binomial |
| Calcul | PMF |
| Nombre d’essais (n) | 25 |
| Probabilité de succès (p) | 0.04 |
- Binomiale(n=25, p=0.04)
7. Créer un rapport
Conservez Distribution values (ou le tableau des quantiles) et Distribution summary. Précisez les hypothèses du modèle, l’unité de temps ou l’intervalle de dénombrement et la question traitée. Exactement deux exclut les effectifs de zéro ou un. Pour au plus deux, utilisez plutôt la probabilité cumulée.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.