

Názvy příkazů aplikace, identifikátory datových listů a hodnoty ukázkových dat zůstávají v původní podobě. Snímky obrazovky, grafy a soubory ke stažení jsou v angličtině. Vědecké příklady zachovávají anglické číselné konvence: desetinnou tečku a čárku oddělující tisíce.
Příklad: právě dvě neshodné etikety
Zkontrolujte 25 etiket. Předpokládejte, že každá má 4% pravděpodobnost neshody nezávisle na ostatních.
Stáhnout referenční scénáře (CSV v angličtině)Jde o stejný příklad jako v Help. CSV uvádí referenční scénáře. Vybraný scénář zadejte ručně na kartě Inputs; import tuto kalkulačku nenastaví. V Help použijte Open example in a practice copy k předvyplnění vstupů.
1. Vytvořte pracovní prostředí
Na postranním panelu otevřete Basic Statistics a vyberte Distributions. Vytvořte analýzu, pojmenujte ji, vyberte New blank worksheet a poté Create analysis.
2. Vyberte výpočet
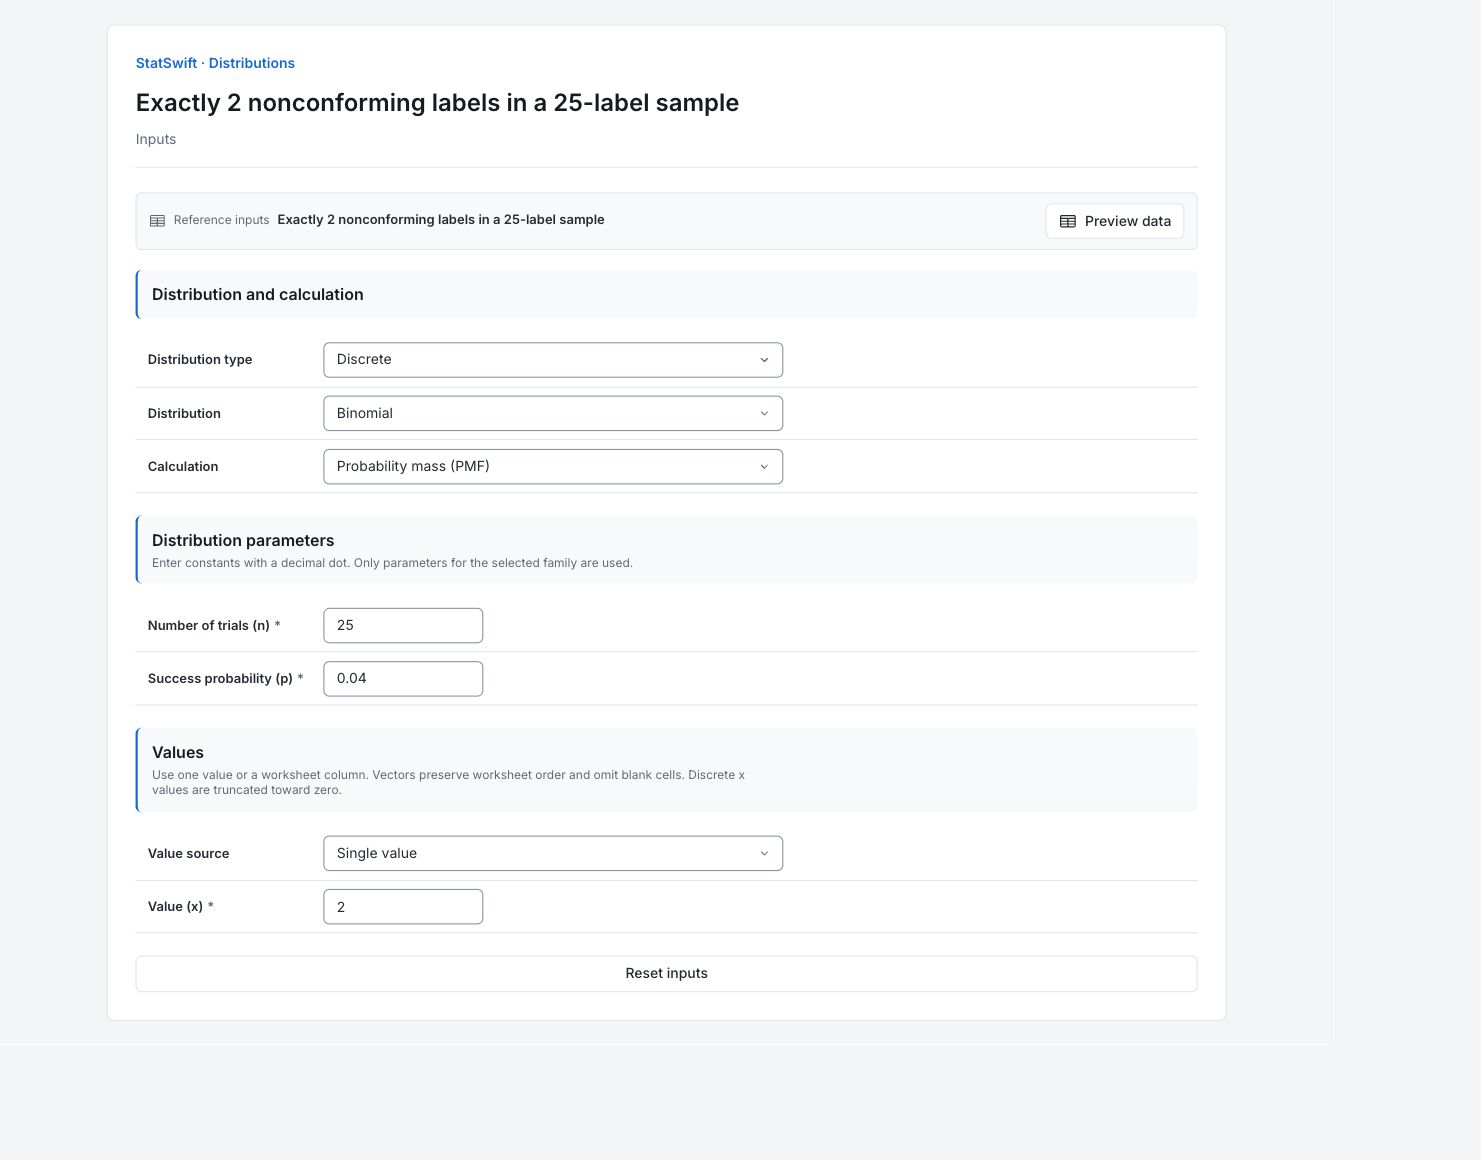
Na kartě Inputs vyberte Discrete pro Distribution type, Binomial pro Distribution a poté Probability mass (PMF) pro Calculation.
3. Zadejte model
Do Number of trials (n) zadejte 25 a do Success probability (p) zadejte 0.04. „Úspěch“ zde znamená nalezení neshodné etikety.
4. Zadejte otázku
Pro Value source vyberte Single value. Do Value (x) zadejte 2. Žádné sloupce datového listu se nepřiřazují.
5. Spusťte analýzu
Vyberte Run analysis a poté otevřete Results.
6. Interpretovat výsledky
Zkontrolujte otázku
Zkontrolujte 25 etiket. Předpokládejte, že každá má 4% pravděpodobnost neshody nezávisle na ostatních.
Přečtěte si vypočtenou hodnotu
PMF je 0.187707, přibližně 18.77%. V tomto modelu jde o pravděpodobnost nalezení právě dvou neshodných etiket mezi 25.
Porozumějte významu
Právě dvě vylučuje počty nula nebo jedna. Pro nejvýše dvě použijte kumulativní pravděpodobnost.
Používejte model uvážlivě
Zkontrolujte, zda jsou pro odebírané etikety rozumné předpoklady stejné pravděpodobnosti neshody a nezávislosti. Shlukování v dávce může učinit tento model nevhodným.
Další podrobnosti: přečtěte si každou sekci výsledků
Úplné tabulky výsledků používají šest platných číslic, stejně jako Help.
Hodnoty rozdělení
x je požadovaný počet. PMF je P(X = x), pravděpodobnost právě tohoto počtu. Právě dvě vylučuje počty nula nebo jedna. Pro nejvýše dvě použijte kumulativní pravděpodobnost.
| x | PMF |
|---|---|
| 2 | 0.187707 |
Souhrn rozdělení
Typ odlišuje spojité hodnoty od celočíselných počtů. Rozdělení označuje model. Výpočet zaznamenává PMF (pravděpodobnost přesného počtu), PDF (hustotu), CDF (kumulativní pravděpodobnost) nebo ICDF (kvantil). Zbývající řádky zaznamenávají aktivní parametry; jde o předpoklady zadané na kartě Inputs.
| Nastavení | Hodnota |
|---|---|
| Typ | Discrete |
| Rozdělení | Binomial |
| Výpočet | PMF |
| Počet pokusů (n) | 25 |
| Pravděpodobnost úspěchu (p) | 0.04 |
- Binomial(n=25, p=0.04)
7. Vytvořit zprávu
Zachovejte Distribution values (nebo tabulku kvantilů) a Distribution summary. Uveďte předpoklady modelu, časovou jednotku nebo interval počtů a zodpovídanou otázku. Právě dvě vylučuje počty nula nebo jedna. Pro nejvýše dvě použijte kumulativní pravděpodobnost.
Vyberte Add to report z dokončeného výpočtu. Otevřete Choose individual items and advanced options pro výběr tabulek a grafů a poté vyberte Add to draft. Skryté položky zůstávají v uložené analýze.
Pojmenujte zprávu a doplňte účel studie a svou interpretaci. Vyberte Save, zkontrolujte Preview, poté použijte Export → Download HTML. Příklad níže obsahuje veškerý vybraný obsah včetně výsledků přesahujících jednu obrazovku.