

Названия команд приложения, идентификаторы рабочих листов и значения данных примеров сохраняют исходное написание. Снимки экрана, графики и загружаемые файлы представлены на английском языке.
Пример: не более двух несоответствующих этикеток
Проверьте 25 независимых этикеток с предполагаемой вероятностью несоответствия каждой 4%. Найдите вероятность не более двух несоответствующих этикеток.
Загрузить справочные данные сценария (CSV)Это тот же пример, что и в Help. CSV содержит справочные сценарии. Введите выбранный сценарий вручную на вкладке Inputs; импорт не настраивает этот калькулятор. Используйте Open example in a practice copy в Help для предварительного заполнения входных данных.
1. Создайте рабочее пространство
На боковой панели откройте Basic Statistics и выберите Distributions. Создайте анализ, назовите его, выберите New blank worksheet, затем Create analysis.
2. Выберите расчёт
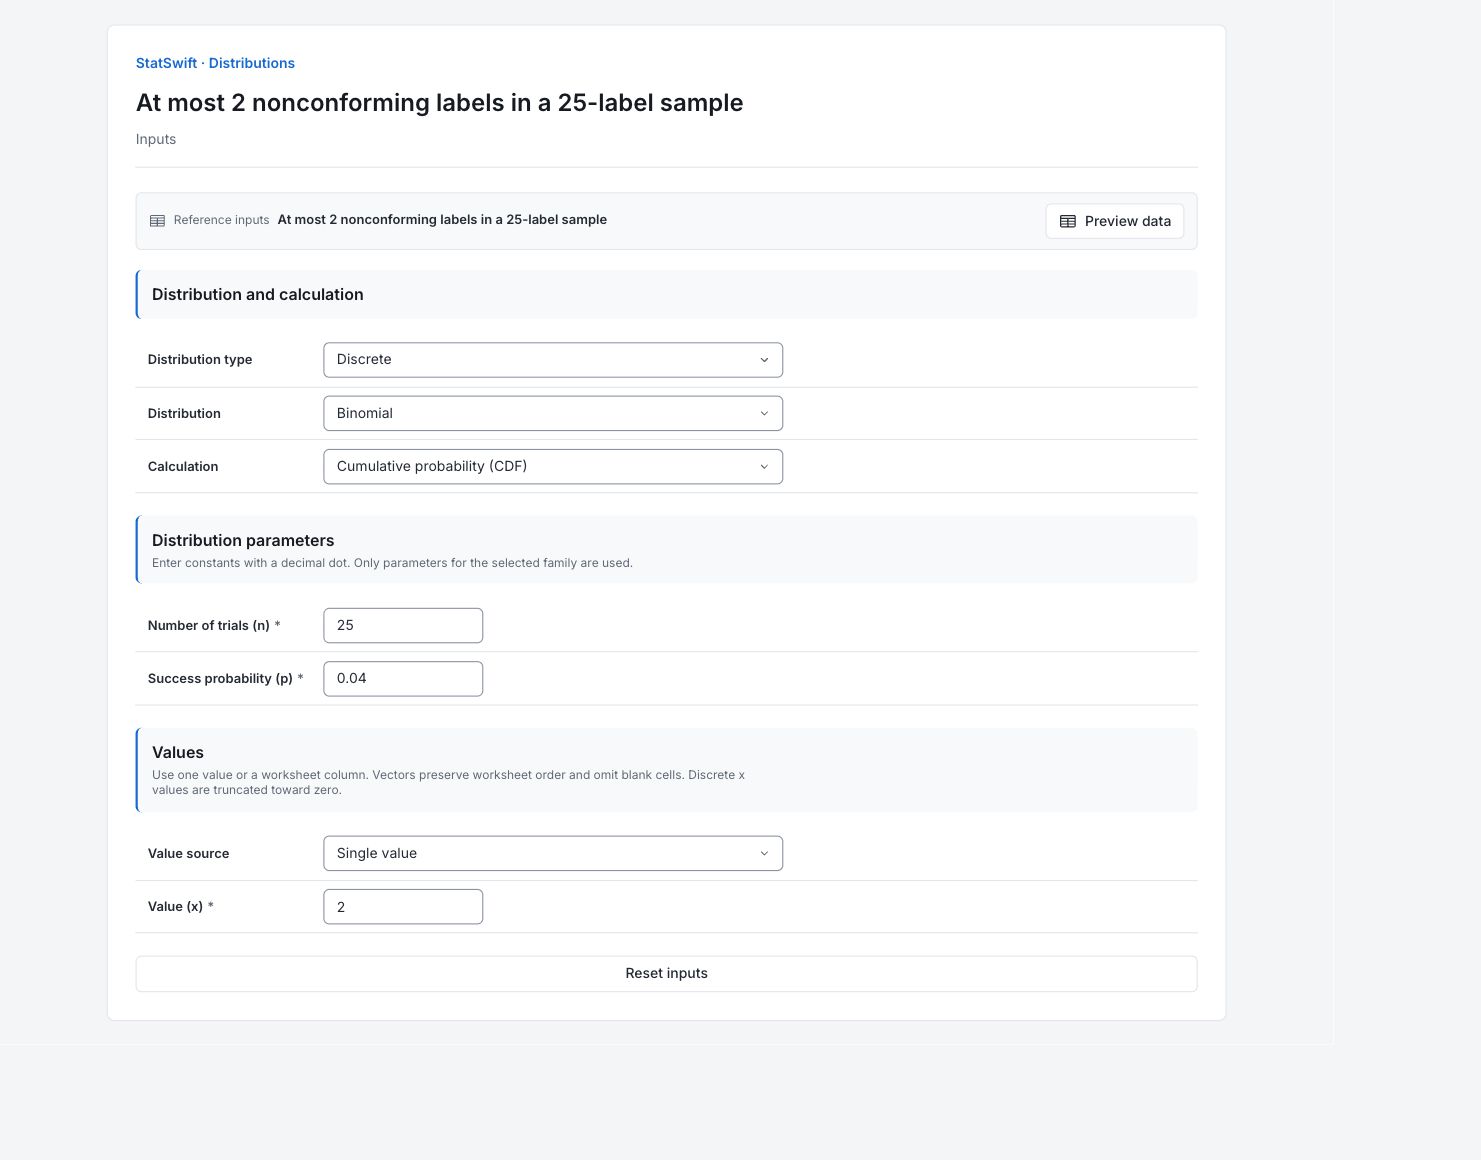
На вкладке Inputs выберите Discrete для Distribution type, Binomial для Distribution, затем Cumulative probability (CDF) для Calculation.
3. Введите модель
Введите 25 в Number of trials (n) и 0.04 в Success probability (p). Здесь «успех» означает обнаружение несоответствующей этикетки.
4. Введите вопрос
Выберите Single value для Value source. Введите 2 в Value (x). Столбцы рабочего листа не назначаются.
5. Выполните анализ
Выберите Run analysis, затем откройте Results.
6. Интерпретируйте результаты
Проверьте вопрос
Проверьте 25 независимых этикеток с предполагаемой вероятностью несоответствия каждой 4%. Найдите вероятность не более двух несоответствующих этикеток.
Прочитайте рассчитанное значение
CDF P(X ≤ x) равна 0.923517, примерно 92.35%. Она складывает вероятности обнаружить ноль, одну или две несоответствующие этикетки.
Поймите смысл
Survival P(X ≥ x) равна 0.264190. Она также включает две, поэтому два отображаемых хвоста перекрываются. Вероятность более двух — 1 − 0.923517 = 0.076483, примерно 7.65%.
Осторожно используйте модель
Используйте вероятность, соответствующую правилу принятия решения. Перед применением к другой партии проверьте предполагаемую долю 4% и независимость.
Подробнее: прочитайте каждый раздел результатов
Полные таблицы результатов используют шесть значащих цифр, как в Help.
Значения распределения
x — пороговое количество. CDF включает X ≤ x; Survival включает X ≥ x. Оба включают случай ровно x. Используйте разобранное выше сравнение, чтобы отличать включающий границу верхний хвост от дополнения 1 − CDF.
| x | Накопленная вероятность P(X ≤ x) | Верхний хвост P(X ≥ x) |
|---|---|---|
| 2 | 0.923517 | 0.26419 |
Сводка распределения
Тип отличает непрерывные значения от целочисленных количеств. Распределение обозначает модель. Расчёт указывает PMF (вероятность точного количества), PDF (плотность), CDF (накопленная вероятность) или ICDF (квантиль). Остальные строки содержат активные параметры — предположения, введённые на вкладке Inputs.
| Настройка | Значение |
|---|---|
| Тип | Discrete |
| Распределение | Binomial |
| Расчёт | CDF |
| Число испытаний (n) | 25 |
| Вероятность успеха (p) | 0.04 |
- Биномиальная модель (n=25, p=0.04)
7. Создайте отчёт
Сохраните Distribution values (или таблицу квантилей) и Distribution summary. Укажите предположения модели, единицу времени или интервал подсчёта и решаемый вопрос. Survival P(X ≥ x) равна 0.264190. Она также включает две, поэтому два отображаемых хвоста перекрываются. Вероятность более двух — 1 − 0.923517 = 0.076483, примерно 7.65%.
Выберите Add to report в завершённом анализе. Откройте Choose individual items and advanced options для выбора таблиц и графиков, затем выберите Add to draft. Скрытые элементы остаются в сохранённом анализе.
Назовите отчёт и добавьте цель исследования и свою интерпретацию. Выберите Save, просмотрите Preview, затем используйте Export → Download HTML. Пример ниже содержит весь выбранный материал, включая результаты за пределами одного экрана.