

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: co najwyżej dwie niezgodne etykiety
Sprawdź 25 niezależnych etykiet, zakładając dla każdej 4% prawdopodobieństwa niezgodności. Pytanie dotyczy co najwyżej dwóch niezgodnych etykiet.
Pobierz zestawienie scenariuszy (CSV, język angielski)To ten sam przykład, który znajduje się w Help. CSV zawiera scenariusze referencyjne. Wprowadź wybrany scenariusz ręcznie na karcie Inputs; import nie konfiguruje tego kalkulatora. Użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Distributions. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Wybierz obliczenie
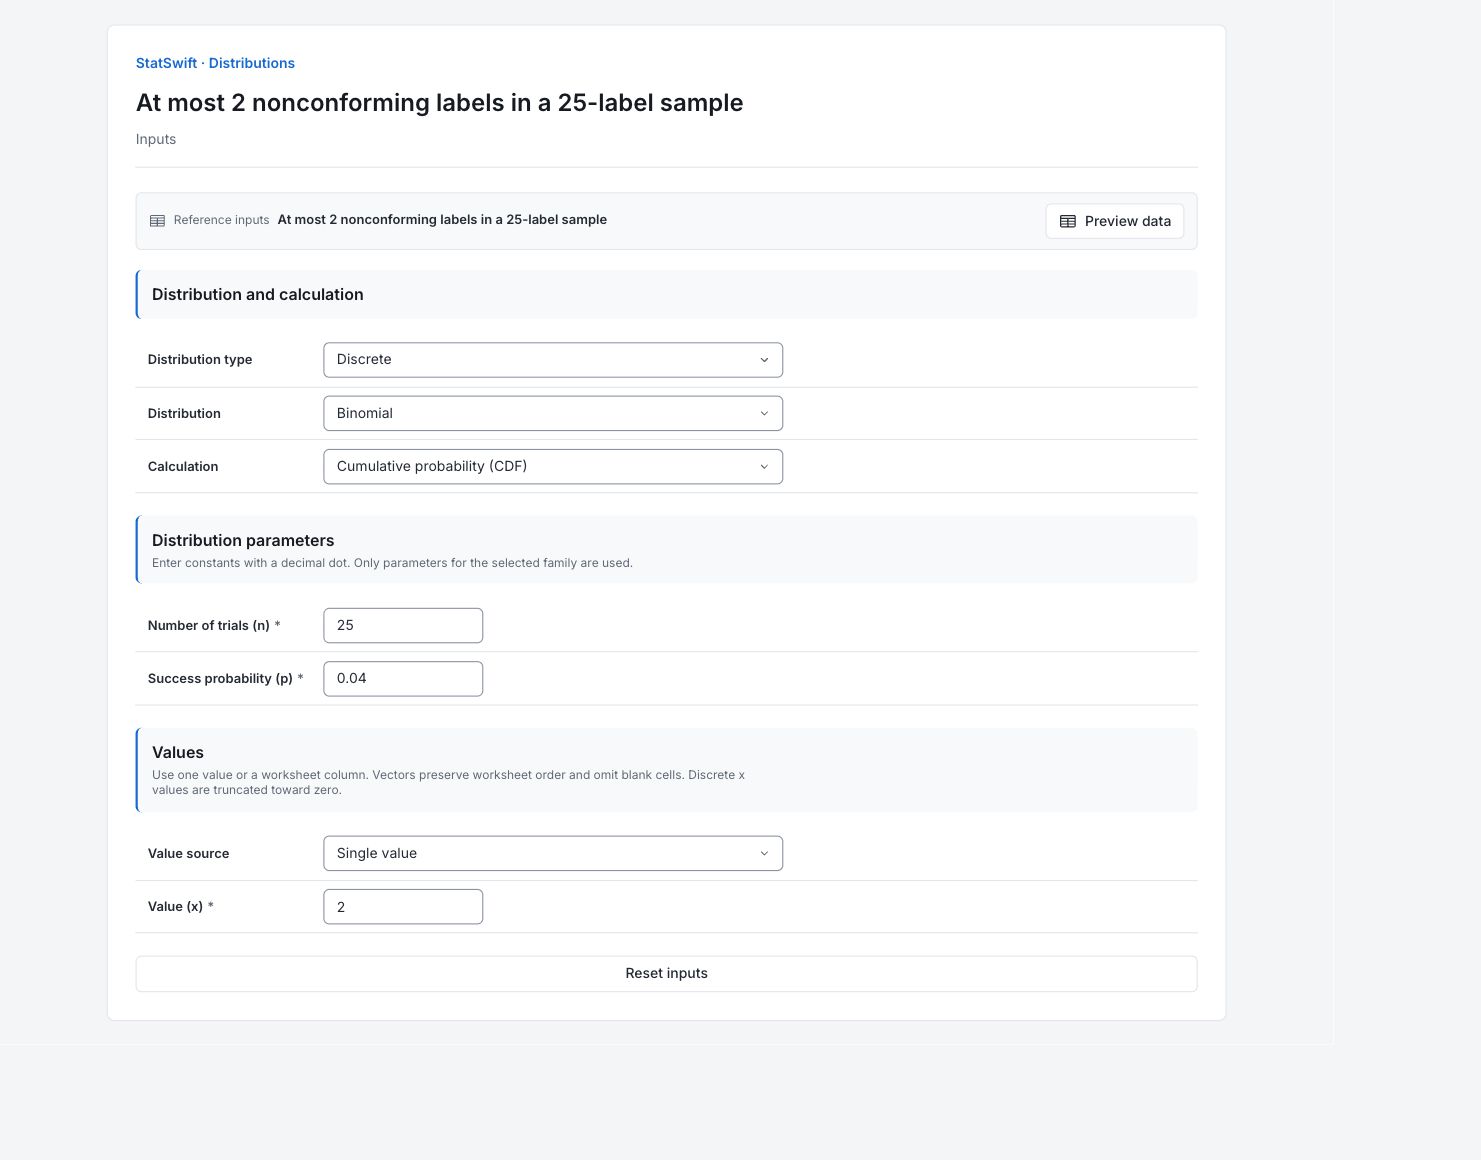
Na karcie Inputs wybierz Discrete w Distribution type, Binomial w Distribution, a następnie Cumulative probability (CDF) w Calculation.
3. Wprowadź model
Wpisz 25 w Number of trials (n) i 0.04 w Success probability (p). „Sukces” oznacza tutaj znalezienie niezgodnej etykiety.
4. Wprowadź pytanie
Wybierz Single value w Value source. Wpisz 2 w Value (x). Nie przypisuje się kolumn arkusza.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Sprawdź pytanie
Sprawdź 25 niezależnych etykiet, zakładając dla każdej 4% prawdopodobieństwa niezgodności. Pytanie dotyczy co najwyżej dwóch niezgodnych etykiet.
Odczytaj obliczoną wartość
CDF P(X ≤ x) wynosi 0.923517, czyli około 92.35%. Sumuje prawdopodobieństwa znalezienia zera, jednej lub dwóch niezgodnych etykiet.
Zrozum znaczenie wyniku
Survival P(X ≥ x) wynosi 0.264190. Obejmuje również dwa, więc oba wyświetlone ogony nakładają się. Prawdopodobieństwo liczby większej niż dwa wynosi 1 − 0.923517 = 0.076483, czyli około 7.65%.
Stosuj model ostrożnie
Użyj prawdopodobieństwa odpowiadającego regule decyzyjnej. Przed zastosowaniem do innej partii sprawdź założony udział 4% i niezależność.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Wartości rozkładu
x jest graniczną liczbą zdarzeń. CDF obejmuje X ≤ x; funkcja przeżycia obejmuje X ≥ x. Obie zawierają przypadek dokładnie x. Skorzystaj z powyższego porównania, aby odróżnić górny ogon z włączoną granicą od dopełnienia 1 − CDF.
| x | CDF P(X ≤ x) | Funkcja przeżycia P(X ≥ x) |
|---|---|---|
| 2 | 0.923517 | 0.26419 |
Podsumowanie rozkładu
Typ odróżnia wartości ciągłe od całkowitych liczebności. Rozkład określa model. Obliczenie wskazuje PMF (prawdopodobieństwo dokładnej liczebności), PDF (gęstość), CDF (prawdopodobieństwo skumulowane) lub ICDF (kwantyl). Pozostałe wiersze zawierają aktywne parametry; są to założenia wprowadzone na karcie Inputs.
| Ustawienie | Wartość |
|---|---|
| Typ | Discrete |
| Rozkład | Binomial |
| Obliczenie | CDF |
| Liczba prób (n) | 25 |
| Prawdopodobieństwo sukcesu (p) | 0.04 |
- Dwumianowy(n=25, p=0.04)
7. Utwórz raport
Zachowaj Distribution values (lub tabelę kwantyli) oraz Distribution summary. Podaj założenia modelu, jednostkę czasu lub przedział liczebności oraz rozpatrywane pytanie. Survival P(X ≥ x) wynosi 0.264190. Obejmuje również dwa, więc oba wyświetlone ogony nakładają się. Prawdopodobieństwo liczby większej niż dwa wynosi 1 − 0.923517 = 0.076483, czyli około 7.65%. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.