

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: 位置決めピンの直径
位置決めピン150個を、毎時五個ずつ、30群に分けて測定します。図面の目標値は12.000 mm、規格区間は11.950–12.050 mmです。工程の安定性は確認されていません。
位置決めピンのサンプルをダウンロード(CSV、列名は英語)Help で使用している例と同じです。diameter_mm はmm単位の直径、subgroup_id はピン五個ずつの各群を識別します。他の列は、収集順序、時刻、群内での位置を記録しています。
1. 作業環境を作成
サイドバーで Process control を開き、Capability & Performance を選択して分析名を入力します。New blank worksheet と Create analysis を選択します。
2. データをインポート
Worksheet で Import を選択します。ダウンロードしたファイルを選ぶか、その内容を貼り付けます。区切り文字を Comma、小数点記号を Decimal dot に設定し、First row contains column names を選択します。インポート内容をプレビューし、Import into worksheet を選択します。行は収集順のまま保ちます。
3. 入力列を割り当て
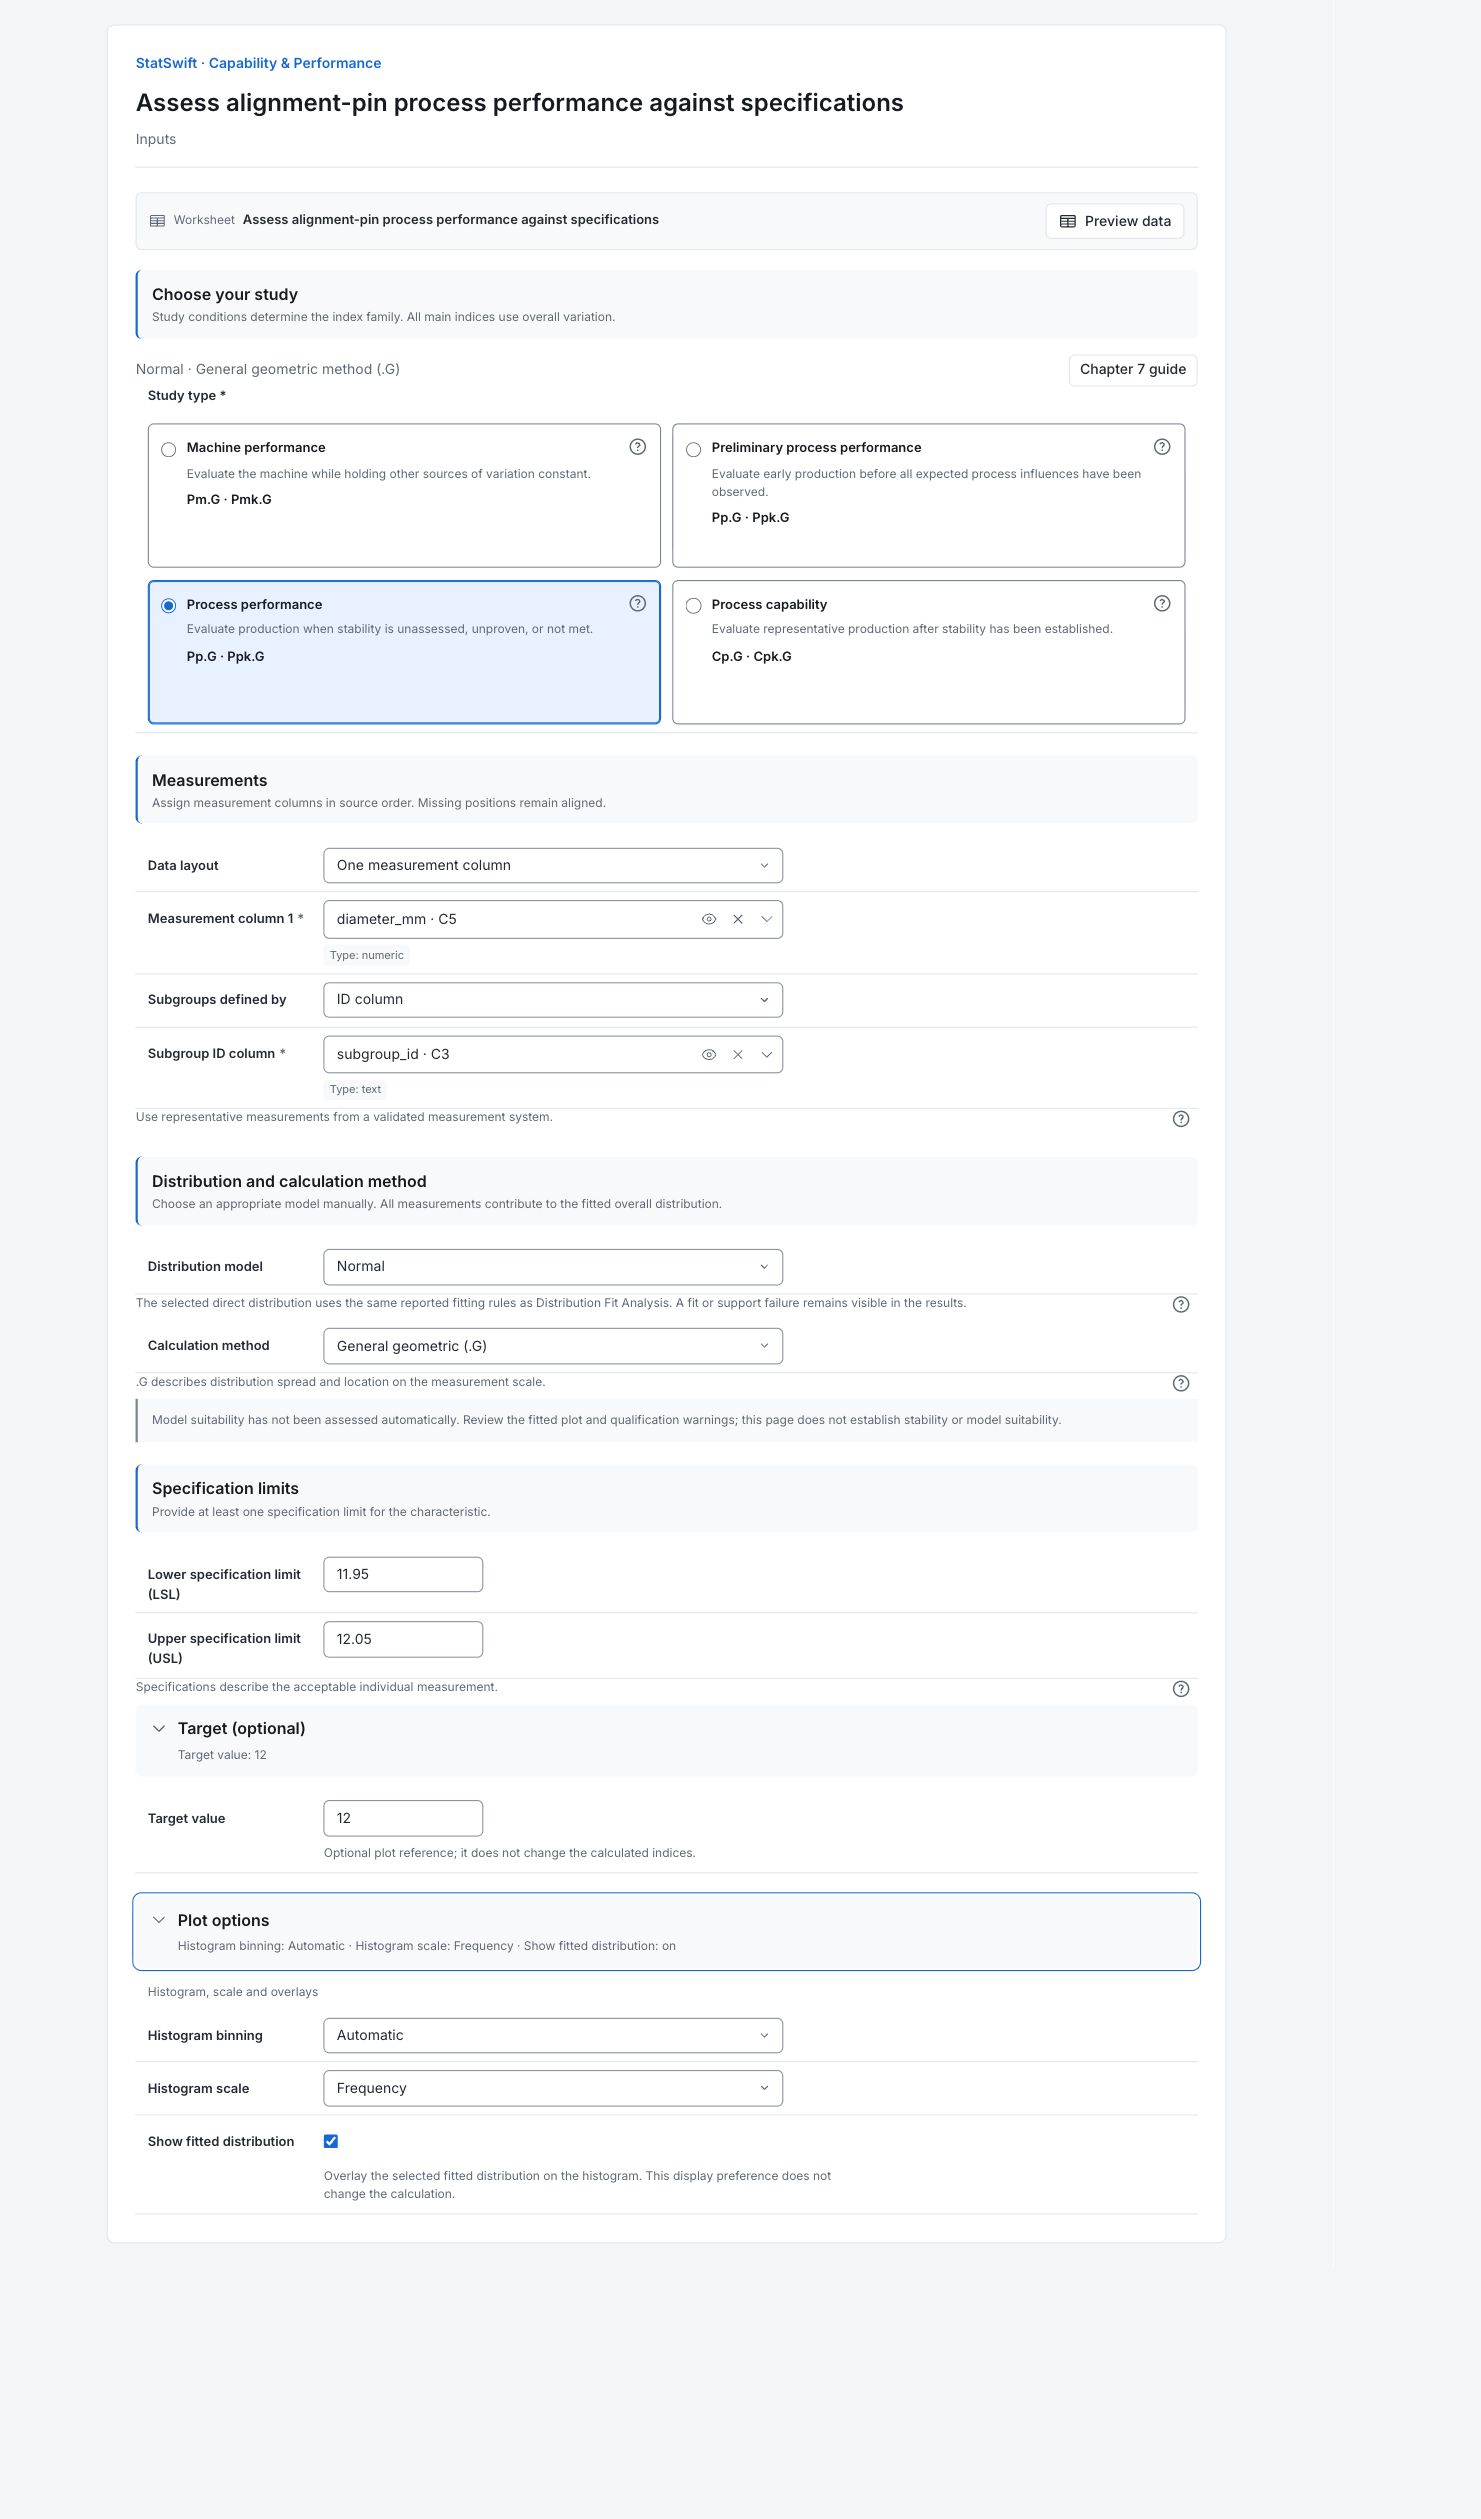
Inputs の Study type で Process performance を選択します。Data layout を One measurement column、Subgroups defined by を ID column に設定します。列選択を使って、diameter_mm を Measurement column 1、subgroup_id を Subgroup ID column に割り当てます。
4. モデルと規格を設定
Distribution model で Normal、Calculation method で General geometric (.G) を選択します。Lower specification limit (LSL) に11.950、Upper specification limit (USL) に12.050を入力します。Target (optional) を開き、Target value に12.000を入力します。三つの値の単位はすべてmmです。
Plot options を開きます。Histogram binning を Automatic、Histogram scale を Frequency に設定します。Show fitted distribution は選択したままにします。接尾辞.Gは、パフォーマンス指数を計算するために選択した General geometric (.G) を識別するもので、別のピン測定値の集合ではありません。
5. 分析を実行
Run analysis を選択し、Results を開きます。
6. 結果を解釈
調査の位置付けを理解
この分析では、指定した図面規格に対する工程全体のパフォーマンスを記述します。工程の安定性が確認されていないため、この結果によって工程能力が示されるわけではありません。
ピンを規格と比較
ピン150個すべての直径が11.950–12.050 mmの範囲内にあります。平均は12.0124 mmで、目標値12.000 mmより高く、規格上限に近い位置です。曲線は当てはめた正規モデルを示します。規格線はピンの直径の合格範囲を示すもので、管理限界ではありません。

英語のグラフ:mm単位のピン直径150個と、規格限界、目標値、当てはめた正規曲線。 グラフを原寸で表示 (新しいタブで開きます) 当てはめたモデルを確認
プロットの両端も含め、点と正規分布の基準線を比較します。アプリは、このモデルが適切かどうかを自動評価していません。このプロットでは時間的な安定性も確認できないため、適切な管理図を別途確認します。

英語のグラフ:ピン直径の正規確率プロット。裾も含めて当てはまりを確認します。 グラフを原寸で表示 (新しいタブで開きます) パフォーマンス指数を確認
接尾辞.Gは、選択した一般幾何学的計算法を表します。Pp.Gは、当てはめた分布の広がりを規格幅に対して記述します。Ppk.Gでは、規格限界の間での平均の位置も考慮します。ここではPp.Gが1.391、Ppk.Gが1.046で、規格上限側が制約となっています。
観測された不適合とモデルの推定を分ける
標本中のピンに規格外れはありません。それでも正規モデルは、ピン百万個当たり約854個が不適合となり、その大半が規格上限を超えると推定します。PPMは百万個当たりの個数を意味します。ピン150個で不適合品がゼロでも、長期的な不適合率がゼロとは限りません。この推定は、モデルが適切であることに依存します。
調査する内容を決める
平均が目標値を上回る理由と、規格上限までの余裕を検討します。収集順に工程の安定性を確認し、モデルに関する留保事項も見直します。観測された不適合品がゼロであることと、モデルの推定値は分けて報告します。計算の妥当性確認に関する記載によって、工程の安定性やモデルの適切さが示されるわけではありません。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
工程パフォーマンス指数
Pp.Gは1.391、Ppk.Gは1.046です。上限側の指数が小さいことは、規格上限への近さがモデル上のパフォーマンスを制約していることを示します。これらの指数には、データ全体の変動を用いています。統計的管理状態を示したり、将来のパフォーマンスを保証したりするものではありません。
| 統計量 | 値 |
|---|---|
| Pp.G | 1.39063 |
| PpL.G · 規格下限側 | 1.7357 |
| PpU.G · 規格上限側 | 1.04557 |
| Ppk.G | 1.04557 |
- 主たるC指数とP指数は、すべて全体変動を表します。名称は調査条件を識別するもので、群内変動に置き換えてはいません。
- 一般幾何学的指数は、規格までの距離を、当てはめた分布の中央値と0.135/99.865パーセンタイルに照らして比較します。正規モデルでは、平均 ± 3標本標準偏差(SD)を用いて計算します。
- 同じ当てはめモデルについて指数の計算法を変えても、モデルが推定する規格外れ確率は変わりません。
- —は利用できない結果を示し、その理由が併記されます。
観測された不適合と予測される不適合
この標本では、規格外れの品は観測されていません。それでも正規モデルは、百万個当たり約854個が規格外となり、そのほぼすべてが上限を超えると推定します。これは当てはめた分布の裾を外挿した推定であり、観測された欠陥数ではありません。
| 規格の側 | 観測個数 | 観測ppm | 予測ppm |
|---|---|---|---|
| LSL未満 | 0 | 0 | 0.0959132 |
| USL超 | 0 | 0 | 854.265 |
| 合計 | 0 | 0 | 854.361 |
- 観測値は、規格限界の厳密に外側にある測定値を数えます。予測値には、選択して当てはめた分布を使用します。観測された不適合品がゼロでも、将来のリスクがゼロであることは示されません。
- 適用対象外とは、その側の規格限界が指定されていないことを意味します。分布の自然な境界は、規格限界ではありません。
調査とモデル
これは、一般幾何学的計算法と全体変動を用いた、正規モデルによる工程パフォーマンスの調査です。計算の妥当性確認に関する留保事項は実装についての記載であり、このデータの安定性や適切さを保証するものではありません。
| 設定 | 値 |
|---|---|
| 分析種別 | 工程パフォーマンス |
| 選択した分布モデル | Normal |
| 計算方法 | 一般幾何法(.G) |
| 主要指標が表す変動 | 全データにおける全体変動 |
| パラメータの推定方法 | Distribution Fit Analysisが報告した当てはめ |
| 位置パラメータ(元の単位) | 12.0124 |
| 尺度パラメータ(元の単位) | 0.0119849 |
| モデル分布の台(値を取り得る範囲) | 下端:下限なし、上端:上限なし |
| 規格下限 | 11.95 |
| 規格上限 | 12.05 |
| Fit | 利用可能 |
| モデルの取得元 | 今回の工程能力分析で当てはめ済み |
| 計算の検証 | 工程能力の計算を検証用データセットと照合しました。 |
- 参照:AIAG–VDA SPC、2026年二月イエローボリューム、第7章(§7.8.2)。
- 選択した分布は、特に裾を含めて測定値を適切に記述する必要があります。ヒストグラムと分布プロットは目視での検討に役立ちますが、この分析によってモデルの適切さや統計的安定性が示されるわけではありません。
- 自動的な合否判定や1.5σシフトは適用されません。
標本統計量
観測値150個、平均、全体の標準偏差を確認します。主たる工程パフォーマンス指数には全体変動を使用します。群IDがあっても、安定した工程の能力が実証された調査になるわけではありません。
| 統計量 | 値 |
|---|---|
| 観測数(n) | 150 |
| 平均 | 12.0124 |
| 標準偏差(全体) | 0.0119849 |
等価正規Z値の詳細
各裾のZ値は、当てはめた不適合確率を、等価な正規分布上の距離に変換します。Z.Benchは、両側を合計した不適合確率を変換したものです。両裾がある場合、単純に最小の指数を三倍した値にはなりません。1.5σシフトは適用しません。これらはモデルから導いた値であり、時間的安定性の診断ではありません。
| 裾 | 予測不適合確率 | 等価正規Z値 |
|---|---|---|
| 規格下限側 | 9.59132e-8 | 5.20709 |
| 規格上限側 | 0.000854265 | 3.13671 |
| 該当する両裾(Z.Bench) | 0.000854361 | 3.13668 |
- 各側のZ値は、当てはめた不適合側の裾確率に対応する標準正規分布の上側確率の逆関数で求めます。Zスコア法では、その側の指数はZ / 3です。
- Z.Benchは、両側を合計した不適合確率を変換します。両裾が寄与する場合、最小の工程能力指数の三倍にはなりません。1.5σシフトは適用しません。
群内の診断
群内標準偏差(SD)、推定方法、使用できる群、算入・除外された観測値、およびCw/Cwkの項目は、工程改善のための診断として読み取ります。群内変動を固有の変動とみなすには、安定性が必要です。主たる指数との差があっても、安定性が示されるわけではありません。アプリでは、この診断セクションは正式なレポートから省かれますが、Resultsでは確認できます。
工程改善のためだけに使用します。この診断は正式なレポートからは省かれます(§7.8.2.5)。
| 統計量 | 値 |
|---|---|
| Cw | 1.34141 |
| Cwk | 1.00856 |
| 標準偏差(群内) | 0.0124248 |
| 推定量 | R̄ / d₂ |
| 利用可能な群数 | 30 |
| 群内推定に含めた観測数 | 150 |
| 群内推定から除外した観測数 | 0 |
- 群内変動を固有の変動として解釈するには、統計的安定性が必要です。主たる指数と群内指数の差だけでは、安定性は示されません。
- すべての測定値は、全体の計算に残ります。観測値が一つだけの群と、指定した固定サイズに満たない末尾の群は、群内推定からだけ除外されます。全体の標準偏差で置き換えることはありません。
7. レポートを作成
Capability & performance histogram、Normal probability plot、Study and model、Sample statistics、Process performance indices、Observed and expected nonconformance、Equivalent normal Z details を残します。モデルに関する留保事項も含めます。安定性が未確認であることを明記し、観測された不適合品がゼロであることと、モデルの裾に基づく推定値を区別します。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。