

ऐप के कमांड, वर्कशीट के पहचानकर्ता और उदाहरण डेटा के मान अपने मूल रूप में हैं। स्क्रीनशॉट, चार्ट और डाउनलोड अंग्रेज़ी में हैं। वैज्ञानिक उदाहरणों में मूल दशमलव बिंदु और हज़ारों के लिए अल्पविराम सुरक्षित हैं; वेबसाइट की कीमतें और गिनती स्थानीय स्वरूप में दिखाई जाती हैं।
उदाहरण: संरेखण पिन के व्यास
दल पाँच-पाँच के 30 प्रति घंटा समूहों में 150 संरेखण पिन मापता है। ड्रॉइंग का लक्ष्य 12.000 mm और विनिर्देश अंतराल 11.950–12.050 mm है। प्रक्रिया की स्थिरता स्थापित नहीं हुई है।
संरेखण पिन का उदाहरण डाउनलोड करें (CSV)यह Help में इस्तेमाल किया गया वही उदाहरण है। diameter_mm में mm में व्यास है; subgroup_id पाँच पिन के हर समूह की पहचान करता है। दूसरे कॉलम संग्रह का क्रम, समय और समूह के भीतर स्थान दर्ज करते हैं।
1. कार्यक्षेत्र बनाएँ
साइडबार में Process control खोलें, Capability & Performance चुनें और विश्लेषण को नाम दें। New blank worksheet और Create analysis चुनें।
2. डेटा आयात करें
Worksheet में Import चुनें। डाउनलोड की गई फ़ाइल चुनें या उसकी सामग्री चिपकाएँ। विभाजक Comma रखें, Decimal dot इस्तेमाल करें और First row contains column names चुनें। आयात का पूर्वावलोकन देखें, फिर Import into worksheet चुनें। पंक्तियाँ संग्रह के क्रम में रखें।
3. इनपुट कॉलम चुनें
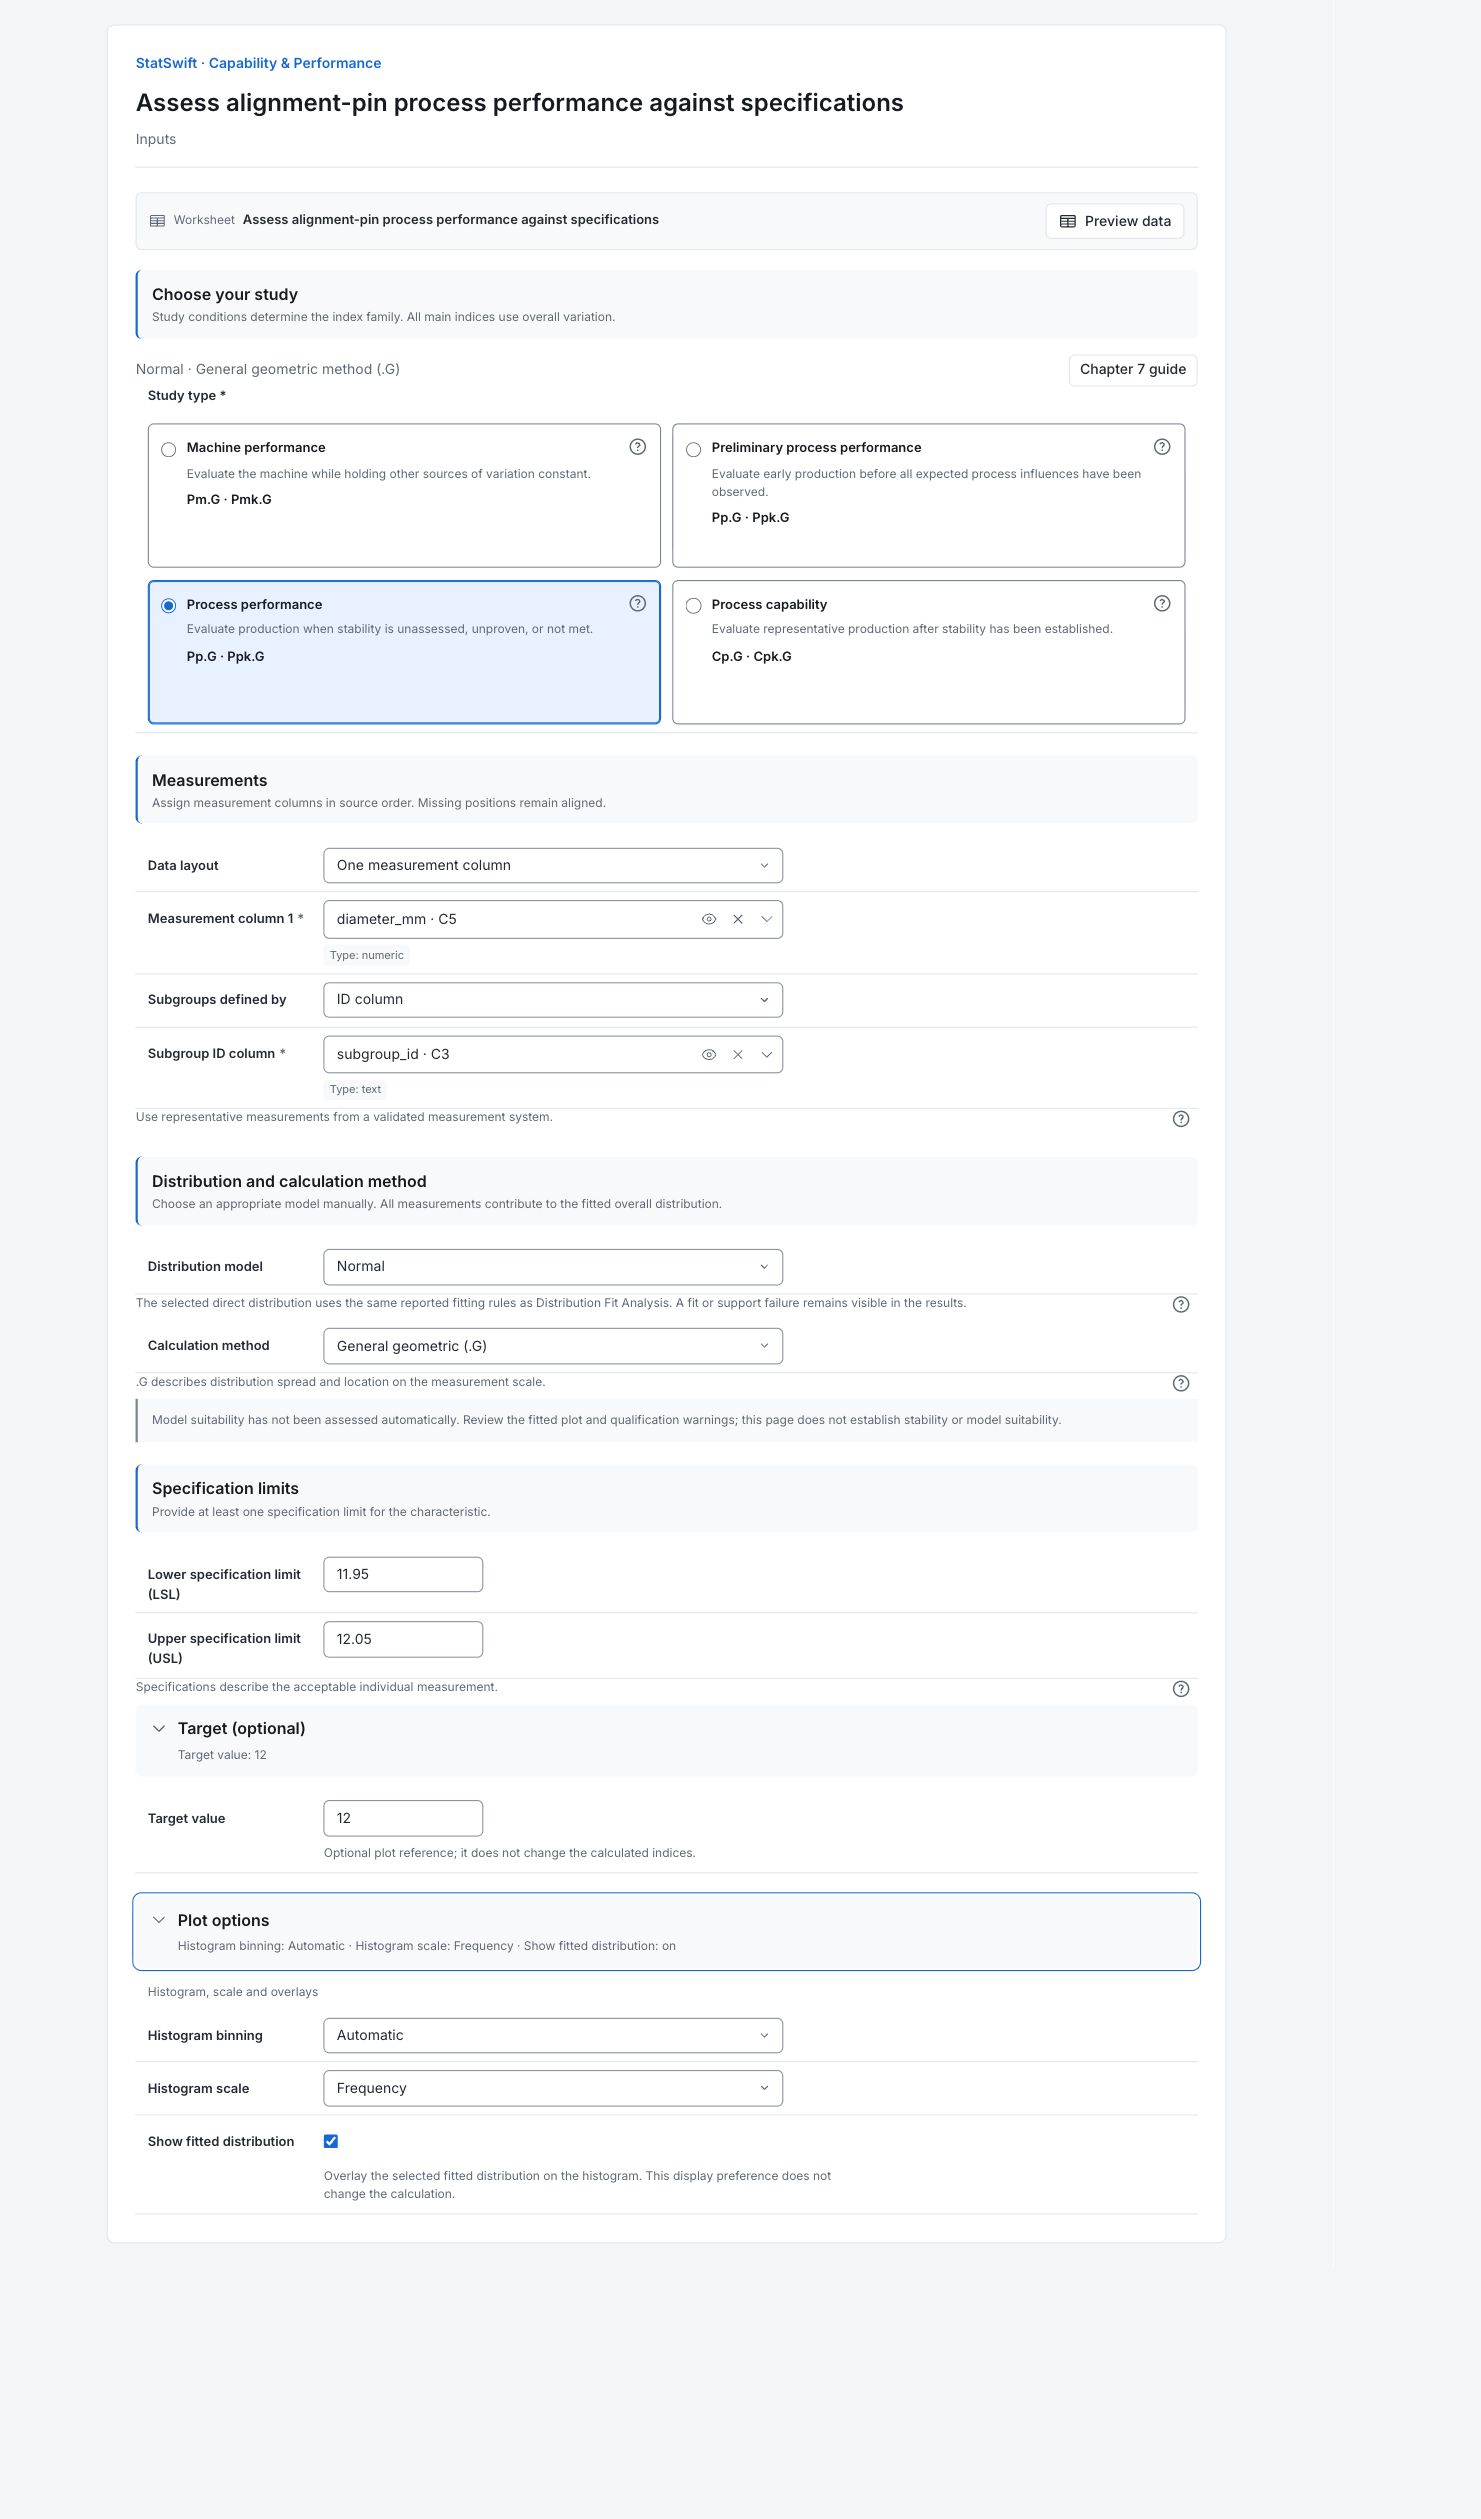
Inputs में Study type के अंतर्गत Process performance चुनें। Data layout को One measurement column और Subgroups defined by को ID column पर सेट करें। कॉलम चयनकर्ता से diameter_mm को Measurement column 1 और subgroup_id को Subgroup ID column से जोड़ें।
4. मॉडल और विनिर्देश सेट करें
Distribution model में Normal और Calculation method में General geometric (.G) चुनें। Lower specification limit (LSL) में 11.950 और Upper specification limit (USL) में 12.050 दर्ज करें। Target (optional) खोलें और Target value में 12.000 दर्ज करें। तीनों मान mm में हैं।
Plot options खोलें। Histogram binning को Automatic और Histogram scale को Frequency पर सेट करें। Show fitted distribution चयनित रखें। .G प्रत्यय General geometric (.G) की पहचान करता है, जो निष्पादन सूचकांकों की गणना का चुना हुआ तरीका है; यह पिन के मापों का दूसरा समूह नहीं है।
5. विश्लेषण चलाएँ
Run analysis चुनें, फिर Results खोलें।
6। परिणामों की व्याख्या करें
अध्ययन समझें
यह रन दी गई ड्रॉइंग के विनिर्देशों के सापेक्ष समग्र प्रक्रिया-निष्पादन बताता है। प्रक्रिया की स्थिरता स्थापित नहीं है, इसलिए परिणाम प्रक्रिया की क्षमता स्थापित नहीं करते हैं।
पिन की तुलना विनिर्देशों से करें
सभी 150 पिन के व्यास 11.950–12.050 mm के भीतर हैं। उनका औसत 12.0124 mm है: 12.000 mm के लक्ष्य से ऊपर और ऊपरी विनिर्देश के निकट। वक्र फ़िट किया गया सामान्य मॉडल है। विनिर्देश रेखाएँ स्वीकार्य पिन व्यास बताती हैं; वे नियंत्रण सीमाएँ नहीं हैं।

विनिर्देश सीमाओं, लक्ष्य और फ़िट किए गए सामान्य वक्र सहित mm में 150 पिन के व्यास। पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) फ़िट किया गया मॉडल जाँचें
आलेख के सिरों सहित बिंदुओं की तुलना सामान्य संदर्भ रेखा से करें। ऐप ने अपने आप नहीं आँका है कि यह मॉडल उपयुक्त है या नहीं। यह आलेख समय के साथ स्थिरता भी स्थापित नहीं कर सकता है; उपयुक्त नियंत्रण चार्ट अलग से पढ़ें।

पिन व्यास का सामान्य प्रायिकता आलेख। पूँछों सहित फ़िट की समीक्षा करें। पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) निष्पादन सूचकांक पढ़ें
.G प्रत्यय चुनी गई सामान्य ज्यामितीय गणना विधि का नाम है। Pp.G विनिर्देश की चौड़ाई के सापेक्ष फ़िट किया गया फैलाव बताता है। Ppk.G सीमाओं के बीच औसत के स्थान का भी ध्यान रखता है। यहाँ Pp.G, 1.391 और Ppk.G, 1.046 है; ऊपरी विनिर्देश सीमित करने वाला पक्ष है।
प्रेक्षित और मॉडल-आधारित विफलताएँ अलग करें
नमूने का कोई पिन विनिर्देशों में विफल नहीं है। फिर भी सामान्य मॉडल प्रति दस लाख पिन लगभग 854 विफलताओं का अनुमान देता है, अधिकतर ऊपरी विनिर्देश के ऊपर। PPM का मतलब प्रति दस लाख भाग है। 150 पिन में शून्य प्रेक्षित विफलता का मतलब शून्य दीर्घकालिक विफलता दर नहीं है। मॉडल का अनुमान मॉडल के उपयुक्त होने पर निर्भर है।
तय करें कि क्या जाँचना है
जाँचें कि औसत लक्ष्य से ऊपर क्यों है और ऊपरी विनिर्देश तक कितना अंतर बचा है। संग्रह क्रम में प्रक्रिया की स्थिरता जाँचें और मॉडल की सीमाएँ पढ़ें। शून्य प्रेक्षित विफलता को मॉडल के अनुमान से अलग बताएँ; गणना के सत्यापन के कथन प्रक्रिया की स्थिरता या मॉडल की उपयुक्तता स्थापित नहीं करते हैं।
और जानकारी: परिणाम का हर खंड पढ़ें
परिणामों की पूरी तालिकाओं में Help की तरह छह सार्थक अंक हैं।
प्रक्रिया-निष्पादन सूचकांक
Pp.G, 1.391 और Ppk.G, 1.046 है। ऊपरी पक्ष का छोटा सूचकांक दिखाता है कि ऊपरी विनिर्देश की निकटता मॉडल-आधारित निष्पादन सीमित करती है। ये सूचकांक डेटासेट की समग्र परिवर्तनशीलता इस्तेमाल करते हैं। वे सांख्यिकीय नियंत्रण स्थापित नहीं करते या भविष्य के निष्पादन की गारंटी नहीं देते हैं।
| सांख्यिक | मान |
|---|---|
| Pp.G | 1.39063 |
| PpL.G · निचला विनिर्देश | 1.7357 |
| PpU.G · ऊपरी विनिर्देश | 1.04557 |
| Ppk.G | 1.04557 |
- सभी मुख्य C और P सूचकांक समग्र परिवर्तनशीलता दर्शाते हैं। उनके नाम अध्ययन की परिस्थितियाँ पहचानते हैं; उपसमूह के भीतर की परिवर्तनशीलता उनके स्थान पर नहीं रखी जाती है।
- सामान्य ज्यामितीय सूचकांक विनिर्देश की दूरियों की तुलना फ़िट किए गए वितरण की माध्यिका और 0.135वें / 99.865वें प्रतिशतकों से करते हैं। सामान्य मॉडल के लिए गणना औसत ± 3 नमूना मानक विचलन इस्तेमाल करती है।
- उसी फ़िट किए गए मॉडल के लिए सूचकांक विधि बदलने से उसकी अनुमानित विनिर्देश-बाह्य प्रायिकताएँ नहीं बदलती हैं।
- — अनुपलब्ध परिणाम बताता है; कारण उसके साथ दिखाया जाता है।
प्रेक्षित और अपेक्षित गैर-अनुरूपता
इस नमूने में विनिर्देशों से बाहर कोई इकाई नहीं दिखी। फिर भी सामान्य मॉडल प्रति दस लाख लगभग 854 भाग विनिर्देशों से बाहर होने का अनुमान देता है, लगभग सभी ऊपरी सीमा के ऊपर। वह अनुमान फ़िट की गई पूँछों का बहिर्वेशन है; यह प्रेक्षित दोषों की संख्या नहीं है।
| विनिर्देश का पक्ष | प्रेक्षित संख्या | प्रेक्षित ppm | अपेक्षित ppm |
|---|---|---|---|
| LSL से नीचे | 0 | 0 | 0.0959132 |
| USL से ऊपर | 0 | 0 | 854.265 |
| कुल | 0 | 0 | 854.361 |
- प्रेक्षित मान उन मापों को गिनते हैं जो विनिर्देश सीमाओं से सख्ती से बाहर हैं। अपेक्षित मान चुना हुआ फ़िट किया गया वितरण इस्तेमाल करते हैं; शून्य प्रेक्षित विफलता शून्य भविष्य का जोखिम स्थापित नहीं करती है।
- लागू नहीं का मतलब है कि उस पक्ष की विनिर्देश सीमा दी नहीं गई थी। प्राकृतिक सीमा विनिर्देश सीमा नहीं है।
अध्ययन और मॉडल
यह सामान्य ज्यामितीय विधि और समग्र परिवर्तनशीलता वाला सामान्य-मॉडल प्रक्रिया-निष्पादन अध्ययन है। गणना-सत्यापन की सीमा कार्यान्वयन से जुड़ी है; वह इन डेटा की स्थिरता या उपयुक्तता प्रमाणित नहीं करती है।
| सेटिंग | मान |
|---|---|
| अध्ययन | प्रक्रिया प्रदर्शन |
| चुना गया वितरण मॉडल | Normal |
| गणना की विधि | सामान्य ज्यामितीय (.G) |
| मुख्य सूचकांकों से दर्शाई गई परिवर्तनशीलता | पूरे डेटा में समग्र परिवर्तनशीलता |
| प्राचल आकलक | Distribution Fit Analysis में रिपोर्ट किया गया फिट |
| स्थिति (मूल इकाइयों में) | 12.0124 |
| स्केल (मूल इकाइयों में) | 0.0119849 |
| वितरण मॉडल का मान-क्षेत्र | निचला अंतिम बिंदु: असीमित; ऊपरी अंतिम बिंदु: असीमित |
| निचली विनिर्देश सीमा | 11.95 |
| ऊपरी विनिर्देश सीमा | 12.05 |
| Fit | उपलब्ध |
| मॉडल का स्रोत | इस क्षमता विश्लेषण के लिए फिट किया गया |
| सत्यापन | क्षमता की गणनाएँ सत्यापन डेटा से जाँची गईं। |
- संदर्भ: AIAG–VDA SPC, फ़रवरी 2026 पीला खंड, अध्याय 7 (§7.8.2)।
- चुना हुआ वितरण मापों का, विशेषकर उनकी पूँछों का, पर्याप्त वर्णन करना चाहिए। हिस्टोग्राम और वितरण आलेख दृश्य समीक्षा में मदद करते हैं; यह रन मॉडल की उपयुक्तता या सांख्यिकीय स्थिरता स्थापित नहीं करता है।
- अपने आप स्वीकृति का निर्णय या 1.5σ खिसकाव लागू नहीं किया जाता है।
नमूने के सांख्यिक
150 प्रेक्षणों, औसत और समग्र मानक विचलन की पुष्टि करें। समग्र परिवर्तनशीलता मुख्य प्रक्रिया-निष्पादन सूचकांकों का आधार है। उपसमूह ID इसे प्रदर्शित स्थिर-प्रक्रिया क्षमता अध्ययन में नहीं बदलते हैं।
| सांख्यिक | मान |
|---|---|
| प्रेक्षण (n) | 150 |
| औसत | 12.0124 |
| मानक विचलन (समग्र) | 0.0119849 |
तुल्य सामान्य Z का विवरण
हर पूँछ का Z उसकी फ़िट की गई विफलता प्रायिकता को तुल्य सामान्य दूरी में बदलता है। Z.Bench संयुक्त विफलता प्रायिकता बदलता है; दो पूँछ होने पर यह केवल सबसे छोटे सूचकांक का तीन गुना नहीं है। कोई 1.5σ खिसकाव लागू नहीं किया जाता है। ये मॉडल से निकले मान हैं, समय-स्थिरता के निदान नहीं।
| पूँछ | अपेक्षित विफलता प्रायिकता | तुल्य सामान्य Z |
|---|---|---|
| निचला विनिर्देश | 9.59132e-8 | 5.20709 |
| ऊपरी विनिर्देश | 0.000854265 | 3.13671 |
| दोनों लागू पूँछें (Z.Bench) | 0.000854361 | 3.13668 |
- हर पक्ष का Z, उस फ़िट की गई विफलता पूँछ की सामान्य उत्तरजीविता प्रायिकता का प्रतिलोम है। Z-स्कोर विधि में उस पक्ष का सूचकांक Z / 3 के बराबर है।
- Z.Bench संयुक्त विफलता प्रायिकता बदलता है। दो योगदान देने वाली पूँछों पर यह न्यूनतम क्षमता सूचकांक का तीन गुना नहीं है। कोई 1.5σ खिसकाव लागू नहीं किया जाता है।
उपसमूह के भीतर के निदान
उपसमूह के भीतर के मानक विचलन, आकलक, उपयोगी समूहों, शामिल/बाहर प्रेक्षणों और किसी Cw/Cwk प्रविष्टि को प्रक्रिया में सुधार के निदान के रूप में पढ़ें। भीतर की परिवर्तनशीलता को अंतर्निहित परिवर्तनशीलता मानने से पहले स्थिरता आवश्यक है। मुख्य सूचकांकों से अंतर स्थिरता स्थापित नहीं करता है। मूल ऐप यह निदान खंड औपचारिक रिपोर्टों में नहीं देता है; यह Results में उपलब्ध रहता है।
केवल प्रक्रिया में सुधार के लिए। ये निदान औपचारिक रिपोर्टों में नहीं दिए जाते हैं (§7.8.2.5)।
| सांख्यिक | मान |
|---|---|
| Cw | 1.34141 |
| Cwk | 1.00856 |
| मानक विचलन (उपसमूहों के भीतर) | 0.0124248 |
| आकलक | R̄ / d₂ |
| इस्तेमाल योग्य उपसमूह | 30 |
| भीतरी अनुमान में शामिल प्रेक्षण | 150 |
| भीतरी अनुमान से बाहर रखे गए प्रेक्षण | 0 |
- भीतर की परिवर्तनशीलता को अंतर्निहित परिवर्तनशीलता समझने के लिए सांख्यिकीय स्थिरता चाहिए। मुख्य और भीतर के सूचकांकों का अंतर अपने आप स्थिरता स्थापित नहीं करता है।
- सभी माप समग्र गणनाओं में बने रहते हैं। अकेले प्रेक्षण वाले समूह और नियत आकार के अधूरे अंतिम समूह केवल भीतर के अनुमान से बाहर रखे जाते हैं; समग्र मानक विचलन कभी उनके स्थान पर नहीं रखा जाता है।
7। रिपोर्ट बनाएँ
Capability & performance histogram, Normal probability plot, Study and model, Sample statistics, Process performance indices, Observed and expected nonconformance और Equivalent normal Z details रखें। मॉडल की सीमाएँ बनाए रखें। बताएँ कि स्थिरता स्थापित नहीं है और शून्य प्रेक्षित अस्वीकृत पिन को मॉडल की पूँछ के अनुमान से अलग रखें।
चुनें: Add to report पूरे हो चुके विश्लेषण से। खोलें: Choose individual items and advanced options —तालिकाएँ और चार्ट चुनने के लिए; फिर चुनें: Add to draft। छिपाए गए आइटम सहेजे गए विश्लेषण में बने रहते हैं।
रिपोर्ट को नाम दें और अध्ययन का उद्देश्य तथा अपनी व्याख्या जोड़ें। चुनें: Save, फिर देखें: Preview, और फिर इस्तेमाल करें: Export → Download HTML। नीचे दिए गए उदाहरण में चुनी गई पूरी सामग्री है, जिसमें एक स्क्रीन से आगे के परिणाम भी शामिल हैं।