

I comandi dell’app, gli identificatori dei fogli dati e i valori dei dati di esempio conservano la forma originale. Screenshot, grafici e file da scaricare sono in inglese. Gli esempi mantengono il punto decimale e la virgola come separatore delle migliaia della notazione inglese originale; i prezzi e i conteggi del sito seguono invece la formattazione italiana.
Esempio: diametri dei perni di allineamento
Un gruppo misura 150 perni di allineamento in 30 gruppi orari di cinque. L’obiettivo a disegno è 12.000 mm e l’intervallo di specifica è 11.950–12.050 mm. La stabilità del processo non è stata accertata.
Scarica l’esempio dei perni di allineamento (CSV)È lo stesso esempio usato in Help. diameter_mm contiene il diametro in mm; subgroup_id identifica ogni gruppo di cinque perni. Le altre colonne registrano ordine di raccolta, orario e posizione entro il gruppo.
1. Crea l’ambiente di lavoro
Nella barra laterale, apri Process control, scegli Capability & Performance e assegna un nome all’analisi. Seleziona New blank worksheet e Create analysis.
2. Importa i dati
In Worksheet, scegli Import. Seleziona il file scaricato o incollane il contenuto. Imposta il delimitatore su Comma, usa Decimal dot e seleziona First row contains column names. Controlla l’anteprima dell’importazione, poi scegli Import into worksheet. Mantieni le righe nell’ordine di raccolta.
3. Assegna le colonne in ingresso
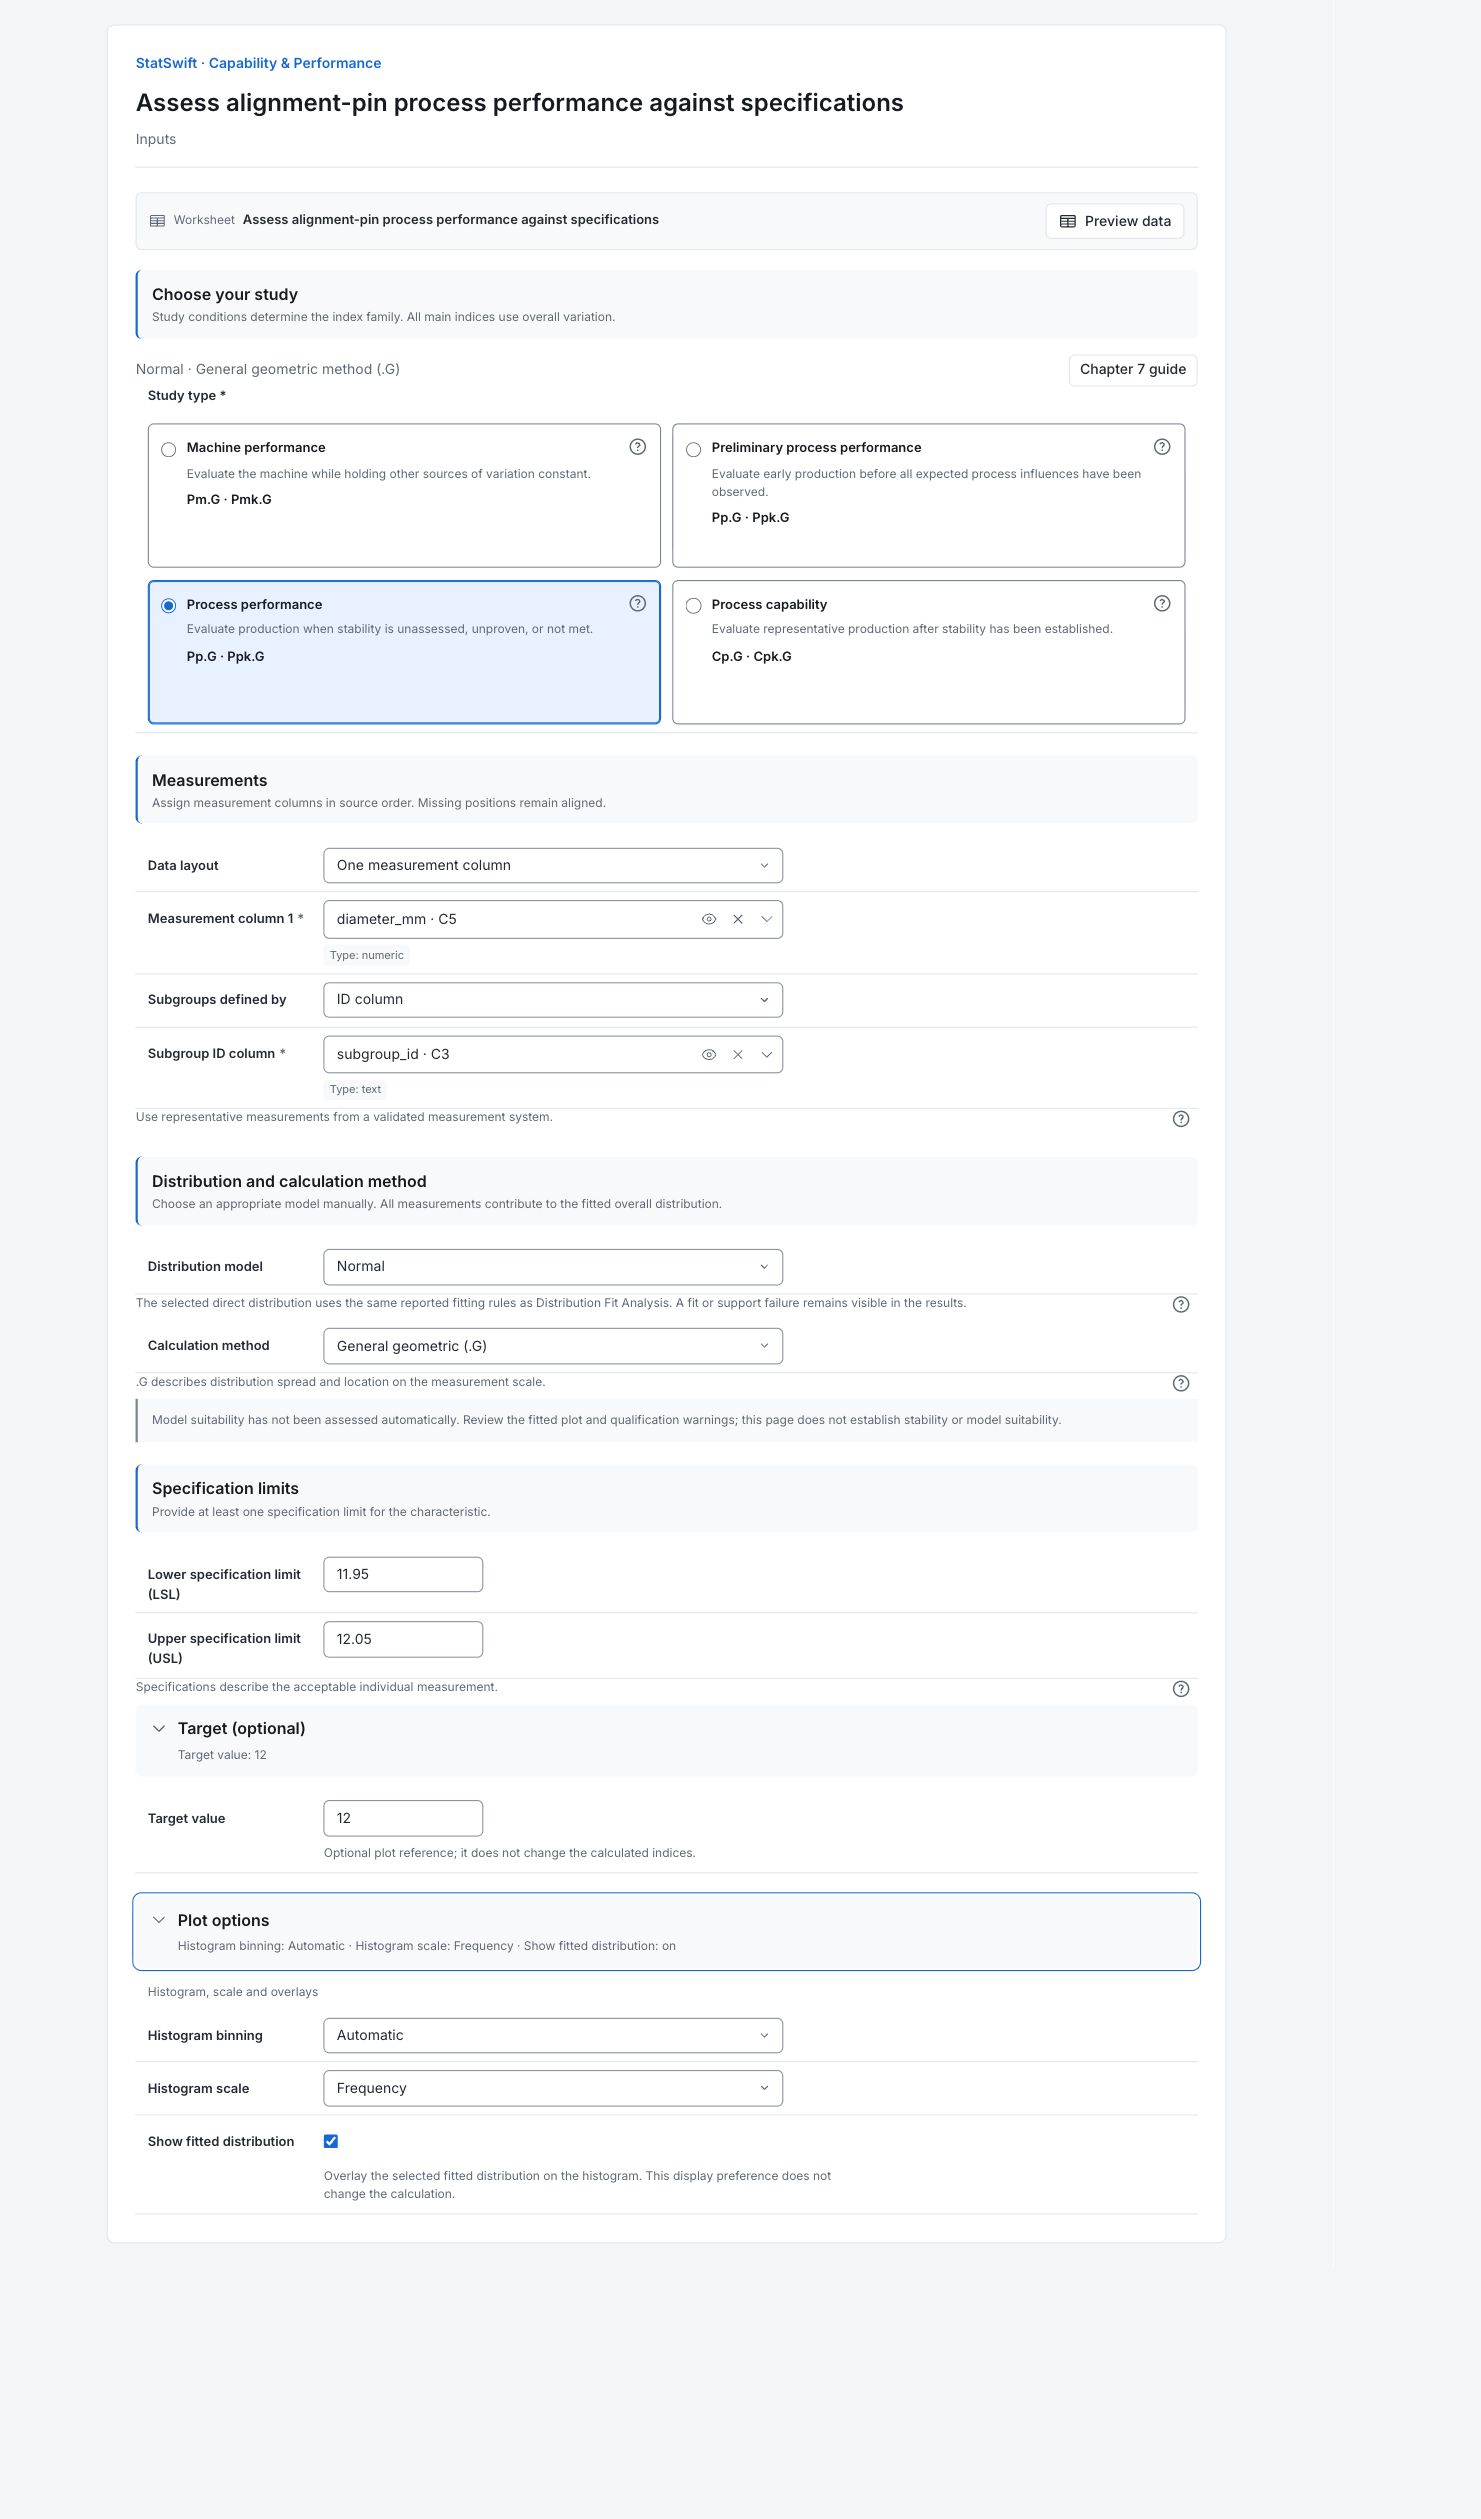
In Inputs, scegli Process performance sotto Study type. Imposta Data layout su One measurement column e Subgroups defined by su ID column. Assegna diameter_mm a Measurement column 1 e subgroup_id a Subgroup ID column, selezionando ciascuno dal selettore di colonne.
4. Imposta il modello e le specifiche
Scegli Normal sotto Distribution model e General geometric (.G) sotto Calculation method. Inserisci 11.950 in Lower specification limit (LSL) e 12.050 in Upper specification limit (USL). Apri Target (optional) e inserisci 12.000 in Target value. Tutti e tre i valori usano mm.
Apri Plot options. Imposta Histogram binning su Automatic e Histogram scale su Frequency. Lascia selezionato Show fitted distribution. Il suffisso .G identifica General geometric (.G), il modo selezionato di calcolare gli indici di prestazione; non è un altro insieme di misurazioni dei perni.
5. Esegui l’analisi
Scegli Run analysis, poi apri Results.
6. Interpreta i risultati
Comprendi lo studio
Questa esecuzione descrive le prestazioni complessive del processo rispetto alle specifiche di disegno fornite. La stabilità del processo non è stata accertata, quindi i risultati non dimostrano la capacità del processo.
Confronta i perni con le specifiche
Tutti i 150 diametri dei perni sono entro 11.950–12.050 mm. La loro media è 12.0124 mm: sopra l’obiettivo di 12.000 mm e più vicina alla specifica superiore. La curva è il modello normale stimato. Le linee di specifica descrivono i diametri accettabili dei perni; non sono limiti di controllo.

150 diametri di perni in mm, con limiti di specifica, obiettivo e curva normale stimata. Visualizza il grafico a grandezza originale (si apre in una nuova scheda) Verifica il modello stimato
Confronta i punti con la retta di riferimento normale, incluse le estremità del grafico. L’app non ha valutato automaticamente se questo modello sia adatto. Questo grafico non può neppure accertare la stabilità nel tempo; esamina separatamente una carta di controllo appropriata.

Grafico di probabilità normale dei diametri dei perni. Esamina l’adattamento, incluse le code. Visualizza il grafico a grandezza originale (si apre in una nuova scheda) Leggi gli indici di prestazione
Il suffisso .G indica il metodo di calcolo geometrico generale selezionato. Pp.G descrive la dispersione stimata rispetto all’ampiezza di specifica. Ppk.G tiene conto anche della posizione della media tra i limiti. Qui Pp.G è 1.391 e Ppk.G è 1.046; la specifica superiore è il lato limitante.
Separa le non conformità osservate da quelle del modello
Nessun perno campionato è fuori specifica. Il modello normale stima comunque circa 854 non conformità per milione di perni, soprattutto sopra la specifica superiore. PPM significa parti per milione. Zero non conformità osservate in 150 perni non significa un tasso di non conformità a lungo termine pari a zero. La stima del modello dipende dalla sua adeguatezza.
Decidi cosa indagare
Rivedi perché la media è sopra l’obiettivo e quanto margine resta fino alla specifica superiore. Verifica la stabilità del processo nell’ordine di raccolta e rivedi le precisazioni sul modello. Riporta separatamente le zero non conformità osservate e la stima del modello; le dichiarazioni di validazione del calcolo non accertano stabilità del processo o adeguatezza del modello.
Altri dettagli: leggi ogni sezione dei risultati
Le tabelle complete dei risultati usano sei cifre significative, come in Help.
Indici di prestazione del processo
Pp.G è 1.391 e Ppk.G è 1.046. L’indice minore sul lato superiore mostra che la vicinanza alla specifica superiore limita le prestazioni del modello. Questi indici usano la variabilità complessiva del dataset. Non accertano il controllo statistico né garantiscono prestazioni future.
| Statistica | Valore |
|---|---|
| Pp.G | 1.39063 |
| PpL.G · Specifica inferiore | 1.7357 |
| PpU.G · Specifica superiore | 1.04557 |
| Ppk.G | 1.04557 |
- Tutti gli indici principali C e P rappresentano la variabilità complessiva. I nomi identificano le condizioni dello studio; non si sostituisce la variabilità entro i sottogruppi.
- Gli indici geometrici generali confrontano le distanze di specifica con la mediana e i percentili 0.135 / 99.865 della distribuzione stimata. Per un modello normale, il calcolo usa media ± 3 SD campionarie.
- Cambiare il metodo degli indici per lo stesso modello stimato non cambia le sue probabilità stimate di essere fuori specifica.
- — indica un risultato non disponibile; il motivo è mostrato accanto.
Non conformità osservate e attese
In questo campione non sono stati osservati articoli fuori specifica. Il modello normale stima tuttavia circa 854 parti per milione fuori specifica, quasi interamente sopra il limite superiore. Quella stima estrapola le code del modello; non è un conteggio osservato di difetti.
| Lato della specifica | Conteggio osservato | ppm osservati | ppm attesi |
|---|---|---|---|
| Sotto LSL | 0 | 0 | 0.0959132 |
| Sopra USL | 0 | 0 | 854.265 |
| Totale | 0 | 0 | 854.361 |
- I valori osservati contano misurazioni strettamente fuori dai limiti di specifica. I valori attesi usano la distribuzione stimata selezionata; zero non conformità osservate non accertano un rischio futuro pari a zero.
- Non applicabile indica che non è stato fornito un limite di specifica su quel lato. Un confine naturale non è un limite di specifica.
Studio e modello
È uno studio delle prestazioni del processo con modello normale che usa il metodo geometrico generale e la variabilità complessiva. Una precisazione sulla validazione del calcolo riguarda l’implementazione; non certifica la stabilità o l’adeguatezza di questi dati.
| Impostazione | Valore |
|---|---|
| Studio | Prestazioni del processo |
| Modello di distribuzione selezionato | Normal |
| Metodo di calcolo | Geometrico generale (.G) |
| Variabilità rappresentata dagli indici principali | Variabilità complessiva dell’intero dataset |
| Stimatore dei parametri | Adattamento riportato da Distribution Fit Analysis |
| Posizione (unità originali) | 12.0124 |
| Scala (unità originali) | 0.0119849 |
| Supporto del modello | Estremo inferiore: illimitato; estremo superiore: illimitato |
| Limite di specifica inferiore | 11.95 |
| Limite di specifica superiore | 12.05 |
| Fit | Disponibile |
| Origine del modello | Stimato per questa analisi di capacità |
| Validazione | Calcoli di capacità verificati rispetto al dataset di validazione. |
- Riferimento: AIAG–VDA SPC, Yellow Volume di febbraio 2026, capitolo 7 (§7.8.2).
- La distribuzione selezionata deve descrivere adeguatamente le misurazioni, soprattutto le code. L’istogramma e il grafico della distribuzione supportano l’esame visivo; questa esecuzione non accerta l’adeguatezza del modello o la stabilità statistica.
- Non si applicano decisioni automatiche di accettazione né spostamenti di 1.5σ.
Statistiche campionarie
Conferma 150 osservazioni, la media e la deviazione standard complessiva. La variabilità complessiva fornisce gli indici principali di prestazione del processo. Gli identificatori dei sottogruppi non trasformano questo studio in una dimostrazione di capacità di un processo stabile.
| Statistica | Valore |
|---|---|
| Osservazioni (n) | 150 |
| Media | 12.0124 |
| Deviazione standard (complessiva) | 0.0119849 |
Dettagli di Z normale equivalente
Lo Z di ogni coda converte la sua probabilità stimata di non conformità in una distanza normale equivalente. Z.Bench converte la probabilità combinata di non conformità; con due code non è semplicemente tre volte l’indice minore. Non si applicano spostamenti di 1.5σ. Sono valori derivati dal modello, non diagnostiche della stabilità nel tempo.
| Coda | Probabilità attesa di non conformità | Z normale equivalente |
|---|---|---|
| Specifica inferiore | 9.59132e-8 | 5.20709 |
| Specifica superiore | 0.000854265 | 3.13671 |
| Entrambe le code applicabili (Z.Bench) | 0.000854361 | 3.13668 |
- Lo Z di ogni lato si ottiene applicando la funzione inversa di sopravvivenza della normale alla probabilità stimata di non conformità di quella coda. Nel metodo del punteggio Z, il suo indice laterale è uguale a Z / 3.
- Z.Bench converte la probabilità combinata di non conformità. Con due code che contribuiscono non è tre volte l’indice minimo di capacità. Non si applicano spostamenti di 1.5σ.
Diagnostica entro i sottogruppi
Leggi SD entro i sottogruppi, stimatore, gruppi utilizzabili, osservazioni incluse/escluse e le eventuali voci Cw/Cwk come diagnostica per il miglioramento del processo. È richiesta stabilità prima di considerare intrinseca la variabilità entro i sottogruppi. Una differenza rispetto agli indici principali non accerta la stabilità. L’app nativa omette questa sezione diagnostica dai rapporti formali; resta disponibile in Results.
Solo per il miglioramento del processo. Questa diagnostica è omessa dai rapporti formali (§7.8.2.5).
| Statistica | Valore |
|---|---|
| Cw | 1.34141 |
| Cwk | 1.00856 |
| Deviazione standard (entro i sottogruppi) | 0.0124248 |
| Stimatore | R̄ / d₂ |
| Sottogruppi utilizzabili | 30 |
| Osservazioni incluse nella stima entro i sottogruppi | 150 |
| Osservazioni escluse dalla stima entro i sottogruppi | 0 |
- Per interpretare la variabilità entro i sottogruppi come variabilità intrinseca è richiesta stabilità statistica. Una differenza tra gli indici principali e quelli entro i sottogruppi non accerta di per sé la stabilità.
- Tutte le misurazioni restano nei calcoli complessivi. I gruppi con una sola osservazione e i gruppi finali incompleti a numerosità fissa sono esclusi solo dalla stima entro i sottogruppi; non si sostituisce mai la deviazione standard complessiva.
7. Crea un report
Conserva Capability & performance histogram, Normal probability plot, Study and model, Sample statistics, Process performance indices, Observed and expected nonconformance e Equivalent normal Z details. Mantieni le precisazioni sul modello. Specifica che la stabilità non è accertata e distingui gli scarti osservati pari a zero dalla stima delle code del modello.
Seleziona Add to report dall’esecuzione completata. Apri Choose individual items and advanced options per selezionare tabelle e grafici, quindi scegli Add to draft. Gli elementi nascosti restano nell’analisi salvata.
Assegna un nome al report e aggiungi lo scopo dello studio e la tua interpretazione. Seleziona Save, controlla Preview, quindi usa Export → Download HTML. L’esempio seguente contiene tutti i contenuti selezionati, compresi i risultati che occupano più di una schermata.