

App-Befehle, Arbeitsblattkennungen und Werte der Beispieldaten bleiben im Original erhalten. Screenshots, Diagramme und Dateien zum Herunterladen liegen im englischen Original vor. Die Zahlen in dieser Anleitung verwenden die englische Schreibweise mit Dezimalpunkt und Tausenderkomma.
Beispiel: Passstiftdurchmesser
Ein Team misst 150 Passstifte in 30 stündlichen Gruppen mit jeweils fünf Stiften. Der Zeichnungssollwert beträgt 12.000 mm, und das Spezifikationsintervall beträgt 11.950–12.050 mm. Die Prozessstabilität ist nicht nachgewiesen.
Beispiel zu Passstiften herunterladen (CSV)Dieses Beispiel wird auch in Help verwendet. diameter_mm enthält den Durchmesser in mm; subgroup_id kennzeichnet jede Gruppe von fünf Stiften. Die weiteren Spalten erfassen Erfassungsreihenfolge, Zeitpunkt und Position innerhalb der Gruppe.
1. Arbeitsbereich erstellen
Öffnen Sie in der Seitenleiste Process control, wählen Sie Capability & Performance und benennen Sie die Analyse. Wählen Sie New blank worksheet und Create analysis.
2. Daten importieren
Wählen Sie unter Worksheet die Option Import. Wählen Sie die heruntergeladene Datei aus oder fügen Sie ihren Inhalt ein. Stellen Sie als Trennzeichen Comma und als Dezimaltrennzeichen Decimal dot ein und aktivieren Sie First row contains column names. Prüfen Sie die Importvorschau und wählen Sie anschließend Import into worksheet. Behalten Sie die Zeilen in Erfassungsreihenfolge bei.
3. Eingabespalten zuweisen
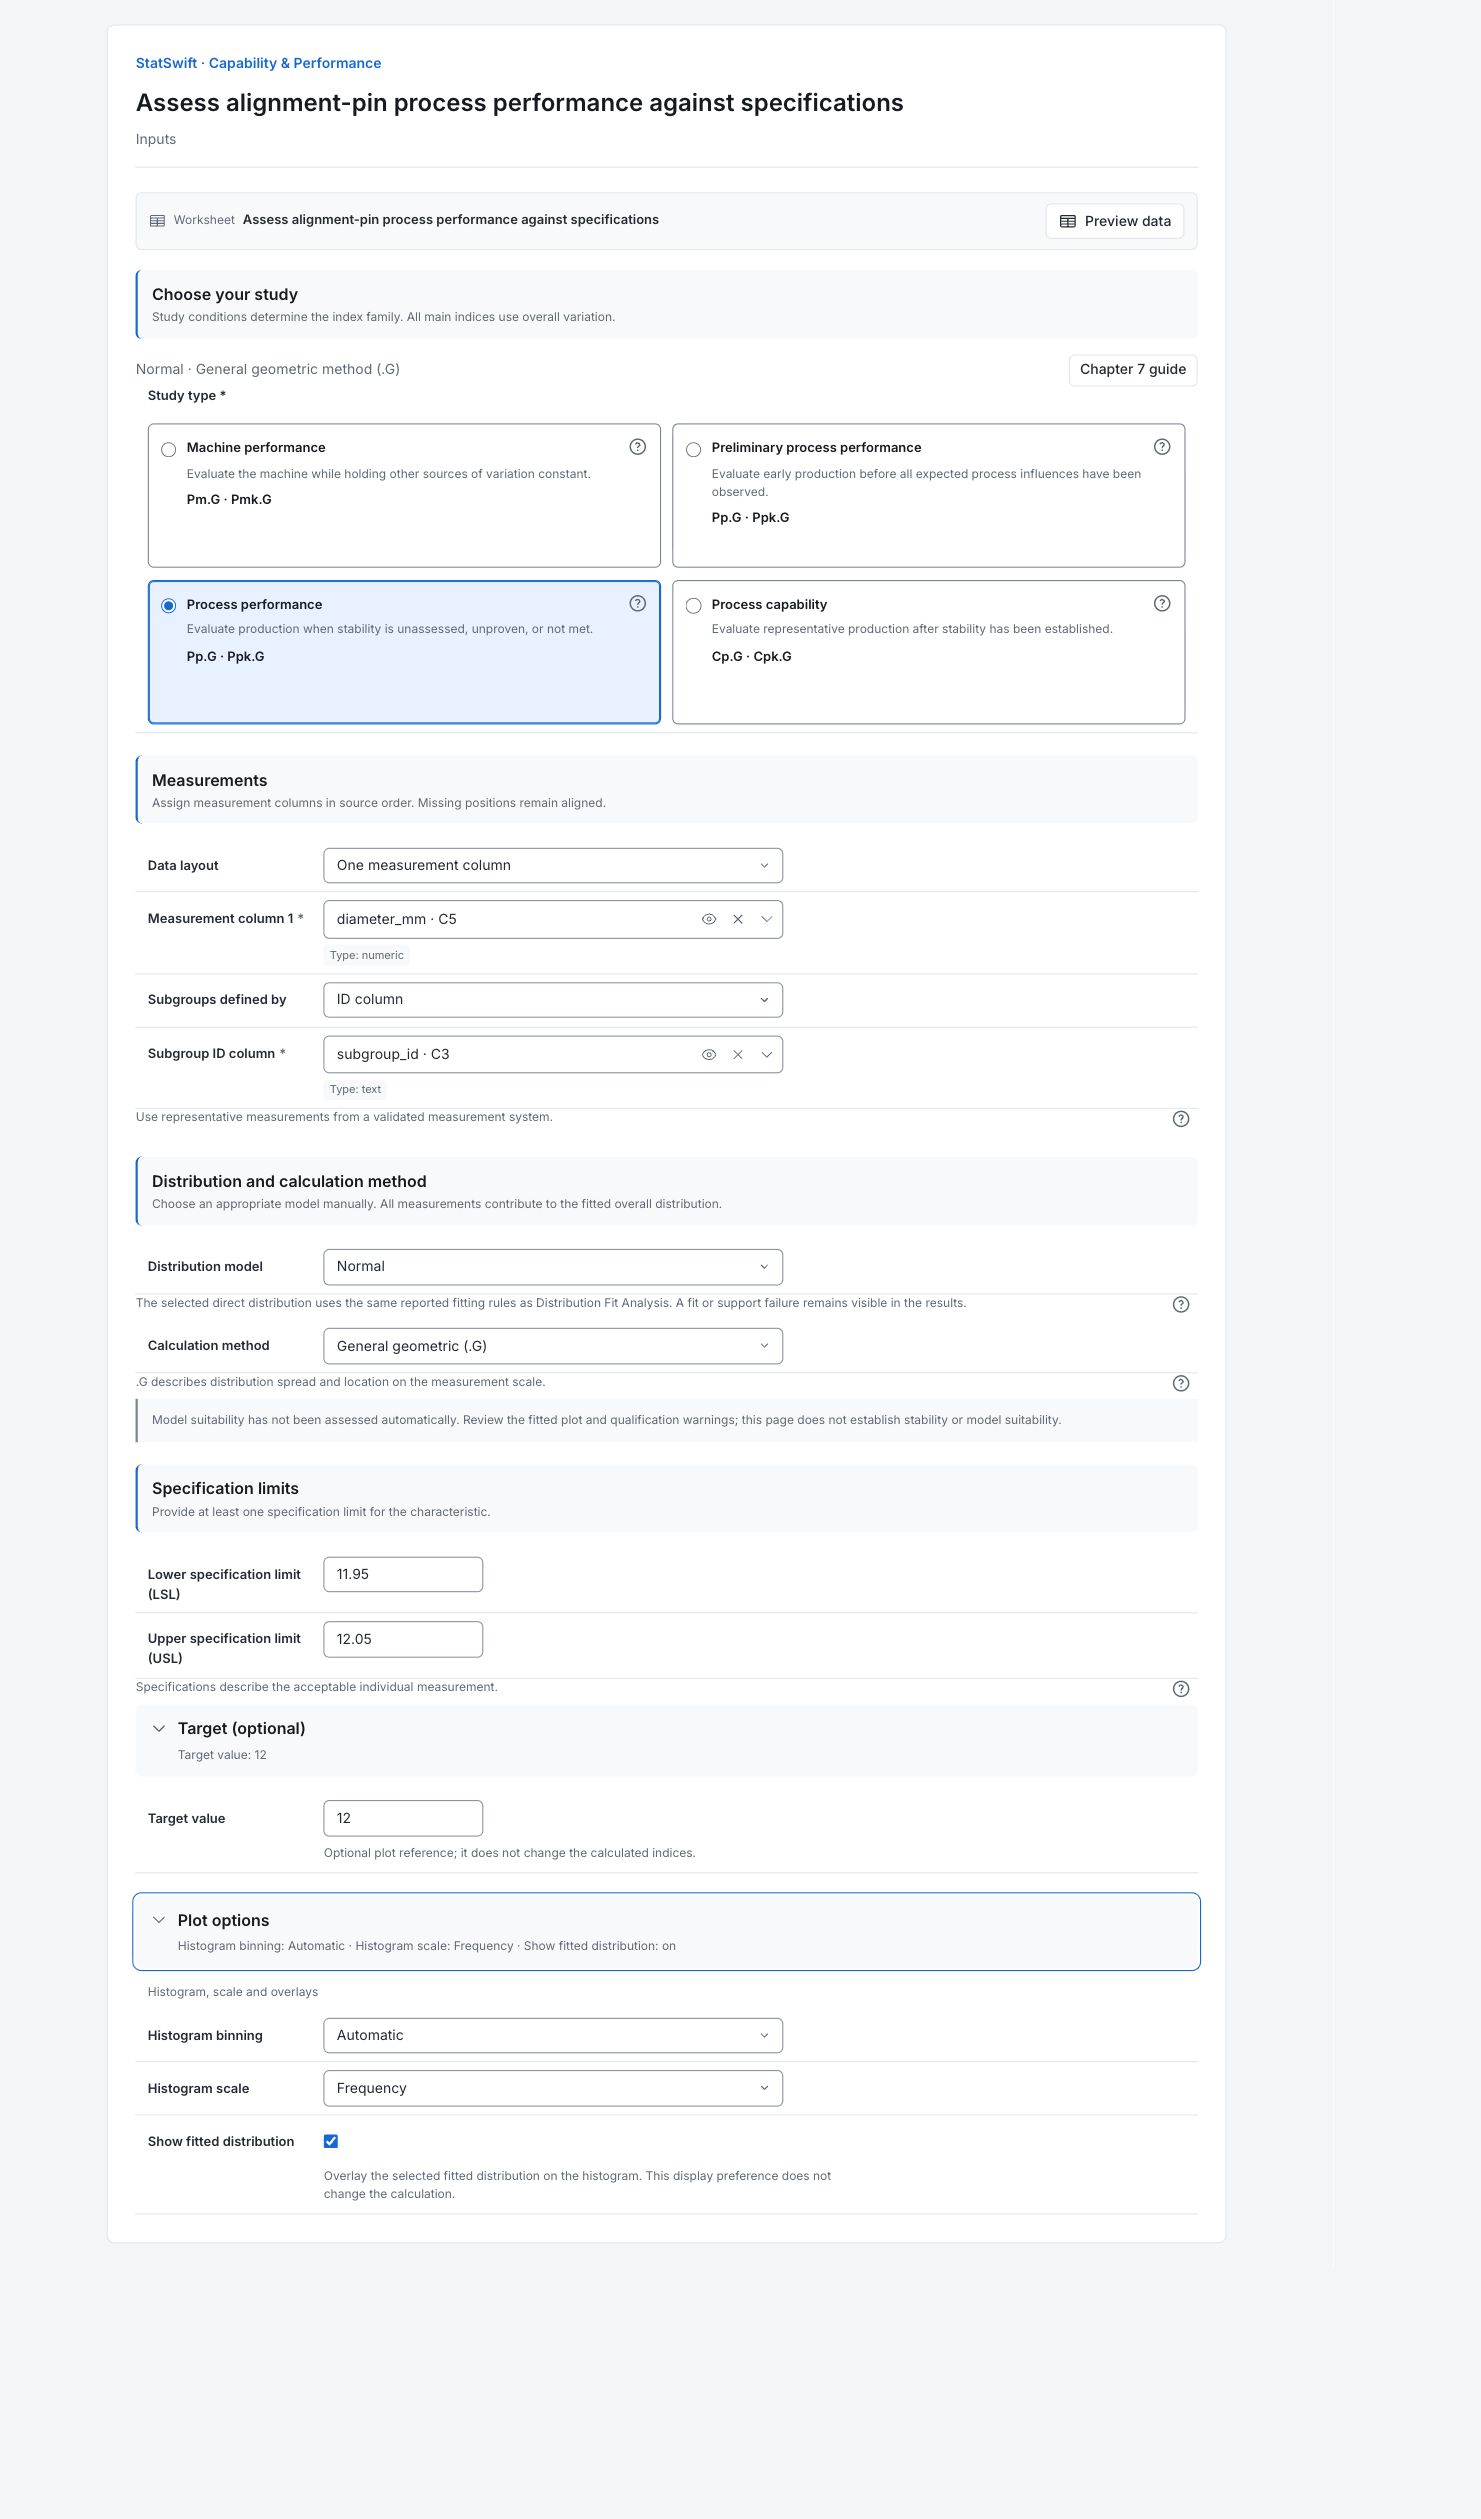
Wählen Sie unter Inputs bei Study type die Option Process performance. Stellen Sie Data layout auf One measurement column und Subgroups defined by auf ID column. Weisen Sie diameter_mm dem Feld Measurement column 1 und subgroup_id dem Feld Subgroup ID column zu, indem Sie die jeweilige Spalte in der Spaltenauswahl wählen.
4. Modell und Spezifikationen festlegen
Wählen Sie unter Distribution model die Option Normal und unter Calculation method die Option General geometric (.G). Geben Sie bei Lower specification limit (LSL) den Wert 11.950 und bei Upper specification limit (USL) den Wert 12.050 ein. Öffnen Sie Target (optional) und geben Sie bei Target value den Wert 12.000 ein. Alle drei Werte verwenden mm.
Öffnen Sie Plot options. Stellen Sie Histogram binning auf Automatic und Histogram scale auf Frequency. Lassen Sie Show fitted distribution aktiviert. Das Suffix .G kennzeichnet General geometric (.G), die gewählte Methode zur Berechnung der Leistungskennwerte; es bezeichnet keinen weiteren Satz von Stiftmessungen.
5. Analyse ausführen
Wählen Sie Run analysis und öffnen Sie anschließend Results.
6. Ergebnisse interpretieren
Untersuchung verstehen
Dieser Durchlauf beschreibt die gesamte Prozessleistung im Verhältnis zu den vorgegebenen Zeichnungsspezifikationen. Die Prozessstabilität ist nicht nachgewiesen, daher belegen die Ergebnisse keine Prozessfähigkeit.
Stifte mit den Spezifikationen vergleichen
Alle 150 Stiftdurchmesser liegen innerhalb von 11.950–12.050 mm. Ihr Mittelwert beträgt 12.0124 mm: oberhalb des Sollwerts von 12.000 mm und näher an der oberen Spezifikationsgrenze. Die Kurve ist das angepasste Normalverteilungsmodell. Die Spezifikationslinien beschreiben akzeptable Stiftdurchmesser; sie sind keine Eingriffsgrenzen.

Englischsprachiges Originaldiagramm: 150 Stiftdurchmesser in mm mit Spezifikationsgrenzen, Sollwert und angepasster Normalverteilungskurve. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Angepasstes Modell prüfen
Vergleichen Sie die Punkte mit der Referenzlinie der Normalverteilung, einschließlich der Endbereiche des Diagramms. Die App hat die Eignung dieses Modells nicht automatisch beurteilt. Dieses Diagramm kann auch keine zeitliche Stabilität nachweisen; prüfen Sie gesondert eine geeignete Regelkarte.

Englischsprachiges Originaldiagramm: Wahrscheinlichkeitsnetz der Normalverteilung für die Stiftdurchmesser. Prüfen Sie die Anpassung einschließlich der Verteilungsränder. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Leistungskennwerte auswerten
Das Suffix .G bezeichnet die gewählte allgemeine geometrische Berechnungsmethode. Pp.G beschreibt die angepasste Streuung im Verhältnis zur Spezifikationsbreite. Ppk.G berücksichtigt zusätzlich die Lage des Mittelwerts zwischen den Grenzen. Hier beträgt Pp.G 1.391 und Ppk.G 1.046; die obere Spezifikationsgrenze ist die begrenzende Seite.
Beobachtete und modellierte Spezifikationsverletzungen trennen
Keiner der untersuchten Stifte verletzt die Spezifikationen. Das Normalverteilungsmodell schätzt dennoch etwa 854 nicht spezifikationskonforme Stifte je Million Stifte, überwiegend oberhalb der oberen Spezifikationsgrenze. PPM bedeutet Teile je Million. Null beobachtete Spezifikationsverletzungen bei 150 Stiften bedeuten keine langfristige Fehlerquote von null. Die Modellschätzung hängt davon ab, dass das Modell geeignet ist.
Untersuchungsschwerpunkte festlegen
Prüfen Sie, warum der Mittelwert oberhalb des Sollwerts liegt und wie viel Abstand zur oberen Spezifikationsgrenze verbleibt. Prüfen Sie die Prozessstabilität in Erfassungsreihenfolge und die Einschränkungen des Modells. Berichten Sie die null beobachteten Spezifikationsverletzungen getrennt von der Modellschätzung; Aussagen zur Validierung der Berechnung belegen weder Prozessstabilität noch Modelleignung.
Weitere Einzelheiten: die einzelnen Ergebnisabschnitte lesen
Vollständige Ergebnistabellen verwenden wie im Bereich Help sechs signifikante Stellen.
Prozessleistungskennwerte
Pp.G beträgt 1.391 und Ppk.G beträgt 1.046. Der kleinere Kennwert auf der oberen Seite zeigt, dass die Nähe zur oberen Spezifikationsgrenze die modellierte Leistung begrenzt. Diese Kennwerte verwenden die Gesamtstreuung im Datensatz. Sie belegen keine statistische Beherrschung und garantieren keine künftige Leistung.
| Kennzahl | Wert |
|---|---|
| Pp.G | 1.39063 |
| PpL.G · Untere Spezifikationsgrenze | 1.7357 |
| PpU.G · Obere Spezifikationsgrenze | 1.04557 |
| Ppk.G | 1.04557 |
- Alle Hauptkennwerte C und P beziehen sich auf die Gesamtstreuung. Ihre Namen kennzeichnen die Untersuchungsbedingungen; die Streuung innerhalb der Untergruppen wird nicht an deren Stelle verwendet.
- Allgemeine geometrische Kennwerte vergleichen die Abstände zu den Spezifikationsgrenzen mit dem Median und den Perzentilen 0.135 / 99.865 der angepassten Verteilung. Bei einem Normalverteilungsmodell verwendet die Berechnung Mittelwert ± 3 Stichprobenstandardabweichungen.
- Ein Wechsel der Kennwertmethode bei demselben angepassten Modell ändert dessen geschätzte Wahrscheinlichkeiten für Spezifikationsverletzungen nicht.
- — kennzeichnet ein nicht verfügbares Ergebnis; der Grund wird daneben angezeigt.
Beobachtete und erwartete Spezifikationsverletzungen
In dieser Stichprobe wurden keine Teile außerhalb der Spezifikationsgrenzen beobachtet. Das Normalverteilungsmodell schätzt dennoch etwa 854 Teile je Million außerhalb der Spezifikationen, fast ausschließlich oberhalb der oberen Grenze. Diese Schätzung extrapoliert die angepassten Verteilungsränder; sie ist keine beobachtete Fehleranzahl.
| Spezifikationsseite | Beobachtete Anzahl | Beobachtete ppm | Erwartete ppm |
|---|---|---|---|
| Unter LSL | 0 | 0 | 0.0959132 |
| Über USL | 0 | 0 | 854.265 |
| Gesamt | 0 | 0 | 854.361 |
- Beobachtete Werte zählen Messwerte, die strikt außerhalb der Spezifikationsgrenzen liegen. Erwartete Werte verwenden die gewählte angepasste Verteilung; null beobachtete Spezifikationsverletzungen belegen kein künftiges Risiko von null.
- Not applicable bedeutet, dass auf dieser Seite keine Spezifikationsgrenze vorgegeben wurde. Eine natürliche Grenze ist keine Spezifikationsgrenze.
Untersuchung und Modell
Dies ist eine Untersuchung der Prozessleistung mit einem Normalverteilungsmodell, der allgemeinen geometrischen Methode und der Gesamtstreuung. Eine Aussage zur Validierung der Berechnung betrifft die Implementierung; sie bestätigt weder die Stabilität noch die Eignung dieser Daten.
| Einstellung | Wert |
|---|---|
| Untersuchung | Prozessleistung |
| Gewähltes Verteilungsmodell | Normal |
| Berechnungsmethode | Allgemeine geometrische Methode (.G) |
| Durch die Hauptkennzahlen dargestellte Streuung | Gesamtstreuung im vollständigen Datensatz |
| Parameterschätzer | Ermittelte Anpassung aus Distribution Fit Analysis |
| Lage (Originaleinheiten) | 12.0124 |
| Skala (Originaleinheiten) | 0.0119849 |
| Träger des Modells | Untere Grenze: unbeschränkt; obere Grenze: unbeschränkt |
| Untere Spezifikationsgrenze | 11.95 |
| Obere Spezifikationsgrenze | 12.05 |
| Fit | Verfügbar |
| Modellquelle | Für diesen Prozessfähigkeitslauf angepasst |
| Validierung | Die Prozessfähigkeitsberechnungen wurden anhand des Validierungsdatensatzes geprüft. |
- Referenz: AIAG–VDA SPC, Gelbband vom Februar 2026, Kapitel 7 (§7.8.2).
- Die gewählte Verteilung muss die Messwerte angemessen beschreiben, insbesondere an ihren Rändern. Das Histogramm und das Verteilungsdiagramm unterstützen die visuelle Prüfung; dieser Durchlauf belegt weder Modelleignung noch statistische Stabilität.
- Es wird weder eine automatische Annahmeentscheidung noch eine Verschiebung um 1.5σ angewendet.
Stichprobenkennwerte
Prüfen Sie die Anzahl von 150 Beobachtungen, den Mittelwert und die Gesamtstandardabweichung. Die Gesamtstreuung geht in die Hauptkennwerte der Prozessleistung ein. Untergruppen-IDs machen daraus keine Untersuchung mit nachgewiesener Fähigkeit eines stabilen Prozesses.
| Kennzahl | Wert |
|---|---|
| Beobachtungen (n) | 150 |
| Mittelwert | 12.0124 |
| Standardabweichung (gesamt) | 0.0119849 |
Details zu äquivalenten Normalverteilungs-Z-Werten
Der Z-Wert jedes Verteilungsrands wandelt dessen modellierte Fehlerwahrscheinlichkeit in einen äquivalenten Abstand auf der Normalverteilung um. Z.Bench wandelt die kombinierte Fehlerwahrscheinlichkeit um; bei zwei Verteilungsrändern entspricht es nicht einfach dem Dreifachen des kleinsten Kennwerts. Es wird keine Verschiebung um 1.5σ angewendet. Dies sind aus dem Modell abgeleitete Werte, keine Diagnosen der zeitlichen Stabilität.
| Verteilungsrand | Erwartete Fehlerwahrscheinlichkeit | Äquivalenter Normalverteilungs-Z-Wert |
|---|---|---|
| Untere Spezifikationsgrenze | 9.59132e-8 | 5.20709 |
| Obere Spezifikationsgrenze | 0.000854265 | 3.13671 |
| Beide zutreffenden Verteilungsenden (Z.Bench) | 0.000854361 | 3.13668 |
- Der Z-Wert jeder Seite ergibt sich aus der inversen Überlebensfunktion der Normalverteilung für die angepasste Fehlerwahrscheinlichkeit dieses Verteilungsrands. Bei der z-Wert-Methode entspricht der Kennwert der jeweiligen Seite Z / 3.
- Z.Bench wandelt die kombinierte Fehlerwahrscheinlichkeit um. Wenn beide Verteilungsränder beitragen, entspricht es nicht dem Dreifachen des kleinsten Fähigkeitskennwerts. Es wird keine Verschiebung um 1.5σ angewendet.
Diagnostik innerhalb der Untergruppen
Lesen Sie die Standardabweichung innerhalb der Untergruppen, den Schätzer, verwendbare Gruppen, einbezogene und ausgeschlossene Beobachtungen sowie etwaige Cw/Cwk-Einträge als Diagnosen zur Prozessverbesserung. Stabilität ist erforderlich, bevor die Streuung innerhalb der Untergruppen als inhärente Streuung betrachtet werden kann. Eine Abweichung von den Hauptkennwerten belegt keine Stabilität. Die native App lässt diesen Diagnoseabschnitt in formellen Berichten aus; unter Results bleibt er verfügbar.
Nur zur Prozessverbesserung. Diese Diagnosen werden in formellen Berichten ausgelassen (§7.8.2.5).
| Kennzahl | Wert |
|---|---|
| Cw | 1.34141 |
| Cwk | 1.00856 |
| Standardabweichung (innerhalb der Untergruppen) | 0.0124248 |
| Schätzer | R̄ / d₂ |
| Verwendbare Untergruppen | 30 |
| In der Schätzung innerhalb der Untergruppen enthaltene Beobachtungen | 150 |
| Aus der Schätzung innerhalb der Untergruppen ausgeschlossene Beobachtungen | 0 |
- Um die Streuung innerhalb der Untergruppen als inhärente Streuung zu interpretieren, ist statistische Stabilität erforderlich. Ein Unterschied zwischen den Hauptkennwerten und den Kennwerten innerhalb der Untergruppen belegt für sich keine Stabilität.
- Alle Messwerte bleiben in den Gesamtberechnungen enthalten. Gruppen mit einem einzigen Messwert und unvollständige abschließende Gruppen fester Größe werden nur aus der Schätzung innerhalb der Untergruppen ausgeschlossen; die Gesamtstandardabweichung wird niemals ersatzweise verwendet.
7. Bericht erstellen
Bewahren Sie im englischsprachigen Originalbericht Capability & performance histogram, Normal probability plot, Study and model, Sample statistics, Process performance indices, Observed and expected nonconformance und Equivalent normal Z details auf. Behalten Sie die Einschränkungen des Modells bei. Geben Sie an, dass die Stabilität nicht nachgewiesen ist, und unterscheiden Sie null beobachtete Ausschussteile von der modellierten Schätzung für die Verteilungsränder.
Wählen Sie Add to report im abgeschlossenen Analyselauf. Öffnen Sie Choose individual items and advanced options zur Auswahl von Tabellen und Diagrammen und wählen Sie anschließend Add to draft. Ausgeblendete Elemente bleiben in der gespeicherten Analyse erhalten.
Geben Sie dem Bericht einen Namen und ergänzen Sie den Zweck der Untersuchung sowie Ihre Interpretation. Wählen Sie Save, prüfen Sie Preview und verwenden Sie anschließend Export → Download HTML. Das folgende Beispiel enthält den gesamten ausgewählten Inhalt, auch Ergebnisse, die über eine Bildschirmansicht hinausgehen.