

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: 各群五十袋
独立した二群から、それぞれ50個の小袋充填量の測定値を得られます。共通の標準偏差(SD)を4 g、真の平均差を1.5 gと仮定します。
計画の参照データをダウンロード(CSV、列名は英語)Help で使用している例と同じです。CSVには参照用のシナリオが記載されています。選んだ計画用の値を Inputs に手入力します。CSVをインポートしても、この計算ツールは設定されません。Helpの Open example in a practice copy を使用すると、入力値をあらかじめ設定できます。
1. ワークスペースを作成
サイドバーで Basic Statistics を開き、Power & Sample Size を選択します。分析を作成して名前を付け、New blank worksheet を選択してから Create analysis を選択します。
2. 調査を選択
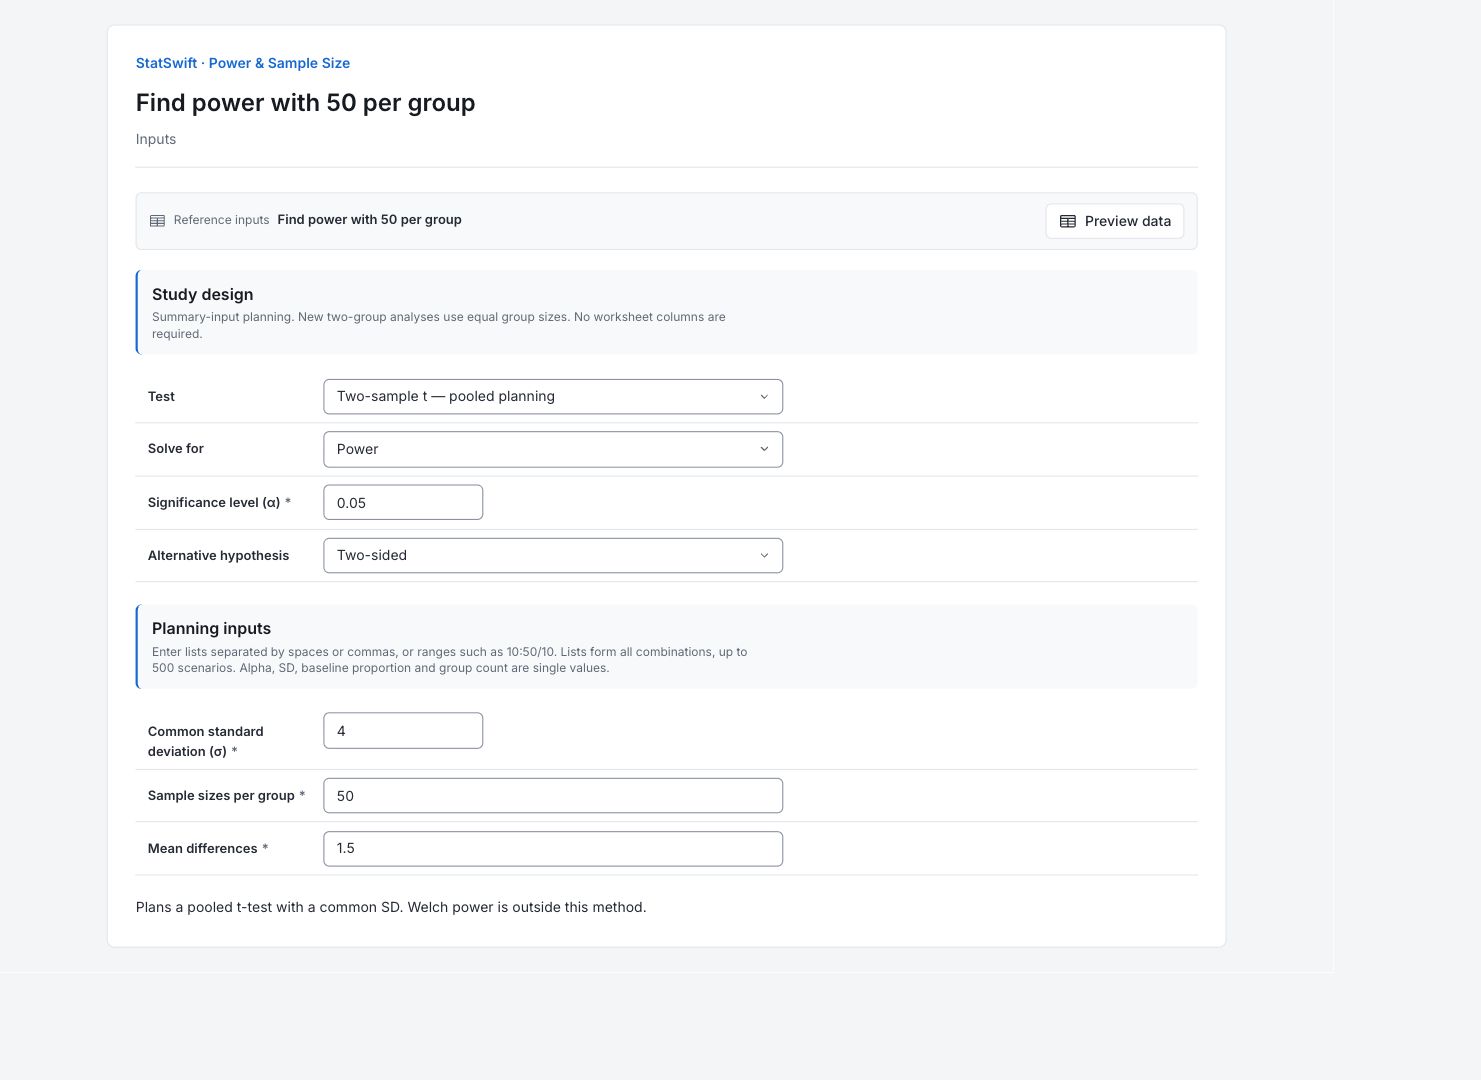
Inputs で、Test に Two-sample t — pooled planning、Solve for に Power を選択します。Significance level (α) に 0.05 を入力し、Alternative hypothesis で Two-sided を選択します。
3. 計画用の値を入力
このシナリオでは、各項目に一つの値を入力します。ワークシートの列は割り当てません。
Common standard deviation (σ) に 4 を入力します。
Sample sizes per group に 50 を入力します。
Mean differences に 1.5 を入力します。
4. 分析を実行
Run analysis を選択し、Results を開きます。
5. 結果を解釈
計画した調査を確認
独立した二群から、それぞれ50個の小袋充填量の測定値を得られます。共通の標準偏差(SD)を4 g、真の平均差を1.5 gと仮定します。
計算された計画を確認
各群50個、合計100個の場合、計算された検出力は0.458911、約45.9%です。前提のもとでは、同様の調査の約54.1%で、この実在する差を検出できないことになります。
検出力曲線を確認
曲線はサンプルサイズを各群50個に固定しています。±1.5 gでは約45.9%に達し、より大きな差は検出しやすくなります。

英語のグラフ:効果に対する検出力。 グラフを原寸で表示 (新しいタブで開きます) 前提を理解する
検出力とは、入力した前提のもとで指定した差が実際に存在するときに、計画した検定がその差を検出する確率です。仮説が正しい確率ではなく、有意な結果を保証するものでもありません。このプールしたt検定の計画は、群が独立して正規分布に従い、サンプルサイズが等しく、共通の標準偏差(SD)が4 gであることを仮定します。この検出力で計画した調査で有意でない結果が出ても、平均が等しいとは結論づけられません。
標本の収集方法を決める
各群50個の場合、計画上の前提のもとでは、実在する1.5 gの差を同様の調査の約45.9%で検出し、約54.1%で見逃します。より高い検出力を目標にする場合は、Solve for で Sample size を選択し、目標検出力を入力して再実行します。サンプルサイズが固定されている場合は、この検出感度の限界を報告します。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
検出力とサンプルサイズのシナリオ
「シナリオ」は行と入力値を対応させます。「分岐」は求めた効果の方向を記録し、ダッシュは該当しないことを示します。二群の計画では「サンプルサイズ」は各群の数で、「総観測数」は両群の合計です。「平均差」または「比較対象の比率」は、計画で想定する効果です。「目標検出力」は要求値で、「計算された検出力」は計算結果です。「一つ小さいサンプルサイズでの検出力」は、各群の観測数を一つ減らした場合を確認します。DFは、該当する場合のt検定の自由度です。「計算状況」と「詳細」は、シナリオを計算できたかどうかを記録します。各群50個、合計100個の場合、計算された検出力は0.458911、約45.9%です。前提のもとでは、同様の調査の約54.1%で、この実在する差を検出できないことになります。
| シナリオ | 分岐 | 各群のサンプルサイズ | 総観測数 | 平均差 | 目標検出力 | 計算された検出力 | 一つ小さいサンプルサイズでの検出力 | 自由度(DF) | 計算状況 | 詳細 |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 50 | 100 | 1.5 | — | 0.458911 | — | 98 | ok | — |
- 求められない分岐も、計算状況と入力値を残します。ペアはそれぞれ二つの観測値として数えます。直前のサンプルサイズでの検出力は、そのサイズが有効な場合にのみ表示します。
計画の計算方法
「方法」と「計算方式の識別子」は、使用した計算を特定します。αの0.05は検定の有意水準で、「対立仮説」の両側は両方向を含みます。「求める量」は計算対象を示します。「仮定」と「計画用標準偏差(SD)」または「基準比率」は、結果が依存する前提を記録します。このプールしたt検定の計画は、群が独立して正規分布に従い、サンプルサイズが等しく、共通の標準偏差(SD)が4 gであることを仮定します。この検出力で計画した調査で有意でない結果が出ても、平均が等しいとは結論づけられません。
| 設定 | 値 |
|---|---|
| 方法 | 二標本t検定 |
| 計算方式の識別子 | pooled-noncentral-t-v1 |
| α | 0.05 |
| 対立仮説 | two-sided |
| 求める量 | 検出力 |
| 仮定 | 独立な正規分布の群。共通の標準偏差、等しいサンプルサイズ、プールした検定に基づく計画。 |
| 計画用標準偏差(SD) | 4 |
- 結果と曲線上の点は、この実行時に記録されています。サンプルサイズは整数であり、目標検出力と計算された検出力は区別します。
シナリオの入力値
「シナリオ」は結果の行番号に対応します。「入力値」は適用したシナリオの値を記録します。これらは計画上の仮定であり、観測された測定値ではありません。この例では、各項目に一つの値を入力して、一つのシナリオを作成しています。
| シナリオ | 入力値 |
|---|---|
| 1 | {"n":50,"delta":1.5} |
記録された検出力曲線の値
各行は、サンプルサイズ、平均差または比較対象の比率、その計算上の検出力を示します。グラフの元となる記録値をすべて含みます。二群の計画では、サンプルサイズは各群の数です。検出力はゼロから一の範囲で読み、0.9は90%を意味します。曲線はサンプルサイズを各群50個に固定しています。±1.5 gでは約45.9%に達し、より大きな差は検出しやすくなります。
| 各群のサンプルサイズ | 平均差 | 検出力 |
|---|---|---|
| 50 | -2.5 | 0.871659 |
| 50 | -2.41667 | 0.848762 |
| 50 | -2.33333 | 0.823299 |
| 50 | -2.25 | 0.79528 |
| 50 | -2.16667 | 0.764775 |
| 50 | -2.08333 | 0.731915 |
| 50 | -2 | 0.696893 |
| 50 | -1.91667 | 0.659962 |
| 50 | -1.83333 | 0.621428 |
| 50 | -1.75 | 0.581649 |
| 50 | -1.66667 | 0.541019 |
| 50 | -1.58333 | 0.499961 |
| 50 | -1.5 | 0.458911 |
| 50 | -1.41667 | 0.418307 |
| 50 | -1.33333 | 0.378575 |
| 50 | -1.25 | 0.340115 |
| 50 | -1.16667 | 0.303291 |
| 50 | -1.08333 | 0.268423 |
| 50 | -1 | 0.23578 |
| 50 | -0.916667 | 0.205575 |
| 50 | -0.833333 | 0.177967 |
| 50 | -0.75 | 0.15306 |
| 50 | -0.666667 | 0.13091 |
| 50 | -0.583333 | 0.111532 |
| 50 | -0.5 | 0.0949054 |
| 50 | -0.416667 | 0.0809875 |
| 50 | -0.333333 | 0.0697201 |
| 50 | -0.25 | 0.0610404 |
| 50 | -0.166667 | 0.0548895 |
| 50 | -0.0833333 | 0.0512197 |
| 50 | 0 | 0.05 |
| 50 | 0.0833333 | 0.0512197 |
| 50 | 0.166667 | 0.0548895 |
| 50 | 0.25 | 0.0610404 |
| 50 | 0.333333 | 0.0697201 |
| 50 | 0.416667 | 0.0809875 |
| 50 | 0.5 | 0.0949054 |
| 50 | 0.583333 | 0.111532 |
| 50 | 0.666667 | 0.13091 |
| 50 | 0.75 | 0.15306 |
| 50 | 0.833333 | 0.177967 |
| 50 | 0.916667 | 0.205575 |
| 50 | 1 | 0.23578 |
| 50 | 1.08333 | 0.268423 |
| 50 | 1.16667 | 0.303291 |
| 50 | 1.25 | 0.340115 |
| 50 | 1.33333 | 0.378575 |
| 50 | 1.41667 | 0.418307 |
| 50 | 1.5 | 0.458911 |
| 50 | 1.58333 | 0.499961 |
| 50 | 1.66667 | 0.541019 |
| 50 | 1.75 | 0.581649 |
| 50 | 1.83333 | 0.621428 |
| 50 | 1.91667 | 0.659962 |
| 50 | 2 | 0.696893 |
| 50 | 2.08333 | 0.731915 |
| 50 | 2.16667 | 0.764775 |
| 50 | 2.25 | 0.79528 |
| 50 | 2.33333 | 0.823299 |
| 50 | 2.41667 | 0.848762 |
| 50 | 2.5 | 0.871659 |
- 記録されたすべての曲線は、この表とそのCSVエクスポートに含まれます。グラフには、選択した最大12種類のサンプルサイズを表示します。
6. レポートを作成
Power and sample size scenarios、Planning method、Scenario input values、Power versus effect グラフと、その記録値の表全体を残します。検出する価値のある差、計画用のばらつきまたは比率、標本の割り付け、計算方法を記録します。このプールしたt検定の計画は、群が独立して正規分布に従い、サンプルサイズが等しく、共通の標準偏差(SD)が4 gであることを仮定します。この検出力で計画した調査で有意でない結果が出ても、平均が等しいとは結論づけられません。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。