

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : cinquante sachets par groupe
Deux groupes indépendants peuvent chacun fournir 50 mesures de remplissage de sachets. Supposez un écart-type commun de 4 g et une vraie différence de moyenne de 1.5 g.
Télécharger les données de référence de planification (CSV en anglais)C’est le même exemple que dans Help. Le CSV liste des scénarios de référence. Saisissez les valeurs de planification choisies manuellement dans Inputs ; l’importation ne configure pas ce calculateur. Utilisez Open example in a practice copy dans Help pour préremplir les données d’entrée.
1. Créer l’espace de travail
Dans la barre latérale, ouvrez Basic Statistics et choisissez Power & Sample Size. Créez une analyse, nommez-la, sélectionnez New blank worksheet, puis choisissez Create analysis.
2. Choisir l’étude
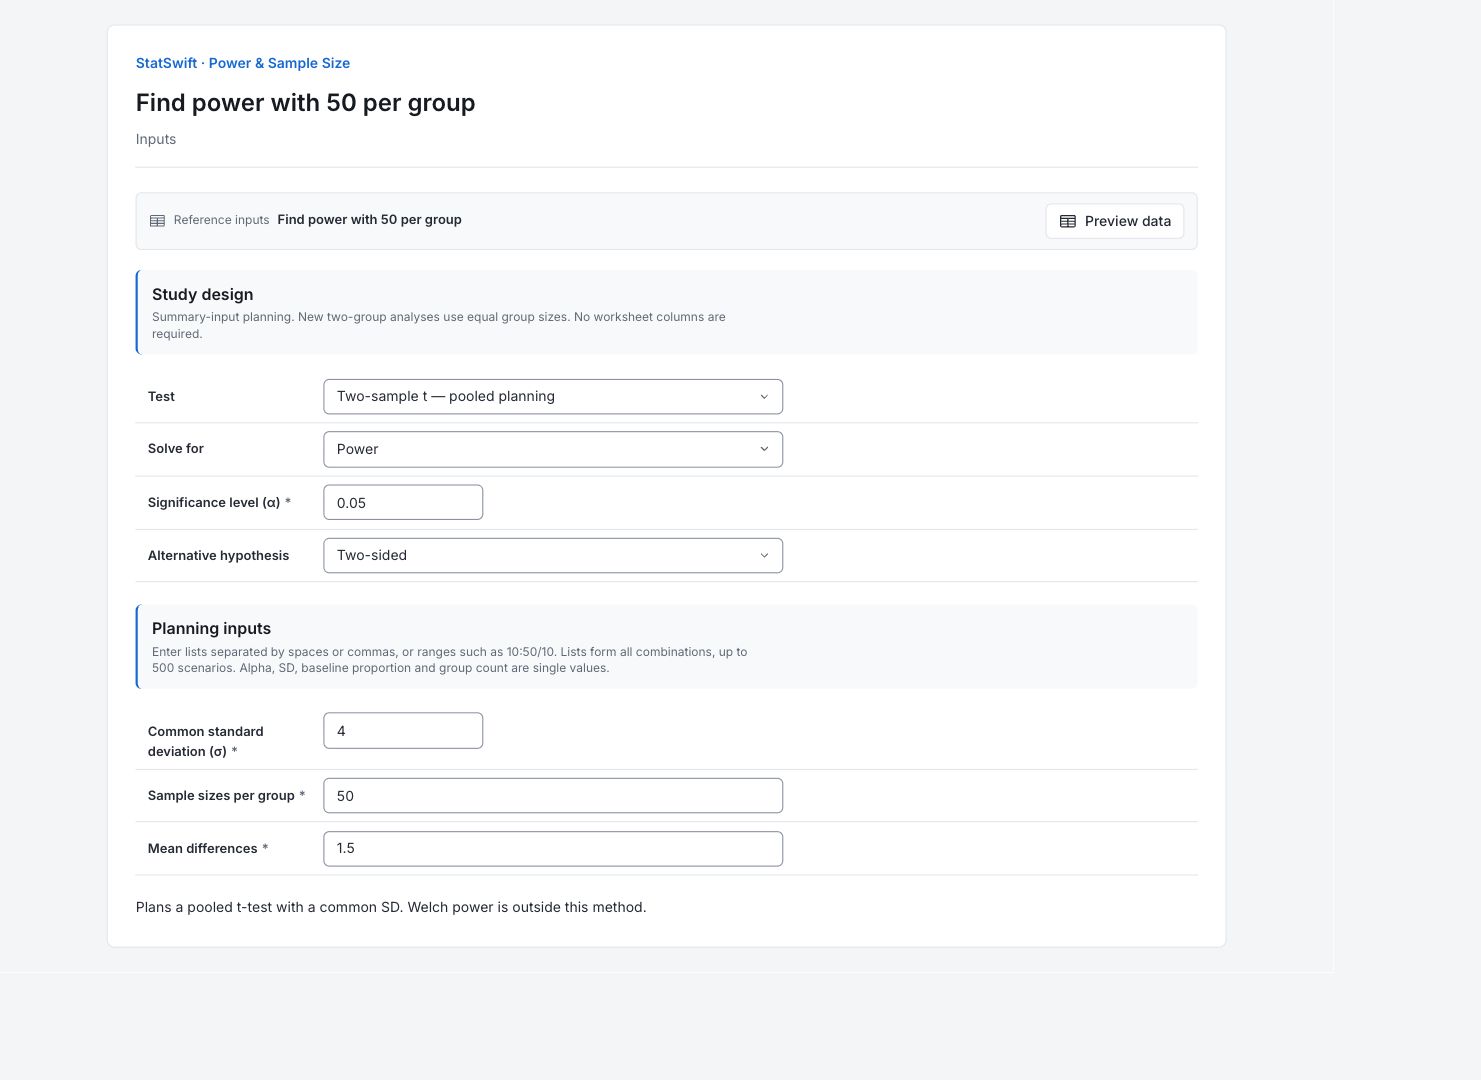
Dans Inputs, choisissez Two-sample t — pooled planning pour Test et Power pour Solve for. Saisissez 0.05 dans Significance level (α) et choisissez Two-sided pour Alternative hypothesis.
3. Saisir les valeurs de planification
Saisissez une valeur par champ pour ce scénario. Aucune colonne de feuille n’est affectée.
Saisissez 4 dans Common standard deviation (σ).
Saisissez 50 dans Sample sizes per group.
Saisissez 1.5 dans Mean differences.
4. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
5. Interpréter les résultats
Vérifier l’étude prévue
Deux groupes indépendants peuvent chacun fournir 50 mesures de remplissage de sachets. Supposez un écart-type commun de 4 g et une vraie différence de moyenne de 1.5 g.
Lire le plan calculé
La puissance atteinte est de 0.458911, soit environ 45.9%, pour 50 par groupe (100 au total). Sous les hypothèses, le test manquerait cette différence réelle dans environ 54.1% des études comparables.
Suivre la courbe de puissance
La courbe maintient la taille à 50 par groupe. À ±1.5 g, elle atteint environ 45.9% ; les différences plus grandes sont plus faciles à détecter.

Puissance en fonction de l’effet Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Comprendre les hypothèses
La puissance est la probabilité que le test prévu détecte la différence spécifiée lorsque cette différence existe, sous les hypothèses saisies. Ce n’est pas la probabilité qu’une hypothèse soit vraie et elle ne garantit pas un résultat significatif. Ce plan de test t à variance regroupée suppose des groupes normaux indépendants, des tailles égales et un écart-type commun de 4 g. Une étude non significative avec cette puissance n’établirait pas l’égalité des moyennes.
Décider comment recueillir l’échantillon
Avec 50 par groupe, une différence réelle de 1.5 g serait détectée dans environ 45.9% des études comparables et manquée dans environ 54.1%, sous les hypothèses de planification. Pour une cible plus élevée, choisissez Sample size dans Solve for, saisissez la puissance cible et relancez. Si l’échantillon est fixé, indiquez cette sensibilité limitée.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Scénarios de puissance et de taille d’échantillon
Le scénario relie cette ligne à ses valeurs d’entrée. La branche indique le sens d’un effet résolu ; un tiret signifie que cela ne s’applique pas. La taille d’échantillon est par groupe pour les plans à deux groupes ; le nombre total d’observations compte les deux groupes. La différence de moyenne ou la proportion de comparaison est l’effet planifié. La puissance cible est la demande ; la puissance atteinte est le résultat calculé. La puissance à la taille précédente vérifie une observation de moins par groupe. DF désigne les degrés de liberté du test t, le cas échéant. Le statut et les détails indiquent si le scénario a été calculé. La puissance atteinte est de 0.458911, soit environ 45.9%, pour 50 par groupe (100 au total). Sous les hypothèses, le test manquerait cette différence réelle dans environ 54.1% des études comparables.
| Scénario | Branche | Taille de l’échantillon par groupe | Nombre total d’observations | Différence de moyenne | Puissance cible | Puissance atteinte | Puissance à la taille précédente | DF | Statut | Détails |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 50 | 100 | 1.5 | — | 0.458911 | — | 98 | ok | — |
- Les branches indisponibles conservent leur statut et leurs valeurs d’entrée. Chaque paire compte deux observations. La puissance à la taille précédente n’est rapportée que si cette taille est valide.
Méthode de planification
La méthode et le calibrage identifient le calcul utilisé. Alpha 0.05 est le seuil de significativité du test ; l’hypothèse alternative bilatérale inclut les deux sens. La grandeur recherchée désigne la quantité calculée. Les hypothèses et l’écart-type de planification ou la proportion de référence enregistrent ce dont dépend le résultat. Ce plan de test t à variance regroupée suppose des groupes normaux indépendants, des tailles égales et un écart-type commun de 4 g. Une étude non significative avec cette puissance n’établirait pas l’égalité des moyennes.
| Réglage | Valeur |
|---|---|
| Méthode | t à deux échantillons |
| Calibrage | pooled-noncentral-t-v1 |
| α | 0.05 |
| Hypothèse alternative | two-sided |
| Grandeur recherchée | Puissance |
| Hypothèses | Groupes normaux indépendants ; écart-type commun ; tailles égales ; planification avec test à variance regroupée. |
| Écart-type de planification | 4 |
- Les résultats et les points des courbes sont enregistrés avec cette exécution. Les tailles d’échantillon sont entières ; la puissance cible et la puissance atteinte sont distinctes.
Valeurs d’entrée des scénarios
Le scénario correspond à la ligne de résultat numérotée. Les données d’entrée enregistrent les valeurs actives du scénario ; ce sont des hypothèses de planification, et non des mesures observées. Les saisies à valeur unique produisent ici un scénario.
| Scénario | Données d’entrée |
|---|---|
| 1 | {"n":50,"delta":1.5} |
Valeurs enregistrées des courbes de puissance
Chaque ligne donne une taille d’échantillon, une différence de moyenne ou une proportion de comparaison, et sa puissance calculée. Ce sont toutes les valeurs enregistrées derrière le graphique de l’application. Pour les plans à deux groupes, la taille est par groupe. Lisez la puissance entre zéro et un ; 0.9 signifie 90%. La courbe maintient la taille à 50 par groupe. À ±1.5 g, elle atteint environ 45.9% ; les différences plus grandes sont plus faciles à détecter.
| Taille de l’échantillon par groupe | Différence de moyenne | Puissance |
|---|---|---|
| 50 | -2.5 | 0.871659 |
| 50 | -2.41667 | 0.848762 |
| 50 | -2.33333 | 0.823299 |
| 50 | -2.25 | 0.79528 |
| 50 | -2.16667 | 0.764775 |
| 50 | -2.08333 | 0.731915 |
| 50 | -2 | 0.696893 |
| 50 | -1.91667 | 0.659962 |
| 50 | -1.83333 | 0.621428 |
| 50 | -1.75 | 0.581649 |
| 50 | -1.66667 | 0.541019 |
| 50 | -1.58333 | 0.499961 |
| 50 | -1.5 | 0.458911 |
| 50 | -1.41667 | 0.418307 |
| 50 | -1.33333 | 0.378575 |
| 50 | -1.25 | 0.340115 |
| 50 | -1.16667 | 0.303291 |
| 50 | -1.08333 | 0.268423 |
| 50 | -1 | 0.23578 |
| 50 | -0.916667 | 0.205575 |
| 50 | -0.833333 | 0.177967 |
| 50 | -0.75 | 0.15306 |
| 50 | -0.666667 | 0.13091 |
| 50 | -0.583333 | 0.111532 |
| 50 | -0.5 | 0.0949054 |
| 50 | -0.416667 | 0.0809875 |
| 50 | -0.333333 | 0.0697201 |
| 50 | -0.25 | 0.0610404 |
| 50 | -0.166667 | 0.0548895 |
| 50 | -0.0833333 | 0.0512197 |
| 50 | 0 | 0.05 |
| 50 | 0.0833333 | 0.0512197 |
| 50 | 0.166667 | 0.0548895 |
| 50 | 0.25 | 0.0610404 |
| 50 | 0.333333 | 0.0697201 |
| 50 | 0.416667 | 0.0809875 |
| 50 | 0.5 | 0.0949054 |
| 50 | 0.583333 | 0.111532 |
| 50 | 0.666667 | 0.13091 |
| 50 | 0.75 | 0.15306 |
| 50 | 0.833333 | 0.177967 |
| 50 | 0.916667 | 0.205575 |
| 50 | 1 | 0.23578 |
| 50 | 1.08333 | 0.268423 |
| 50 | 1.16667 | 0.303291 |
| 50 | 1.25 | 0.340115 |
| 50 | 1.33333 | 0.378575 |
| 50 | 1.41667 | 0.418307 |
| 50 | 1.5 | 0.458911 |
| 50 | 1.58333 | 0.499961 |
| 50 | 1.66667 | 0.541019 |
| 50 | 1.75 | 0.581649 |
| 50 | 1.83333 | 0.621428 |
| 50 | 1.91667 | 0.659962 |
| 50 | 2 | 0.696893 |
| 50 | 2.08333 | 0.731915 |
| 50 | 2.16667 | 0.764775 |
| 50 | 2.25 | 0.79528 |
| 50 | 2.33333 | 0.823299 |
| 50 | 2.41667 | 0.848762 |
| 50 | 2.5 | 0.871659 |
- Toutes les courbes enregistrées figurent dans ce tableau et son export CSV ; le graphique affiche au plus 12 tailles d’échantillon sélectionnées.
6. Créer un rapport
Conservez Power and sample size scenarios, Planning method, Scenario input values, le graphique Power versus effect de l’application et son tableau complet de valeurs enregistrées. Notez la différence à détecter, la dispersion ou les proportions de planification, la répartition de l’échantillon et la méthode. Ce plan de test t à variance regroupée suppose des groupes normaux indépendants, des tailles égales et un écart-type commun de 4 g. Une étude non significative avec cette puissance n’établirait pas l’égalité des moyennes.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.