

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: pięćdziesiąt saszetek na grupę
Dwie niezależne grupy mogą dostarczyć po 50 pomiarów napełnienia saszetek. Załóż wspólne SD 4 g i rzeczywistą różnicę średnich 1.5 g.
Pobierz zestawienie planistyczne (CSV, język angielski)To ten sam przykład, który znajduje się w Help. CSV zawiera scenariusze referencyjne. Wprowadź wybrane wartości planistyczne ręcznie na karcie Inputs; import nie konfiguruje tego kalkulatora. Użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Power & Sample Size. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Wybierz badanie
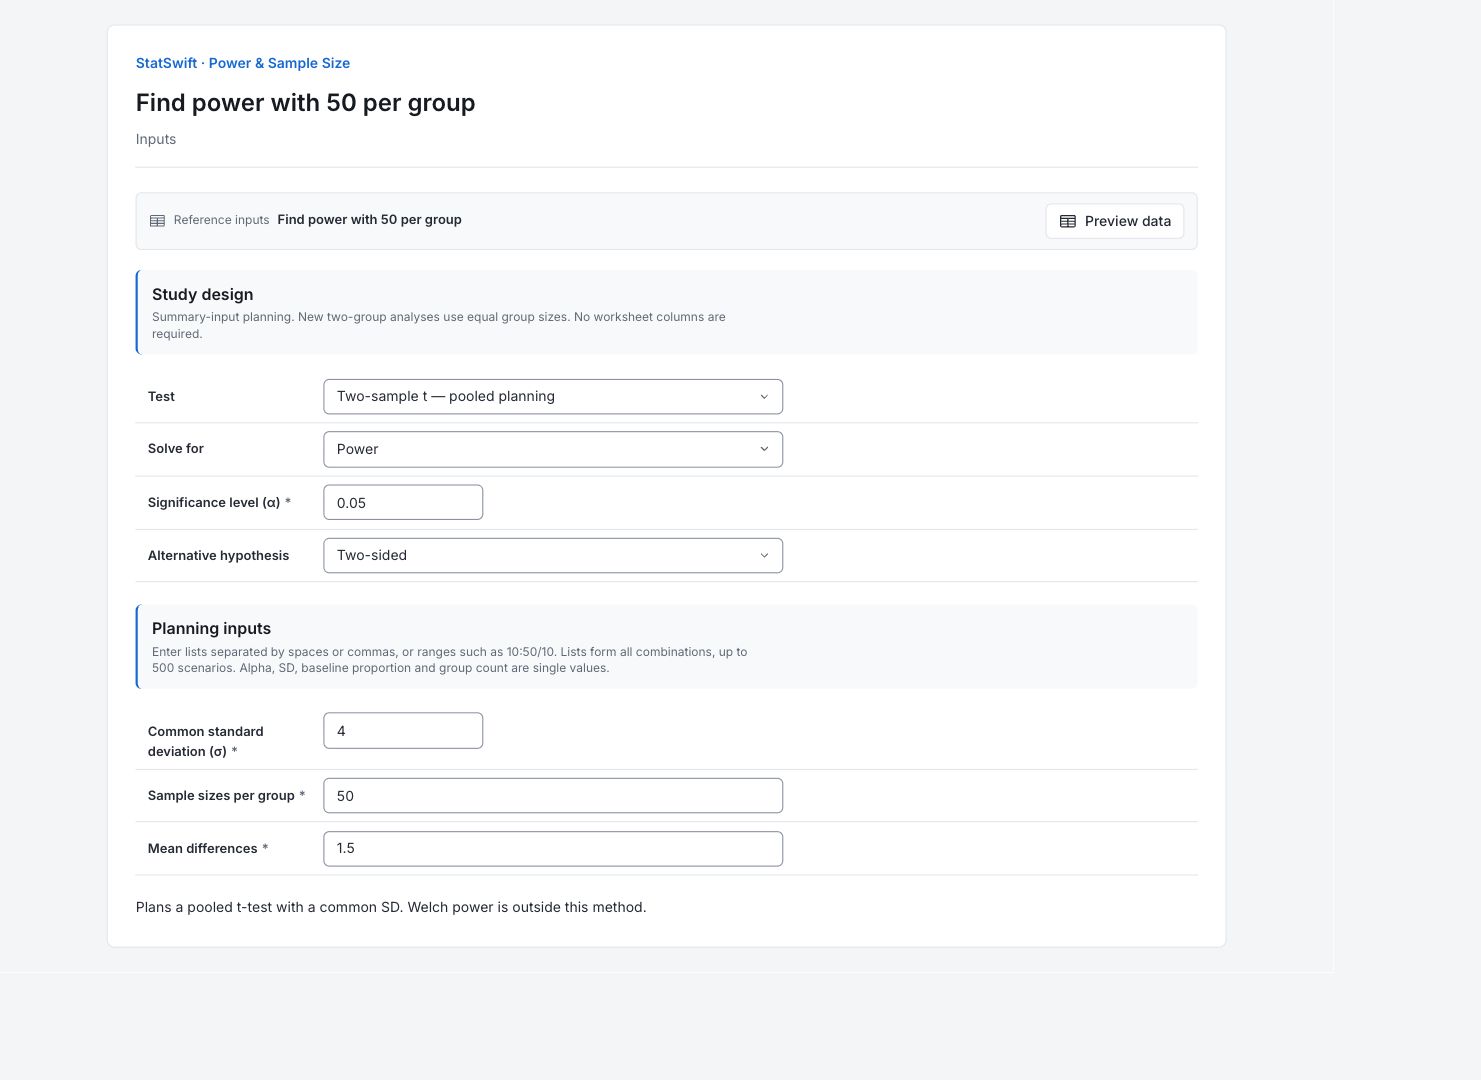
Na karcie Inputs wybierz Two-sample t — pooled planning w Test i Power w Solve for. Wpisz 0.05 w Significance level (α) i wybierz Two-sided w Alternative hypothesis.
3. Wprowadź wartości planistyczne
Wprowadź po jednej wartości w każdym polu dla tego scenariusza. Nie przypisuje się kolumn arkusza.
Wpisz 4 w Common standard deviation (σ).
Wpisz 50 w Sample sizes per group.
Wpisz 1.5 w Mean differences.
4. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
5. Zinterpretuj wyniki
Sprawdź planowane badanie
Dwie niezależne grupy mogą dostarczyć po 50 pomiarów napełnienia saszetek. Załóż wspólne SD 4 g i rzeczywistą różnicę średnich 1.5 g.
Odczytaj obliczony plan
Moc osiągnięta wynosi 0.458911, czyli około 45.9%, dla 50 na grupę (łącznie 100). Przy tych założeniach test przeoczyłby tę rzeczywistą różnicę w około 54.1% porównywalnych badań.
Prześledź krzywą mocy
Krzywa utrzymuje liczebność 50 na grupę. Przy ±1.5 g osiąga około 45.9%; większe różnice są łatwiejsze do wykrycia.

Moc względem efektu Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Zrozum założenia
Moc to prawdopodobieństwo wykrycia określonej różnicy przez planowany test, gdy ta różnica rzeczywiście istnieje, przy wprowadzonych założeniach. Nie jest prawdopodobieństwem prawdziwości hipotezy i nie gwarantuje istotnego wyniku. Ten plan testu t z wariancją łączoną zakłada niezależne normalne grupy, równe liczebności i wspólne SD 4 g. Nieistotny wynik badania o tej mocy nie dowodziłby równych średnich.
Zdecyduj, jak zebrać próbę
Przy 50 na grupę rzeczywista różnica 1.5 g zostałaby wykryta w około 45.9% porównywalnych badań i przeoczona w około 54.1%, przy założeniach planistycznych. Dla wyższego celu wybierz Sample size w Solve for, wpisz docelową moc i uruchom ponownie. Jeśli próba jest stała, podaj tę ograniczoną czułość.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
Scenariusze mocy i liczebności próby
Scenariusz łączy wiersz z danymi wejściowymi. Gałąź określa kierunek rozwiązanego efektu; kreska oznacza, że nie dotyczy. Liczebność próby jest podawana na grupę w planach dwugrupowych; całkowita liczba obserwacji zlicza obie grupy. Różnica średnich lub proporcja porównawcza to planowany efekt. Moc docelowa jest żądaniem; moc osiągnięta jest obliczonym wynikiem. Moc przy poprzedniej liczebności sprawdza o jedną obserwację mniej na grupę. DF to stopnie swobody testu t, jeśli dotyczą. Status i szczegóły informują, czy scenariusz został obliczony. Moc osiągnięta wynosi 0.458911, czyli około 45.9%, dla 50 na grupę (łącznie 100). Przy tych założeniach test przeoczyłby tę rzeczywistą różnicę w około 54.1% porównywalnych badań.
| Scenariusz | Gałąź | Liczebność próby na grupę | Całkowita liczba obserwacji | Różnica średnich | Moc docelowa | Moc osiągnięta | Moc przy poprzedniej liczebności | DF | Status | Szczegóły |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | — | 50 | 100 | 1.5 | — | 0.458911 | — | 98 | ok | — |
- Niedostępne gałęzie zachowują status i dane wejściowe. Każda para liczy dwie obserwacje. Moc przy poprzedniej liczebności jest podawana tylko wtedy, gdy ta liczebność jest poprawna.
Metoda planowania
Metoda i kalibracja określają użyte obliczenie. Alfa 0.05 to poziom istotności testu; dwustronna alternatywa obejmuje oba kierunki. Pole obliczanej wielkości określa szukaną wartość. Założenia oraz planowane SD lub proporcja bazowa opisują, od czego zależy wynik. Ten plan testu t z wariancją łączoną zakłada niezależne normalne grupy, równe liczebności i wspólne SD 4 g. Nieistotny wynik badania o tej mocy nie dowodziłby równych średnich.
| Ustawienie | Wartość |
|---|---|
| Metoda | Test t dla dwóch prób |
| Kalibracja | pooled-noncentral-t-v1 |
| Alfa | 0.05 |
| Hipoteza alternatywna | two-sided |
| Wyznaczana wielkość | Moc |
| Założenia | Niezależne grupy normalne; wspólne odchylenie standardowe; równe liczebności; planowanie testu z wariancją łączoną. |
| Planowane odchylenie standardowe | 4 |
- Wyniki i punkty krzywej zapisano z tym uruchomieniem. Liczebności próby są całkowite; moc docelowa i osiągnięta są odrębne.
Dane wejściowe scenariusza
Scenariusz odpowiada numerowanemu wierszowi wyników. Dane wejściowe zawierają aktywne wartości scenariusza; są to założenia planistyczne, a nie obserwowane pomiary. Pojedyncze wartości wejściowe tworzą tutaj jeden scenariusz.
| Scenariusz | Dane wejściowe |
|---|---|
| 1 | {"n":50,"delta":1.5} |
Zapisane wartości krzywej mocy
Każdy wiersz podaje liczebność próby, różnicę średnich lub proporcję porównawczą oraz obliczoną moc. Są to wszystkie zapisane wartości natywnego wykresu. W planach dwugrupowych liczebność dotyczy jednej grupy. Moc odczytuje się między zerem a jednością; 0.9 oznacza 90%. Krzywa utrzymuje liczebność 50 na grupę. Przy ±1.5 g osiąga około 45.9%; większe różnice są łatwiejsze do wykrycia.
| Liczebność próby na grupę | Różnica średnich | Moc |
|---|---|---|
| 50 | -2.5 | 0.871659 |
| 50 | -2.41667 | 0.848762 |
| 50 | -2.33333 | 0.823299 |
| 50 | -2.25 | 0.79528 |
| 50 | -2.16667 | 0.764775 |
| 50 | -2.08333 | 0.731915 |
| 50 | -2 | 0.696893 |
| 50 | -1.91667 | 0.659962 |
| 50 | -1.83333 | 0.621428 |
| 50 | -1.75 | 0.581649 |
| 50 | -1.66667 | 0.541019 |
| 50 | -1.58333 | 0.499961 |
| 50 | -1.5 | 0.458911 |
| 50 | -1.41667 | 0.418307 |
| 50 | -1.33333 | 0.378575 |
| 50 | -1.25 | 0.340115 |
| 50 | -1.16667 | 0.303291 |
| 50 | -1.08333 | 0.268423 |
| 50 | -1 | 0.23578 |
| 50 | -0.916667 | 0.205575 |
| 50 | -0.833333 | 0.177967 |
| 50 | -0.75 | 0.15306 |
| 50 | -0.666667 | 0.13091 |
| 50 | -0.583333 | 0.111532 |
| 50 | -0.5 | 0.0949054 |
| 50 | -0.416667 | 0.0809875 |
| 50 | -0.333333 | 0.0697201 |
| 50 | -0.25 | 0.0610404 |
| 50 | -0.166667 | 0.0548895 |
| 50 | -0.0833333 | 0.0512197 |
| 50 | 0 | 0.05 |
| 50 | 0.0833333 | 0.0512197 |
| 50 | 0.166667 | 0.0548895 |
| 50 | 0.25 | 0.0610404 |
| 50 | 0.333333 | 0.0697201 |
| 50 | 0.416667 | 0.0809875 |
| 50 | 0.5 | 0.0949054 |
| 50 | 0.583333 | 0.111532 |
| 50 | 0.666667 | 0.13091 |
| 50 | 0.75 | 0.15306 |
| 50 | 0.833333 | 0.177967 |
| 50 | 0.916667 | 0.205575 |
| 50 | 1 | 0.23578 |
| 50 | 1.08333 | 0.268423 |
| 50 | 1.16667 | 0.303291 |
| 50 | 1.25 | 0.340115 |
| 50 | 1.33333 | 0.378575 |
| 50 | 1.41667 | 0.418307 |
| 50 | 1.5 | 0.458911 |
| 50 | 1.58333 | 0.499961 |
| 50 | 1.66667 | 0.541019 |
| 50 | 1.75 | 0.581649 |
| 50 | 1.83333 | 0.621428 |
| 50 | 1.91667 | 0.659962 |
| 50 | 2 | 0.696893 |
| 50 | 2.08333 | 0.731915 |
| 50 | 2.16667 | 0.764775 |
| 50 | 2.25 | 0.79528 |
| 50 | 2.33333 | 0.823299 |
| 50 | 2.41667 | 0.848762 |
| 50 | 2.5 | 0.871659 |
- Wszystkie zapisane krzywe są zawarte w tej tabeli i jej eksporcie CSV; wykres pokazuje najwyżej 12 wybranych liczebności prób.
6. Utwórz raport
Zachowaj Power and sample size scenarios, Planning method, Scenario input values, natywny wykres Power versus effect i pełną tabelę zapisanych wartości. Zapisz różnicę wartą wykrycia, planowany rozrzut lub proporcje, przydział próby i metodę. Ten plan testu t z wariancją łączoną zakłada niezależne normalne grupy, równe liczebności i wspólne SD 4 g. Nieistotny wynik badania o tej mocy nie dowodziłby równych średnich. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.