

App-Befehle, Arbeitsblattkennungen und Werte der Beispieldaten bleiben im Original erhalten. Screenshots, Diagramme und Dateien zum Herunterladen liegen im englischen Original vor. Die Zahlen in dieser Anleitung verwenden die englische Schreibweise mit Dezimalpunkt und Tausenderkomma.
Beispiel: Siegelnahtfestigkeit von Beuteln
22 unabhängige Siegelläufe: acht Kombinationen mit zwei Faktorstufen, jeweils an zwei Tagen wiederholt, sowie drei Zentralläufe pro Tag. Ein Block entspricht einem Versuchstag; lassen Sie seine Spalte zugewiesen, damit das Modell Tagesunterschiede berücksichtigt.
Aufgezeichnete Messwerte herunterladen (CSV)Dieses aufgezeichnete Beispiel wird auch in Help verwendet. Die CSV-Datei enthält Faktoreinstellungen und gemessene Zielgrößen, die gemeinsam importiert werden. Verwenden Sie in Help Open example in a practice copy, um die Einstellungen vorauszufüllen.
1. Arbeitsbereich erstellen
Öffnen Sie in der Seitenleiste Design of Experiments und erstellen Sie eine Analyse. Benennen Sie sie, wählen Sie New blank worksheet und anschließend Create analysis.
2. Messwerte importieren
Laden Sie die Beispiel-CSV-Datei oben herunter und importieren Sie sie in das Arbeitsblatt. Wählen Sie Comma als Trennzeichen, Dot als Dezimaltrennzeichen und First row contains column names. Halten Sie in jeder Zeile die Zielgröße, Faktoreinstellungen, den Punkttyp und die Ausführungsreihenfolge zusammen.
3. Studie auswählen und Faktoren eingeben
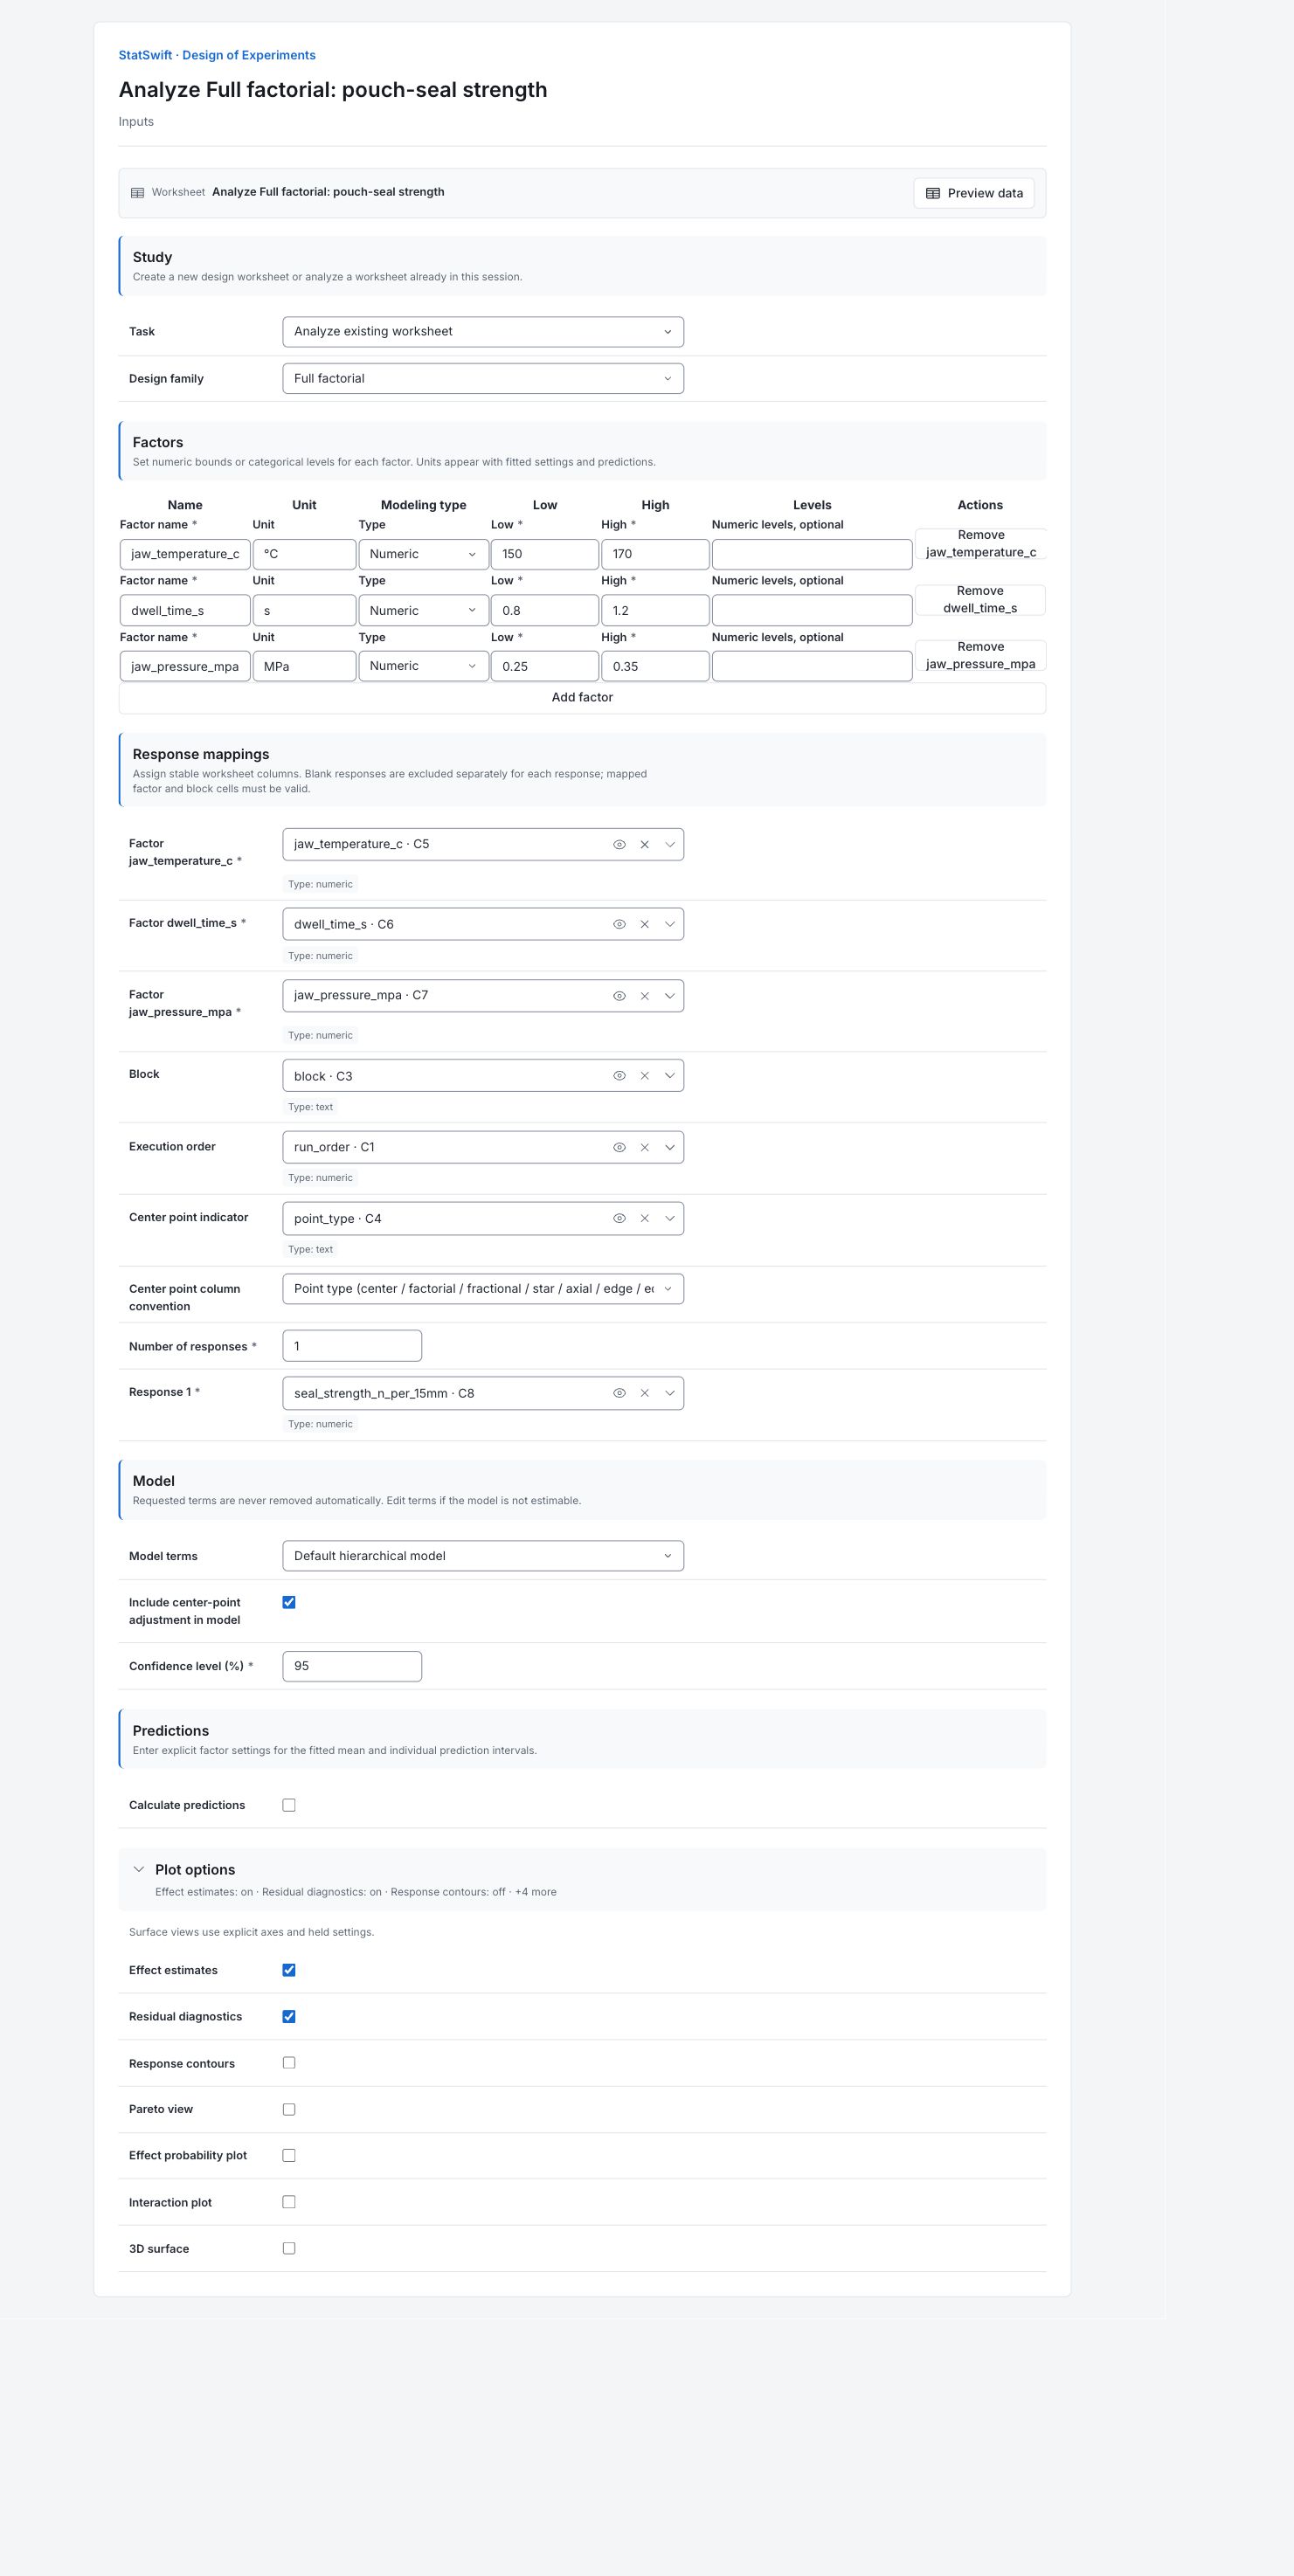
Wählen Sie unter Inputs für Task die Option Analyze existing worksheet und für Design family die Option Full factorial.
Verwenden Sie unter Factors die Option Add factor oder entfernen Sie eine Zeile, bis 3 Faktoren vorhanden sind. Behalten Sie diese Reihenfolge bei und stellen Sie Type für jeden Faktor auf Numeric.
Geben Sie die folgenden Werte für Factor name, Unit, Low und High ein.
| Faktor | Faktorname | Einheit | Untere Stufe | Obere Stufe |
|---|---|---|---|---|
| A | jaw_temperature_c | °C | 150 | 170 |
| B | dwell_time_s | s | 0.8 | 1.2 |
| C | jaw_pressure_mpa | MPa | 0.25 | 0.35 |
Lassen Sie Numeric levels, optional leer.
4. Eingabespalten zuweisen
Öffnen Sie unter Response mappings jede Spaltenauswahl und wählen Sie die passende Arbeitsblattspalte.
| Arbeitsblattspalte | Eingabefeld |
|---|---|
jaw_temperature_c | Factor jaw_temperature_c |
dwell_time_s | Factor dwell_time_s |
jaw_pressure_mpa | Factor jaw_pressure_mpa |
Weisen Sie seal_strength_n_per_15mm dem Feld Response 1 zu und geben Sie bei Number of responses den Wert 1 ein. Weisen Sie run_order dem Feld Execution order und point_type dem Feld Center point indicator zu. Wählen Sie für Center point column convention die Option Point type (center / factorial / fractional / star / axial / edge / edge_midpoint).
Weisen Sie block dem Feld Block zu, damit die beiden Versuchstage im Modell berücksichtigt werden.
5. Modell und Diagramme einstellen
Wählen Sie unter Model für Model terms die Option Default hierarchical model und geben Sie bei Confidence level (%) den Wert 95 ein. Aktivieren Sie Include center-point adjustment in model. Lassen Sie Calculate predictions deaktiviert.
Öffnen Sie Plot options. Aktivieren Sie Effect estimates und Residual diagnostics. Lassen Sie Response contours deaktiviert. Lassen Sie auch Pareto view, Effect probability plot, Interaction plot und 3D surface deaktiviert.
6. Arbeitsblatt auswerten
Wählen Sie Analyze worksheet und öffnen Sie anschließend Results. Dabei wird ein Modell an die erfassten Messwerte angepasst; es wird kein neuer Versuchsplan erstellt oder randomisiert.
7. Ergebnisse interpretieren
Mit den aufgezeichneten Läufen beginnen
Alle 22 Siegelläufe sind enthalten. Die acht Kombinationen aus unteren und oberen Faktorstufen wurden an zwei Tagen wiederholt, mit drei Zentralläufen pro Tag. Das Modell berücksichtigt die beiden Tage. Jede Zielgröße ist die gemessene Festigkeit einer unabhängig hergestellten Siegelnaht.
Prüfen, ob dem Modell ein Muster entgeht
Betrachten Sie Lack of Fit in Adjusted term ANOVA. Der p-Wert beträgt 0.9725; auf dem 5%-Niveau erkennt dieser Test somit kein fehlendes Muster. Das beweist nicht, dass das Modell korrekt ist. Der Tageseffekt hat p = 0.01595; behalten Sie die Blockkorrektur beim Vergleich der Einstellungen bei.
Effekte auswerten
Die Temperatur hat mit etwa +5.97 N je 15 mm den größten geschätzten Effekt beim Wechsel von der unteren zur oberen Stufe. Die Verweilzeit trägt etwa +3.99 bei, der Druck +1.25. Temperatur × Verweilzeit beträgt etwa +2.65; Temperatur × Druck etwa −1.51. Eine Wechselwirkung bedeutet, dass sich der Effekt eines Faktors mit der Einstellung eines anderen ändert. Diese Haupteffekte gelten nicht unverändert für jede Kombination.

Englischsprachiges Originaldiagramm: geschätzte Effekte von der unteren zur oberen Stufe mit 95%-Konfidenzintervallen. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Ein Residuum auswerten
Ein Residuum ist die gemessene Zielgröße abzüglich des angepassten Werts. Lauf 11 ergab 23.87 N je 15 mm; das Modell lieferte 22.55, sodass etwa +1.32 unerklärt bleiben. Dies ist das betragsmäßig größte unstandardisierte Residuum. Achten Sie im Diagramm auf Krümmungen, wechselnde Streuung oder ungewöhnliche Punkte.

Englischsprachiges Originaldiagramm: Residuen in N je 15 mm gegen die angepasste Zielgröße. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Laufreihenfolge prüfen
Die horizontale Achse folgt der aufgezeichneten Ausführungsreihenfolge. Achten Sie auf Drift, Zyklen oder einen plötzlichen Wechsel in den Residuen. Ein Muster kann darauf hindeuten, dass das Modell eine Änderung während des Versuchs nicht erfasst hat; das Diagramm bestimmt deren Ursache nicht.

Englischsprachiges Originaldiagramm: Residuen in N je 15 mm in aufgezeichneter Ausführungsreihenfolge. Diagramm in voller Größe ansehen (öffnet sich in einem neuen Tab) Bestätigungslauf auswählen
Prüfen Sie die Aufzeichnungen ungewöhnlicher Läufe und vergleichen Sie die Kombinationen unter Berücksichtigung ihrer Wechselwirkungen und der Tageskorrektur. Bestätigen Sie eine vielversprechende, umsetzbare Einstellung mit neuen, unabhängig hergestellten Siegelnähten. Der größte Haupteffekt allein bestimmt nicht die beste Betriebseinstellung.
Weitere Einzelheiten: die einzelnen Ergebnisabschnitte lesen
Vollständige Ergebnistabellen verwenden wie im Bereich Help sechs signifikante Stellen.
Modellübersicht
Analyzed runs beträgt 22; Missing runs beträgt 0. DF zählt die für das Modell und den Restfehler verfügbare Information. S ist die Residualstandardabweichung in N je 15 mm. R² beschreibt die in diesen Läufen erklärte Streuung; das korrigierte R² berücksichtigt die Modellgröße. Angaben zu PRESS und vorhergesagtem R² finden Sie unter Details zu Vorhersagen und Koeffizienten. Ein hohes R² belegt keine ausreichende Modelleignung. Lesen Sie den Lack-of-Fit-Test und die Residuendiagramme.
| Kennzahl | Wert |
|---|---|
| Zielgröße | seal_strength_n_per_15mm |
| Ausgewertete Versuche | 22 |
| Fehlende Zielgrößenwerte | 0 |
| Rang der Modellmatrix | 9 |
| Residuenfreiheitsgrade | 13 |
| S | 0.565919 |
| R² | 0.983747 |
| Korrigiertes R² | 0.973744 |
| PRESS | 9.07951 |
| Vorhergesagtes R² | 0.964555 |
| Konfidenzniveau | 0.95 |
| Test auf fehlende Anpassung verfügbar | Ja |
ANOVA mit adjustierten Termtests
Source bezeichnet den Modellterm oder die Fehlerkomponente. Type unterscheidet adjustierte Termtests von Gesamtsummen und Fehlerzerlegung. DF bezeichnet die Freiheitsgrade, SS die Quadratsumme und MS den Quotienten aus SS und DF. F vergleicht die Streuung mit ihrer Fehlerschätzung; der p-Wert misst die Evidenz gegen die geprüfte Nullhypothese. Lesen Sie Lack of Fit, bevor Sie sich auf einzelne Effekte stützen. Ein Strich bedeutet, dass eine Kennzahl nicht anwendbar ist.
| Quelle | Typ | DF | SS | MS | F | p-Wert |
|---|---|---|---|---|---|---|
| jaw_temperature_c | korrigiert | 1 | 142.325 | 142.325 | 444.398 | 1.95327e-11 |
| dwell_time_s | korrigiert | 1 | 63.6006 | 63.6006 | 198.588 | 2.97481e-9 |
| jaw_pressure_mpa | korrigiert | 1 | 6.2001 | 6.2001 | 19.3593 | 0.000717766 |
| jaw_temperature_c × dwell_time_s | korrigiert | 1 | 28.037 | 28.037 | 87.5433 | 3.87092e-7 |
| jaw_temperature_c × jaw_pressure_mpa | korrigiert | 1 | 9.1204 | 9.1204 | 28.4777 | 0.000135106 |
| dwell_time_s × jaw_pressure_mpa | korrigiert | 1 | 0.245025 | 0.245025 | 0.76507 | 0.397618 |
| Block | korrigiert | 1 | 2.45557 | 2.45557 | 7.66731 | 0.0159483 |
| Zentralpunkt | korrigiert | 1 | 0.00950303 | 0.00950303 | 0.0296724 | 0.865888 |
| Modell | Zusammenfassung | 8 | 251.993 | 31.4991 | 98.3535 | 2.27367e-10 |
| Fehler | Zusammenfassung | 13 | 4.16344 | 0.320265 | — | — |
| Gesamt | Zusammenfassung | 21 | 256.157 | 12.1979 | — | — |
| Reiner Fehler | Zerlegung | 4 | 2.78713 | 0.696783 | — | — |
| Fehlende Anpassung | Zerlegung | 9 | 1.37631 | 0.152923 | 0.21947 | 0.972452 |
Koeffizienten
Term bezeichnet einen codierten Modellterm. Estimate ist sein geschätzter Koeffizient; SE misst die Unsicherheit; t und p-value prüfen einen Koeffizienten von null. CI low und CI high begrenzen sein 95%-Intervall. Numerische untere, mittlere und obere Einstellungen werden als −1, 0 und +1 codiert. Bei Wechselwirkungen oder quadratischen Termen beschreibt ein Hauptkoeffizient nicht die Änderung bei jeder Einstellung.
| Term | Schätzwert | SE | t | p-Wert | Untere Konfidenzgrenze | Obere Konfidenzgrenze |
|---|---|---|---|---|---|---|
| Achsenabschnitt | 22.935 | 0.14148 | 162.108 | 7.05502e-23 | 22.6294 | 23.2406 |
| jaw_temperature_c | 2.9825 | 0.14148 | 21.0807 | 1.95327e-11 | 2.67685 | 3.28815 |
| dwell_time_s | 1.99375 | 0.14148 | 14.0921 | 2.97481e-9 | 1.6881 | 2.2994 |
| jaw_pressure_mpa | 0.6225 | 0.14148 | 4.39992 | 0.000717766 | 0.316851 | 0.928149 |
| jaw_temperature_c × dwell_time_s | 1.32375 | 0.14148 | 9.35646 | 3.87092e-7 | 1.0181 | 1.6294 |
| jaw_temperature_c × jaw_pressure_mpa | -0.755 | 0.14148 | -5.33645 | 0.000135106 | -1.06065 | -0.449351 |
| dwell_time_s × jaw_pressure_mpa | 0.12375 | 0.14148 | 0.874683 | 0.397618 | -0.181899 | 0.429399 |
| Block · Kontrast 1 | -0.334091 | 0.120654 | -2.76899 | 0.0159483 | -0.594749 | -0.0734329 |
| Zentralpunkt | -0.0466667 | 0.270913 | -0.172257 | 0.865888 | -0.631939 | 0.538606 |
Faktorielle Effekte
Effect ist der geschätzte Kontrast zwischen oberer und unterer Stufe. SE misst die Unsicherheit; CI low und CI high geben sein 95%-Intervall an. Standardized effect ist der Betrag des Effekts geteilt durch seinen SE. Eine Wechselwirkung bedeutet, dass sich der Effekt eines Faktors mit der Einstellung eines anderen ändert.
| Term | Effekt | SE | Untere Konfidenzgrenze | Obere Konfidenzgrenze | Standardisierter Effekt |
|---|---|---|---|---|---|
| jaw_temperature_c | 5.965 | 0.28296 | 5.3537 | 6.5763 | 21.0807 |
| dwell_time_s | 3.9875 | 0.28296 | 3.3762 | 4.5988 | 14.0921 |
| jaw_pressure_mpa | 1.245 | 0.28296 | 0.633703 | 1.8563 | 4.39992 |
| jaw_temperature_c × dwell_time_s | 2.6475 | 0.28296 | 2.0362 | 3.2588 | 9.35646 |
| jaw_temperature_c × jaw_pressure_mpa | -1.51 | 0.28296 | -2.1213 | -0.898703 | 5.33645 |
| dwell_time_s × jaw_pressure_mpa | 0.2475 | 0.28296 | -0.363797 | 0.858797 | 0.874683 |
Zeilendiagnostik
Row ID kennzeichnet die Arbeitsblattzeile; Run order verortet sie in der Versuchsfolge. Status gibt an, ob sie ausgewertet wurde. Observed ist der Messwert, Fit der Modellwert und Residual die Differenz aus Observed und Fit. Standardized residual berücksichtigt Residuenstreuung und Hebelwirkung. Leverage misst, wie ungewöhnlich die Modelleingaben sind. Alle aufgezeichneten Zeilen werden angezeigt. Untersuchen Sie eine ungewöhnliche Zeile, bevor Sie sie ändern oder ausschließen.
| Zeilen-ID | Laufreihenfolge | Status | Beobachtet | Angepasster Wert | Residuum | Standardisiertes Residuum | Hebelwirkung |
|---|---|---|---|---|---|---|---|
| help-doe-getting-started-1 | 1 | Ausgewertet | 18.72 | 18.7872 | -0.0671591 | -0.165039 | 0.482955 |
| help-doe-getting-started-2 | 2 | Ausgewertet | 28.38 | 28.9097 | -0.529659 | -1.3016 | 0.482955 |
| help-doe-getting-started-3 | 3 | Ausgewertet | 17.82 | 17.6947 | 0.125341 | 0.308017 | 0.482955 |
| help-doe-getting-started-4 | 4 | Ausgewertet | 22.53 | 22.5542 | -0.0242424 | -0.0482605 | 0.212121 |
| help-doe-getting-started-5 | 5 | Ausgewertet | 22.09 | 22.5222 | -0.432159 | -1.062 | 0.482955 |
| help-doe-getting-started-6 | 6 | Ausgewertet | 21.89 | 22.5542 | -0.664242 | -1.32234 | 0.212121 |
| help-doe-getting-started-7 | 7 | Ausgewertet | 21.83 | 21.7897 | 0.0403409 | 0.099135 | 0.482955 |
| help-doe-getting-started-8 | 8 | Ausgewertet | 22 | 22.0097 | -0.00965909 | -0.0237365 | 0.482955 |
| help-doe-getting-started-9 | 9 | Ausgewertet | 20.45 | 20.2022 | 0.247841 | 0.609052 | 0.482955 |
| help-doe-getting-started-10 | 10 | Ausgewertet | 28.89 | 28.8922 | -0.00215909 | -0.00530581 | 0.482955 |
| help-doe-getting-started-11 | 11 | Ausgewertet | 23.87 | 22.5542 | 1.31576 | 2.61934 | 0.212121 |
| help-doe-getting-started-12 | 12 | Ausgewertet | 20.68 | 20.8703 | -0.190341 | -0.467749 | 0.482955 |
| help-doe-getting-started-13 | 13 | Ausgewertet | 23.47 | 23.2224 | 0.247576 | 0.49286 | 0.212121 |
| help-doe-getting-started-14 | 14 | Ausgewertet | 18.18 | 18.3628 | -0.182841 | -0.449319 | 0.482955 |
| help-doe-getting-started-15 | 15 | Ausgewertet | 22.32 | 23.2224 | -0.902424 | -1.7965 | 0.212121 |
| help-doe-getting-started-16 | 16 | Ausgewertet | 29.62 | 29.5603 | 0.0596591 | 0.146608 | 0.482955 |
| help-doe-getting-started-17 | 17 | Ausgewertet | 30.05 | 29.5778 | 0.472159 | 1.1603 | 0.482955 |
| help-doe-getting-started-18 | 18 | Ausgewertet | 19.58 | 19.4553 | 0.124659 | 0.306341 | 0.482955 |
| help-doe-getting-started-19 | 19 | Ausgewertet | 22.63 | 22.6778 | -0.0478409 | -0.117566 | 0.482955 |
| help-doe-getting-started-20 | 20 | Ausgewertet | 23.25 | 23.2224 | 0.0275758 | 0.0548963 | 0.212121 |
| help-doe-getting-started-21 | 21 | Ausgewertet | 22.36 | 22.4578 | -0.0978409 | -0.240437 | 0.482955 |
| help-doe-getting-started-22 | 22 | Ausgewertet | 23.68 | 23.1903 | 0.489659 | 1.2033 | 0.482955 |
Faktorcodierung
Factor bezeichnet die Eingangsgröße und Type ihren Modellierungstyp. Center und Scale übersetzen numerische Einstellungen in codierte Werte: (Einstellung − Zentrum) / Skalierung. Der Mittelpunkt ist somit 0, und die eingegebenen unteren/oberen Grenzen entsprechen −1/+1. Levels / contrasts betrifft die kategoriale Codierung; ein Strich ist kein fehlender numerischer Messwert. Bewahren Sie die Hinweise zu Modellspalten, Blöcken und Rang zusammen mit dieser Tabelle auf.
| Faktor | Typ | Zentrum | Skalierung | Stufen / Kontraste |
|---|---|---|---|---|
| jaw_temperature_c | numerisch | 160 | 10 | — |
| dwell_time_s | numerisch | 1 | 0.2 | — |
| jaw_pressure_mpa | numerisch | 0.3 | 0.05 | — |
- Modellspalten: Intercept, jaw_temperature_c, dwell_time_s, jaw_pressure_mpa, jaw_temperature_c × dwell_time_s, jaw_temperature_c × jaw_pressure_mpa, dwell_time_s × jaw_pressure_mpa, Block · contrast 1, Center point
- Rangtoleranz: 1e-10
- Blockstufe: Day_1
- Blockstufe: Day_2
Koeffizientenkovarianz
Lesen Sie jeden Zeilen- und Spaltenterm gemeinsam. Diagonaleinträge sind die quadrierten Standardfehler der angepassten Koeffizienten. Einträge außerhalb der Diagonale beschreiben gemeinsame Schätzunsicherheit. Diese Matrix betrifft Modellkoeffizienten, keine Korrelationen zwischen den gemessenen Faktorspalten.
| Spalte | Konstante | jaw_temperature_c | dwell_time_s | jaw_pressure_mpa | jaw_temperature_c × dwell_time_s | jaw_temperature_c × jaw_pressure_mpa | dwell_time_s × jaw_pressure_mpa | Block · Kontrast 1 | Zentralpunkt |
|---|---|---|---|---|---|---|---|---|---|
| Achsenabschnitt | 0.0200165 | 0 | 0 | 0 | -1.73724e-18 | 0 | 0 | 0 | -0.0200165 |
| jaw_temperature_c | 0 | 0.0200165 | 1.25524e-18 | 1.59056e-18 | -2.37535e-18 | 1.14682e-18 | 6.87283e-19 | -3.11116e-19 | 2.40441e-19 |
| dwell_time_s | 0 | 1.25498e-18 | 0.0200165 | 1.41339e-18 | -8.20222e-18 | 2.83927e-18 | -2.97871e-18 | 9.96778e-18 | 8.55081e-21 |
| jaw_pressure_mpa | 0 | 1.34066e-18 | 1.85008e-18 | 0.0200165 | -8.38039e-19 | 1.83585e-19 | -4.22472e-18 | -8.36686e-18 | 4.86775e-20 |
| jaw_temperature_c × dwell_time_s | -1.73724e-18 | -1.7558e-18 | -8.74062e-18 | -7.0199e-19 | 0.0200165 | -2.49201e-18 | 6.54714e-18 | -4.5524e-18 | 4.71332e-18 |
| jaw_temperature_c × jaw_pressure_mpa | 0 | 1.09564e-18 | 2.83401e-18 | 3.04389e-19 | -1.87779e-18 | 0.0200165 | 8.66089e-19 | -4.98088e-19 | -6.83801e-21 |
| dwell_time_s × jaw_pressure_mpa | 0 | 1.56378e-19 | -2.08591e-18 | -3.66915e-18 | 7.17073e-18 | 5.66413e-19 | 0.0200165 | 1.36697e-18 | 2.63412e-19 |
| Block · Kontrast 1 | 0 | -3.11116e-19 | 9.96778e-18 | -8.36686e-18 | -4.5524e-18 | -4.98088e-19 | 1.36697e-18 | 0.0145575 | 4.24889e-34 |
| Zentralpunkt | -0.0200165 | 2.40441e-19 | 8.55081e-21 | 4.86775e-20 | 4.71332e-18 | -6.83801e-21 | 2.63412e-19 | 4.24889e-34 | 0.073394 |
Details zu Vorhersagen und Koeffizienten
PRESS ist die Summe der quadrierten Leave-one-out-Vorhersagefehler: Jeder Lauf wird durch ein Modell vorhergesagt, das ohne diesen Lauf angepasst wurde. Das vorhergesagte R² verwendet diese Fehler. Die Koeffizientenkovarianz beschreibt die Schätzunsicherheit; ihre Diagonaleinträge sind die quadrierten Standardfehler der Koeffizienten. Diese Diagnosen ergänzen den Lack-of-Fit-Test und die Residuenprüfungen, ersetzen sie aber nicht.
8. Bericht erstellen
Bewahren Sie im englischsprachigen Originalbericht Model overview, Adjusted term ANOVA, Coefficients, Coefficient covariance, Row diagnostics und Factor coding sowie die Tabelle Factorial effects und die Effekt- und Residuendiagramme auf. Ergänzen Sie die Einheiten der Zielgröße, Faktoreinstellungen, aufgezeichnete Laufreihenfolge und alle Modellhinweise. Halten Sie das Ergebnis des Lack-of-Fit-Tests zusammen mit den Residuenprüfungen fest; allein bestätigt es die Eignung des Modells nicht.
Wählen Sie Add to report im abgeschlossenen Analyselauf. Öffnen Sie Choose individual items and advanced options zur Auswahl von Tabellen und Diagrammen und wählen Sie anschließend Add to draft. Ausgeblendete Elemente bleiben in der gespeicherten Analyse erhalten.
Geben Sie dem Bericht einen Namen und ergänzen Sie den Zweck der Untersuchung sowie Ihre Interpretation. Wählen Sie Save, prüfen Sie Preview und verwenden Sie anschließend Export → Download HTML. Das folgende Beispiel enthält den gesamten ausgewählten Inhalt, auch Ergebnisse, die über eine Bildschirmansicht hinausgehen.