

アプリのコマンド名、ワークシートの識別子、サンプルデータの値は原文のまま表示されます。スクリーンショット、グラフ、ダウンロードファイルは英語です。例では英語の元の数値表記を保持しており、小数点にはピリオド、桁区切りにはカンマを使用しています。
例: Cell Aのシール強度の分散
Cell Aで測定した、互いに独立な45個のパウチ強度の値を使用します。参照CSVにはCell Bの測定値も含まれています。
調査の参照データをダウンロード(CSV、列名は英語)Help で使用している例と同じです。CSVは、この調査の参照データです。確認済みの要約統計量を Inputs に手入力します。CSVをインポートしても、この計算ツールには値が入力されません。Helpの Open example in a practice copy を使用すると、入力値をあらかじめ設定できます。
1. ワークスペースを作成
サイドバーで Basic Statistics を開き、Confidence Intervals を選択します。分析を作成して名前を付け、New blank worksheet を選択してから Create analysis を選択します。
2. 区間を選択
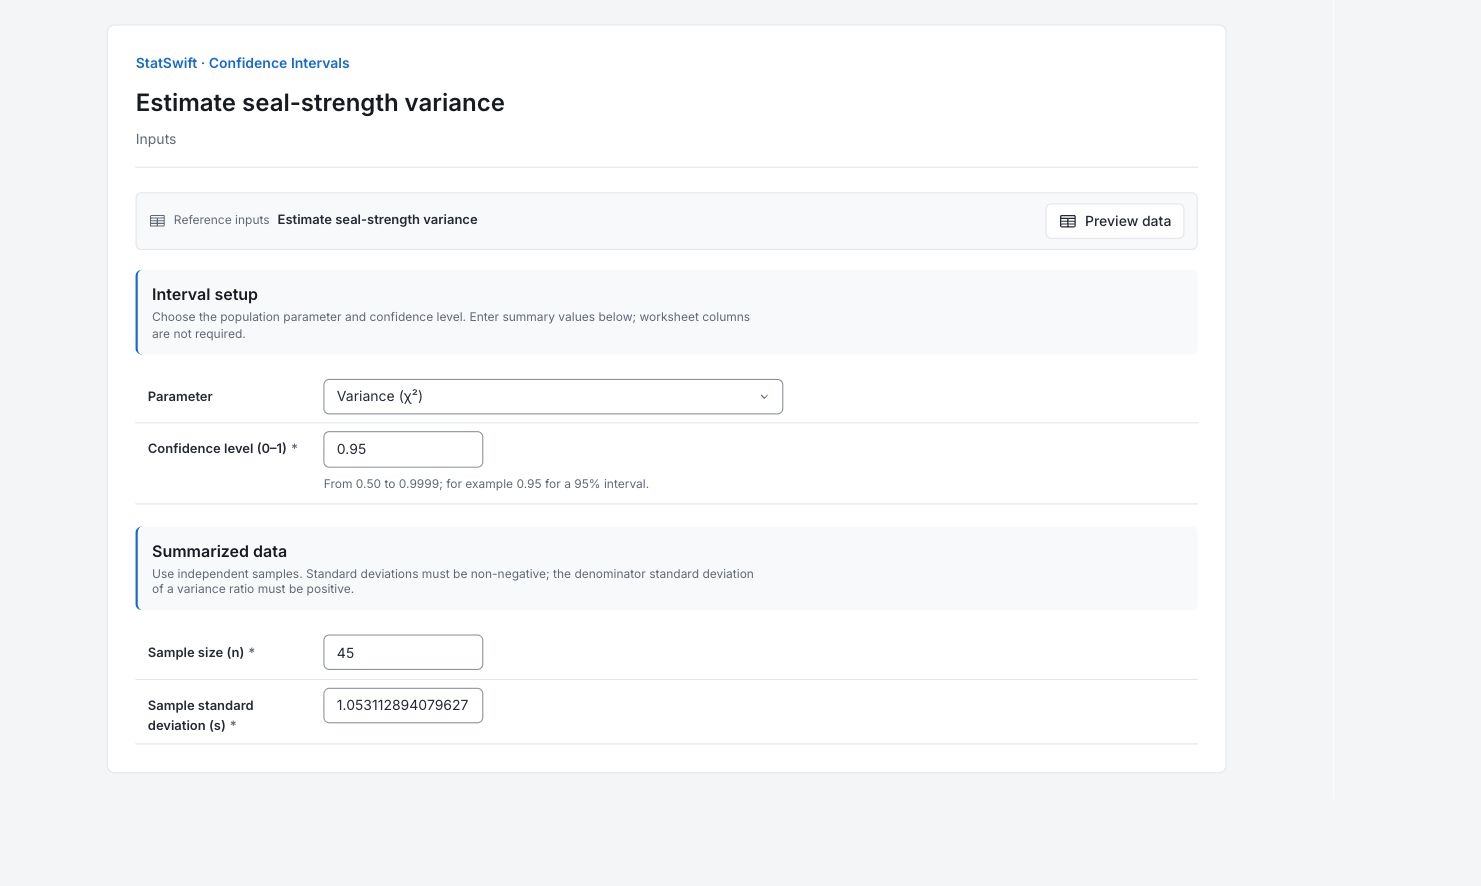
Inputs の Parameter で Variance (χ²) を選択します。95%区間を求めるには、Confidence level (0–1) に 0.95 を入力します。
3. 要約統計量を入力
Summarized data に次の値を入力します。標準偏差は、表示されているすべての桁を入力します。ワークシートの列は割り当てません。
Sample size (n) に 45 を入力します。
Sample standard deviation (s) に 1.053112894079627 を入力します。
4. 分析を実行
Run analysis を選択し、Results を開きます。
5. 結果を解釈
区間が推定する対象を確認
Cell Aで測定した、互いに独立な45個のパウチ強度の値を使用します。参照CSVにはCell Bの測定値も含まれています。選択したパラメータは分散(χ²)です。
推定値と区間の上下限を確認
分散の推定値は1.1091 N²で、95%区間は0.7601–1.7697 N²です。分散は標準偏差を二乗した値です。
解釈を明確にする
このカイ二乗区間は、母集団が正規分布に従うことと、観測値が独立であることを前提とします。推定するのはばらつきであり、母平均や個々の強度の許容範囲ではありません。
不確かさを意思決定に反映
計算でばらつきを二乗で扱う必要がある場合は、分散を使用します。ニュートン単位で検討する場合は、対応する標準偏差の区間を使用します。
詳細:各結果セクションを確認
完全な結果表は、Helpと同じく有効数字六桁で表示されます。
信頼区間
「パラメータ」は母集団のどの量を推定するかを示します。信頼水準0.95とは、前提を満たす同様の標本抽出を繰り返したとき、この方法で求める区間の95%が、固定された母集団パラメータを含むという意味です。「推定値」は標本から求めた値で、「下限」と「上限」はその不確かさを示します。「方法」は計算方法を記録します。このカイ二乗区間は、母集団が正規分布に従うことと、観測値が独立であることを前提とします。推定するのはばらつきであり、母平均や個々の強度の許容範囲ではありません。
| 統計量 | 値 |
|---|---|
| パラメータ | 分散(χ²) |
| 信頼水準 | 0.95 |
| 推定値 | 1.10905 |
| 下限 | 0.760077 |
| 上限 | 1.76968 |
| 方法 | カイ二乗 |
6. レポートを作成
Confidence interval 表全体と、選択したパラメータ、信頼水準、方法、入力した要約統計量を残します。このカイ二乗区間は、母集団が正規分布に従うことと、観測値が独立であることを前提とします。推定するのはばらつきであり、母平均や個々の強度の許容範囲ではありません。
完了した分析で Add to report を選択します。続いて Choose individual items and advanced options を開いて表とグラフを選び、 Add to draftを選択します。非表示の項目は保存済みの分析に残ります。
レポート名を入力し、調査の目的と解釈を追加します。 Saveで保存し、 Previewで内容を確認して、 Export → Download HTMLを選択します。以下の例には、画面外の結果も含め、選択した内容全体が含まれます。