

Los comandos de la aplicación, los identificadores de las hojas de trabajo y los valores de los datos de ejemplo conservan su redacción original. Las capturas de pantalla, los gráficos y las descargas están en inglés. Los ejemplos conservan la notación numérica original en inglés: punto decimal y coma como separador de millares.
Ejemplo: inspección estética
Dos inspectores clasifican cada uno las mismas 60 carcasas pintadas como Accept o Reject. Desconocen la decisión de referencia de un panel de calidad. El estudio incluye casos claros y casos límite, con 120 clasificaciones en total.
Descargar el ejemplo de inspección estética (CSV, columnas en inglés)Es el mismo ejemplo que se utiliza en Help. sample_id identifica la carcasa, operator_id identifica al inspector, trial es 1, decision contiene la clasificación del inspector y reference_decision contiene la clasificación de referencia del panel.
1. Crear el análisis
En la barra lateral, abre Measurement systems, elige Kappa (Attributes) y ponle un nombre al análisis. Selecciona New blank worksheet y Create analysis.
2. Importar los datos
En Worksheet, elige Import. Selecciona el archivo descargado o pega su contenido. Establece Comma como delimitador, utiliza Decimal dot y marca First row contains column names. Revisa la vista previa de la importación y elige Import into worksheet. Conserva todas las filas en su orden original.
3. Asignar las columnas de entrada
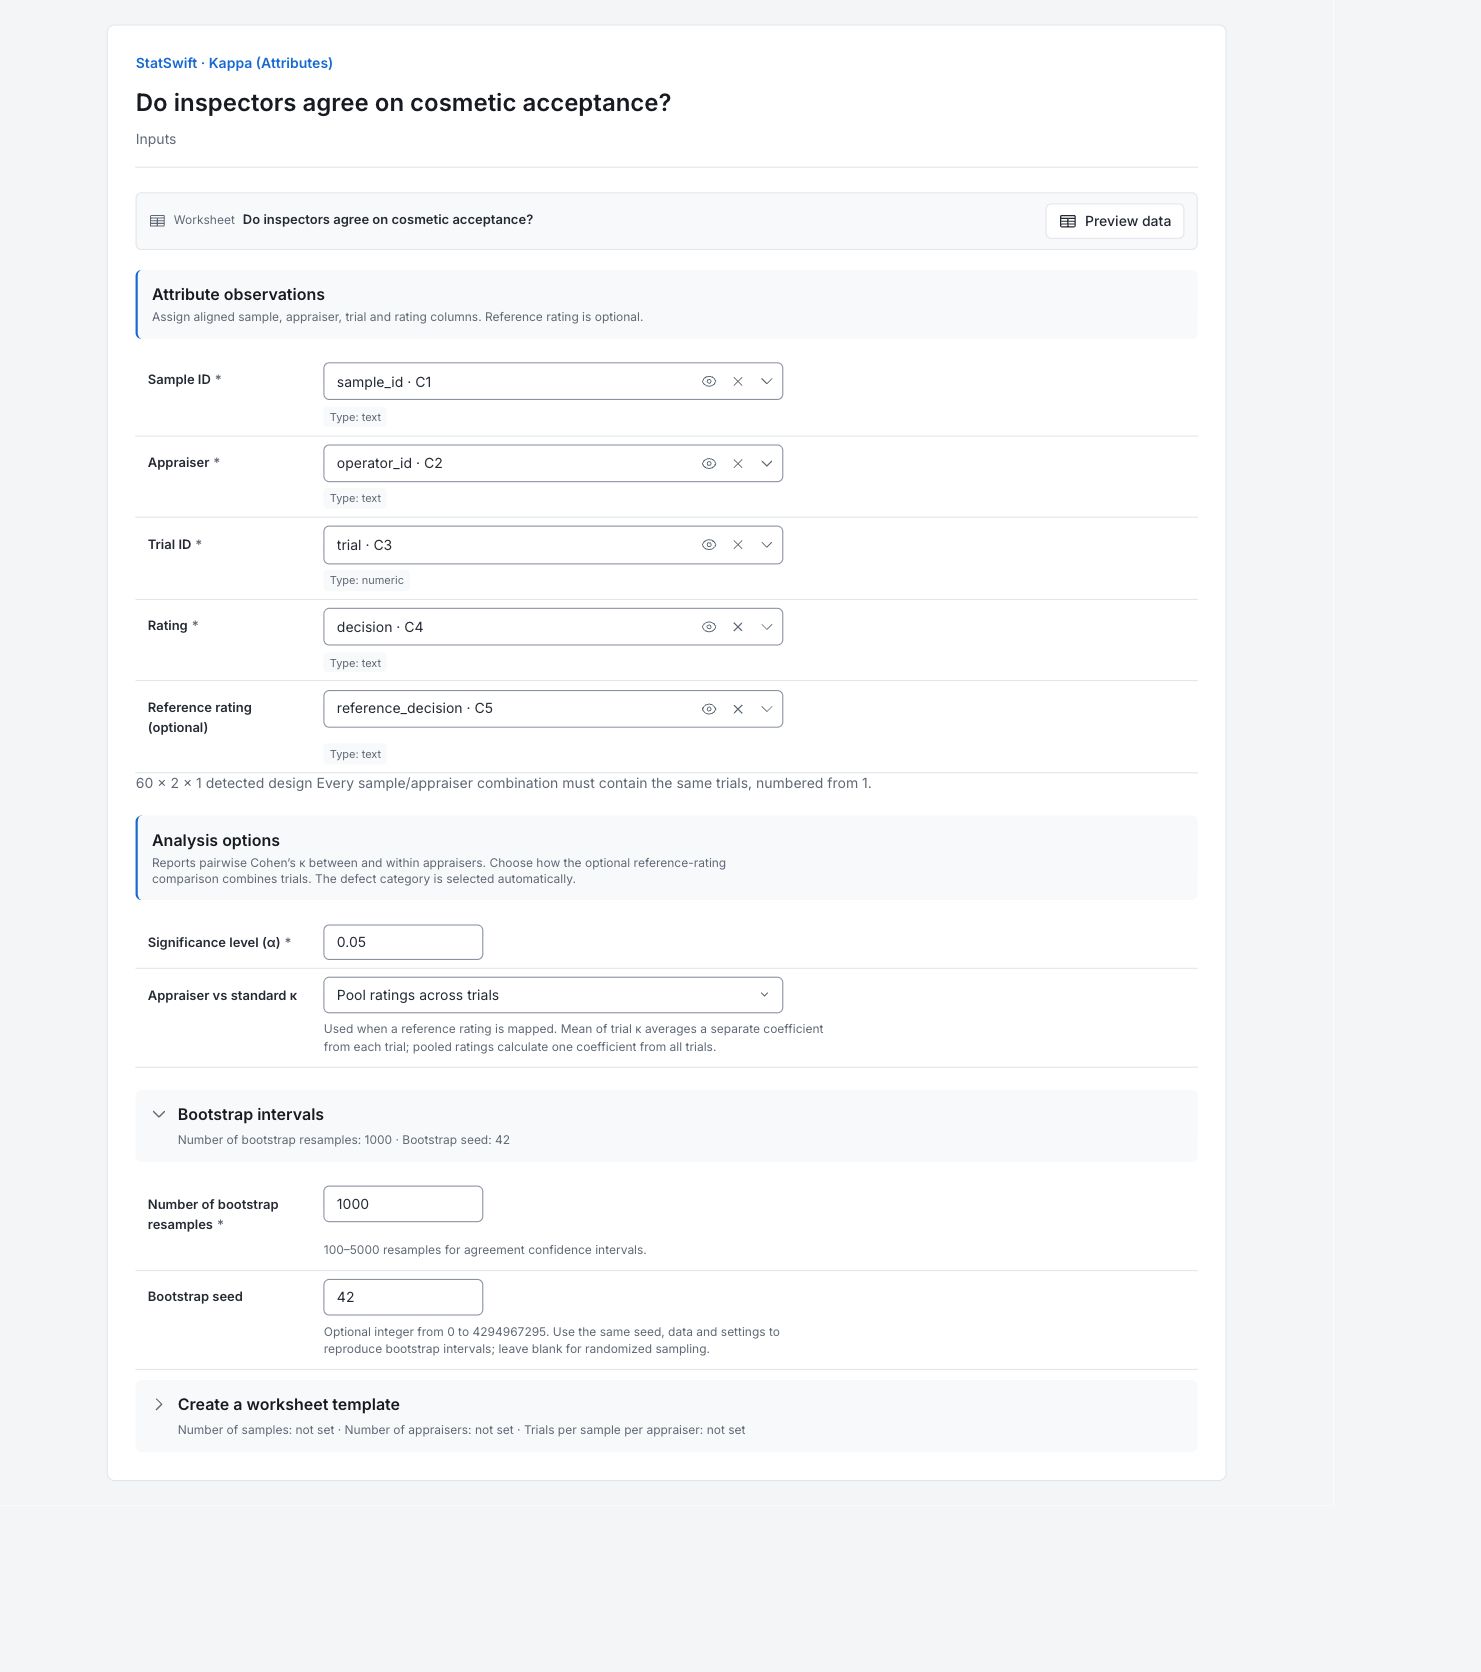
En Inputs, asigna sample_id a Sample ID, operator_id a Appraiser, trial a Trial ID, decision a Rating y reference_decision a Reference rating (optional), seleccionando cada columna en el selector.
Comprueba que la aplicación detecte 60 × 2 × 1: 60 carcasas, dos inspectores y una repetición.
4. Configurar las opciones del estudio
Introduce 0.05 en Significance level (α). En Appraiser vs standard κ, elige Pool ratings across trials.
Abre Bootstrap intervals. Introduce 1000 en Number of bootstrap resamples y 42 en Bootstrap seed. Utiliza el mismo orden de datos y la misma semilla para reproducir los intervalos. No necesitas Create a worksheet template para este estudio importado. El remuestreo bootstrap toma repetidamente muestras con reemplazo de las carcasas del estudio para estimar la incertidumbre de los intervalos. La semilla fija esa secuencia de muestreo para que los intervalos puedan reproducirse; no los hace más exactos.
5. Ejecutar el análisis
Elige Run analysis y abre Results.
6. Interpretar los resultados
Comparar los inspectores
Los inspectores coinciden en 48 de 60 carcasas, es decir, el 80%. El mapa de calor muestra κ de Cohen = 0.5946, que ajusta la concordancia por la coincidencia esperable por azar a partir de sus totales de clasificación. El intervalo del 95% es aproximadamente 0.3667–0.7966. κ no es un porcentaje de exactitud.
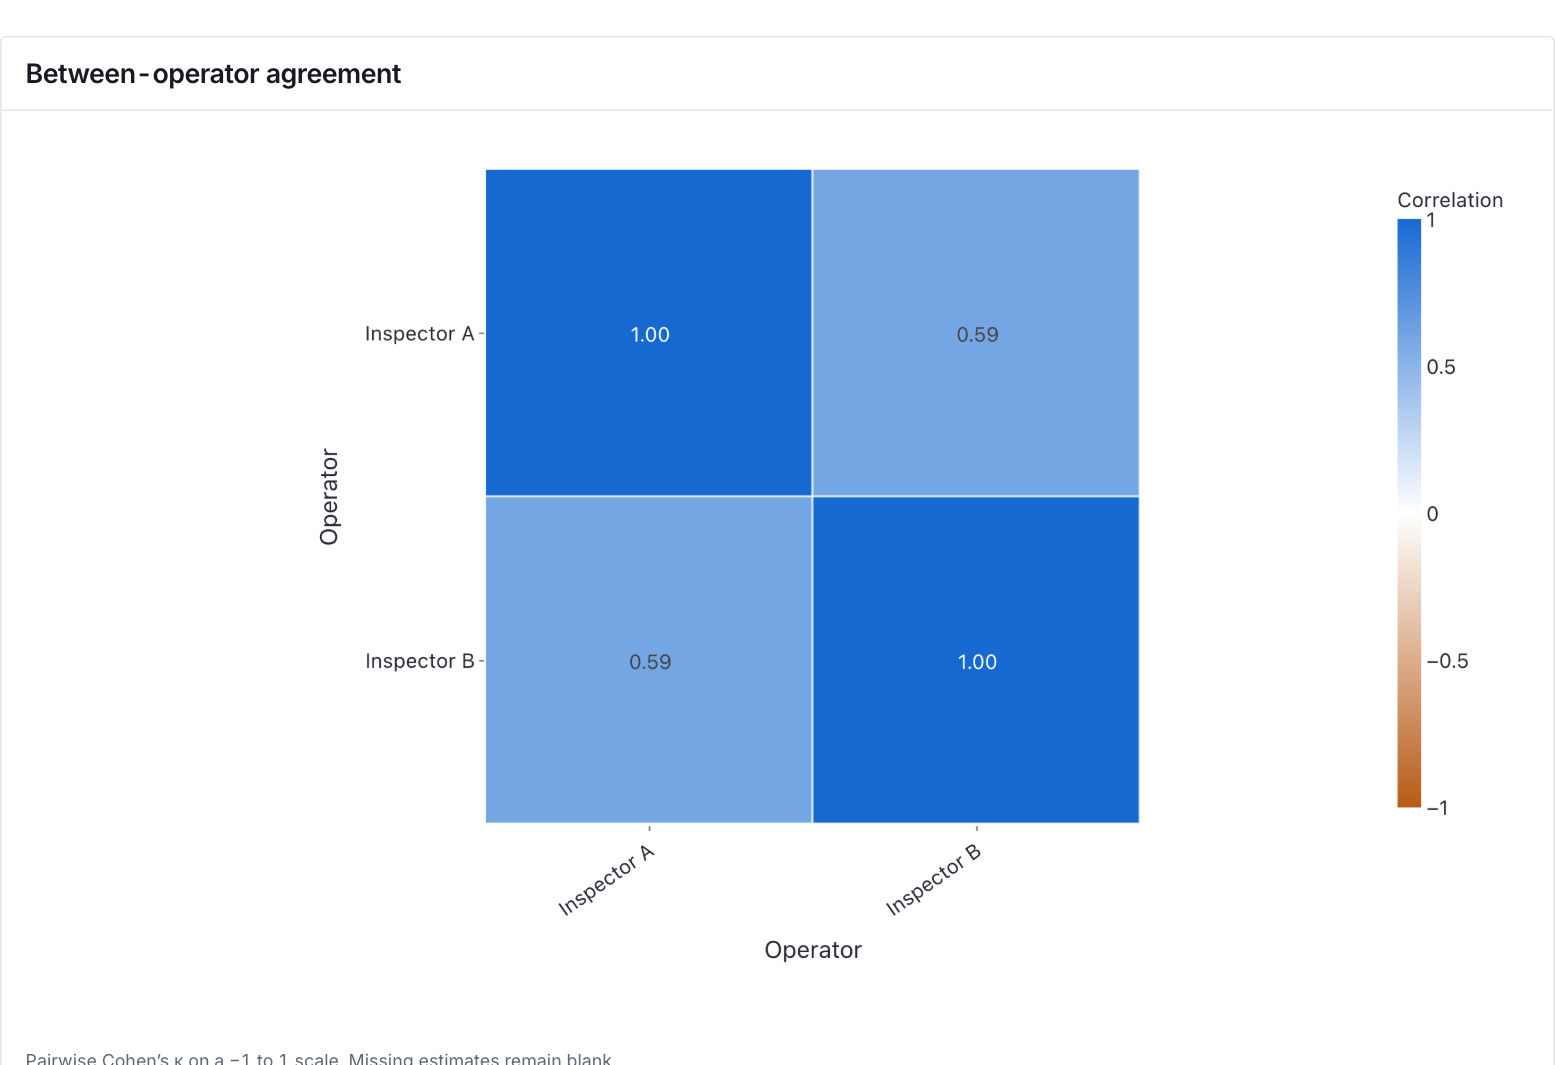
Mapa de calor en inglés de κ de Cohen entre los dos inspectores. Es concordancia ajustada por azar, no un porcentaje de exactitud. Ver gráfico a tamaño completo (se abre en una nueva pestaña) Comparar con la referencia
Ambos inspectores coinciden con 52 de 60 decisiones de referencia. El inspector A no detecta cuatro rechazos de referencia y rechaza cuatro aceptaciones de referencia. El inspector B no detecta dos rechazos de referencia y rechaza seis aceptaciones de referencia. La misma tasa global de coincidencia oculta tipos de error distintos.
Leer las tablas de errores
La flecha se lee decisión del inspector → decisión de referencia. Accept→Reject es un rechazo no detectado; Reject→Accept es una falsa alarma. Las tasas de rechazos no detectados utilizan los 24 rechazos de referencia. Las tasas de falsas alarmas utilizan las 36 aceptaciones de referencia.
Tener presente el diseño del estudio
El estudio contiene un 60% de aceptaciones de referencia y un 40% de rechazos de referencia. Esta composición afecta a κ y no es la tasa de rechazo de producción. Cada inspector clasifica cada carcasa una vez, por lo que el estudio no puede comprobar si un inspector repite de forma fiable la misma decisión.
Decidir qué revisar
Revisa las carcasas en disputa frente a los criterios de inspección escritos. Considera por separado los rechazos no detectados y las falsas alarmas. Realiza otra ronda de evaluación en el estudio si necesitas evaluar la consistencia de cada inspector.
Más detalles: leer cada sección de resultados
Las tablas de resultados completas utilizan seis cifras significativas, como en Help.
Entre inspectores (κ por pares)
Los inspectores coinciden en 48 de 60 carcasas (80%). La concordancia esperada a partir de sus frecuencias marginales de categoría es 50.67%, lo que da κ de Cohen = 0.5946. El intervalo bootstrap del 95% con semilla es aproximadamente 0.3667–0.7966. κ no es un porcentaje de exactitud y la concordancia entre inspectores no establece que sus decisiones sean correctas frente a la referencia.
| Primer observador / repetición | Segundo observador / repetición | Comparaciones | Concordancia observada P₀ | Concordancia esperada Pₑ | κ | Intervalo de confianza del 95% — inferior | Intervalo de confianza del 95% — superior |
|---|---|---|---|---|---|---|---|
| Inspector A | Inspector B | 60 | 0.8 | 0.506667 | 0.594595 | 0.366667 | 0.79661 |
Inspector frente a la referencia (exactitud)
Ambos inspectores coinciden con 52 de 60 decisiones de referencia (86.67%). Sus valores κ difieren ligeramente: 0.7222 para A y 0.7297 para B, porque sus frecuencias marginales de categoría difieren. Reject se trata como la categoría de defecto. Las tasas de rechazos no detectados son 16.67% para A y 8.33% para B; las tasas de falsas alarmas son 11.11% y 16.67%, respectivamente. Estas tasas utilizan denominadores de categorías de referencia distintos.
κ frente a la referencia utiliza un coeficiente de Cohen a partir de las clasificaciones combinadas de las repeticiones. La concordancia observada y la esperada son proporciones combinadas. La eficiencia y las tasas de rechazos no detectados y de falsas alarmas son proporciones (0–1).
| Inspector | Comparaciones | Concordancia observada P₀ | Concordancia esperada Pₑ | κ | Intervalo de confianza del 95% — inferior | Intervalo de confianza del 95% — superior | Eficiencia (todas) | Eficiencia (alguna) | Tasa de rechazos no detectados | Tasa de falsas alarmas |
|---|---|---|---|---|---|---|---|---|---|---|
| Inspector A | 60 | 0.866667 | 0.52 | 0.722222 | 0.507042 | 0.893365 | 0.866667 | — | 0.166667 | 0.111111 |
| Inspector B | 60 | 0.866667 | 0.506667 | 0.72973 | 0.533333 | 0.897727 | 0.866667 | — | 0.0833333 | 0.166667 |
Recuentos de confusión — Inspector A frente a la referencia
La flecha se lee decisión del inspector → decisión de referencia. Accept→Reject representa cuatro rechazos no detectados de los 24 rechazos de referencia. Reject→Accept representa cuatro falsas alarmas de las 36 aceptaciones de referencia. Las otras 52 decisiones coinciden con la referencia.
| Decisión → referencia | Recuento |
|---|---|
| Accept→Accept | 32 |
| Accept→Reject | 4 |
| Reject→Accept | 4 |
| Reject→Reject | 20 |
Recuentos de confusión — Inspector B frente a la referencia
El inspector B no detecta dos de los 24 rechazos de referencia y rechaza por error seis de las 36 aceptaciones de referencia. Por tanto, la misma concordancia total que el inspector A oculta un equilibrio distinto entre tipos de error.
| Decisión → referencia | Recuento |
|---|---|
| Accept→Accept | 30 |
| Accept→Reject | 2 |
| Reject→Accept | 6 |
| Reject→Reject | 22 |
Prevalencia de las categorías
La composición de referencia es 60% Accept y 40% Reject: 36 y 24 carcasas. Es la composición del estudio, no una estimación de la tasa de rechazo de producción. La prevalencia de las categorías afecta a la concordancia ajustada por azar, por lo que debes comparar valores κ solo con el contexto adecuado.
| Categoría | Proporción |
|---|---|
| Accept | 0.6 |
| Reject | 0.4 |
Kappa — resumen del estudio
Hay 60 muestras, dos inspectores y ninguna comparación descartada. Cada inspector clasifica cada muestra una vez, por lo que no puede evaluarse la repetibilidad de cada inspector. La semilla 42 con 1,000 remuestreos reproduce estos intervalos bootstrap con los mismos datos, ajustes y versión de cálculo. Deja la semilla vacía para un muestreo aleatorio.
| Estadístico | Valor |
|---|---|
| Piezas | 60 |
| Operadores | Inspector A, Inspector B |
| Categorías | Accept, Reject |
| Método entre operadores y dentro de cada operador | κ de Cohen |
| Tratamiento de las rondas al comparar con la referencia | Valoraciones combinadas |
| Comparaciones excluidas | 0 |
| Semilla del bootstrap | 42 |
Recuentos de contingencia — Inspector A / Inspector B
Los recuentos de contingencia comparan directamente al inspector A con el inspector B. Explican su concordancia observada; utiliza las tablas de confusión frente a la referencia para evaluar los rechazos no detectados y las falsas alarmas.
| Primera categoría | Segunda categoría | Recuento |
|---|---|---|
| Accept | Accept | 28 |
| Accept | Reject | 8 |
| Reject | Accept | 4 |
| Reject | Reject | 20 |
7. Crear un informe
Conserva Between operators (pairwise κ), Operator vs standard (accuracy), las dos tablas de recuentos de confusión frente a la referencia, Category prevalence, Kappa — study summary, los recuentos de contingencia entre inspectores y el mapa de calor de concordancia. Registra que cada inspector clasificó cada carcasa una vez.
Selecciona Add to report de la ejecución completada. Abre Choose individual items and advanced options para seleccionar tablas y gráficos y, a continuación, selecciona Add to draft. Los elementos ocultos se conservan en el análisis guardado.
Asigna un nombre al informe y añade el objetivo del estudio y tu interpretación. Selecciona Save, revisa Preview, y después utiliza Export → Download HTML. El ejemplo siguiente contiene todo el contenido seleccionado, incluidos los resultados que no caben en una sola pantalla.