

Os comandos da aplicação, os identificadores das folhas de cálculo e os valores dos dados dos exemplos mantêm a sua forma original. As capturas de ecrã, os gráficos e os ficheiros para transferência estão em inglês. Os exemplos científicos conservam o ponto decimal e a vírgula como separador de milhares da fonte original; os preços e as contagens do sítio seguem as convenções portuguesas.
Exemplo: inspeção do aspeto
Dois inspetores classificam, cada um, as mesmas 60 carcaças pintadas como Accept (aceitar) ou Reject (rejeitar). A decisão de referência de um painel de qualidade está oculta para eles. O estudo inclui casos evidentes e casos limítrofes, com 120 classificações no total.
Transfira o exemplo da inspeção do aspeto (CSV)Este é o mesmo exemplo utilizado em Help. sample_id identifica a carcaça, operator_id identifica o inspetor, trial é 1, decision contém a classificação do inspetor e reference_decision contém a classificação de referência do painel.
1. Crie a análise
Na barra lateral, abra Measurement systems, escolha Kappa (Attributes) e dê um nome à análise. Selecione New blank worksheet e Create analysis.
2. Importe os dados
Em Worksheet, escolha Import. Selecione o ficheiro transferido ou cole o seu conteúdo. Defina o delimitador como Comma, use Decimal dot e assinale First row contains column names. Pré-visualize a importação e escolha Import into worksheet. Conserve todas as linhas pela ordem original.
3. Atribua as colunas de entrada
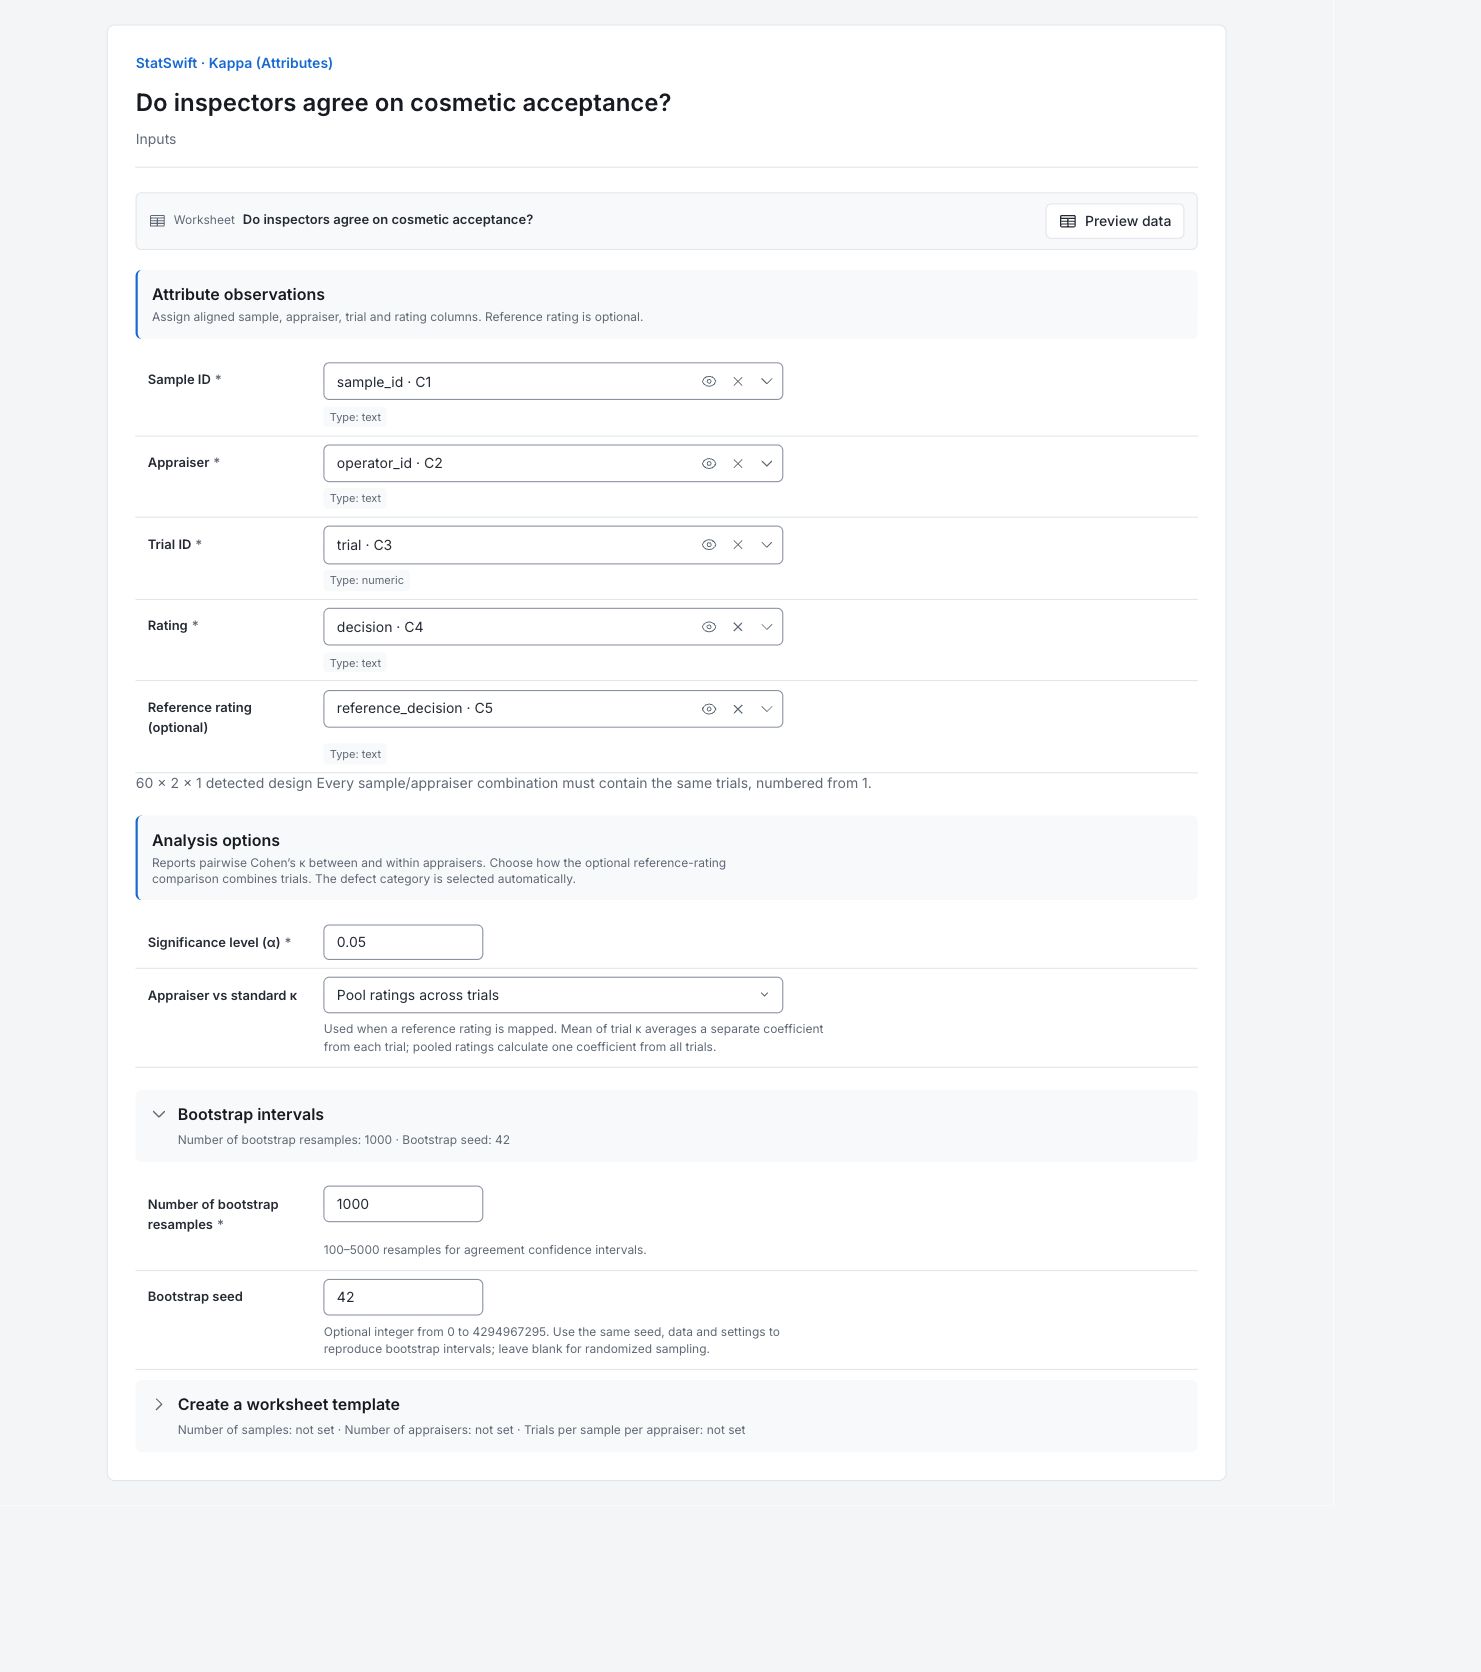
Em Inputs, associe sample_id a Sample ID, operator_id a Appraiser, trial a Trial ID, decision a Rating e reference_decision a Reference rating (optional), selecionando cada um no seletor de colunas.
Verifique se a aplicação deteta 60 × 2 × 1: 60 carcaças, dois inspetores e um ensaio.
4. Defina as opções do estudo
Introduza 0.05 em Significance level (α). Em Appraiser vs standard κ, escolha Pool ratings across trials.
Abra Bootstrap intervals. Introduza 1000 em Number of bootstrap resamples e 42 em Bootstrap seed. Utilize a mesma ordem dos dados e a mesma semente para reproduzir os intervalos. Não necessita de Create a worksheet template para este estudo importado. A reamostragem bootstrap amostra repetidamente as carcaças do estudo com reposição para estimar a incerteza dos intervalos. A semente fixa essa sequência de amostragem para permitir reproduzir os intervalos; não os torna mais exatos.
5. Execute a análise
Escolha Run analysis e abra Results.
6. Interpretar resultados
Compare os inspetores
Os inspetores concordam em 48 de 60 carcaças, ou 80%. O mapa de calor apresenta κ de Cohen = 0.5946, que ajusta a concordância para o que os totais das suas classificações produziriam por acaso. O intervalo de 95% é cerca de 0.3667–0.7966. κ não é uma percentagem de classificações corretas.
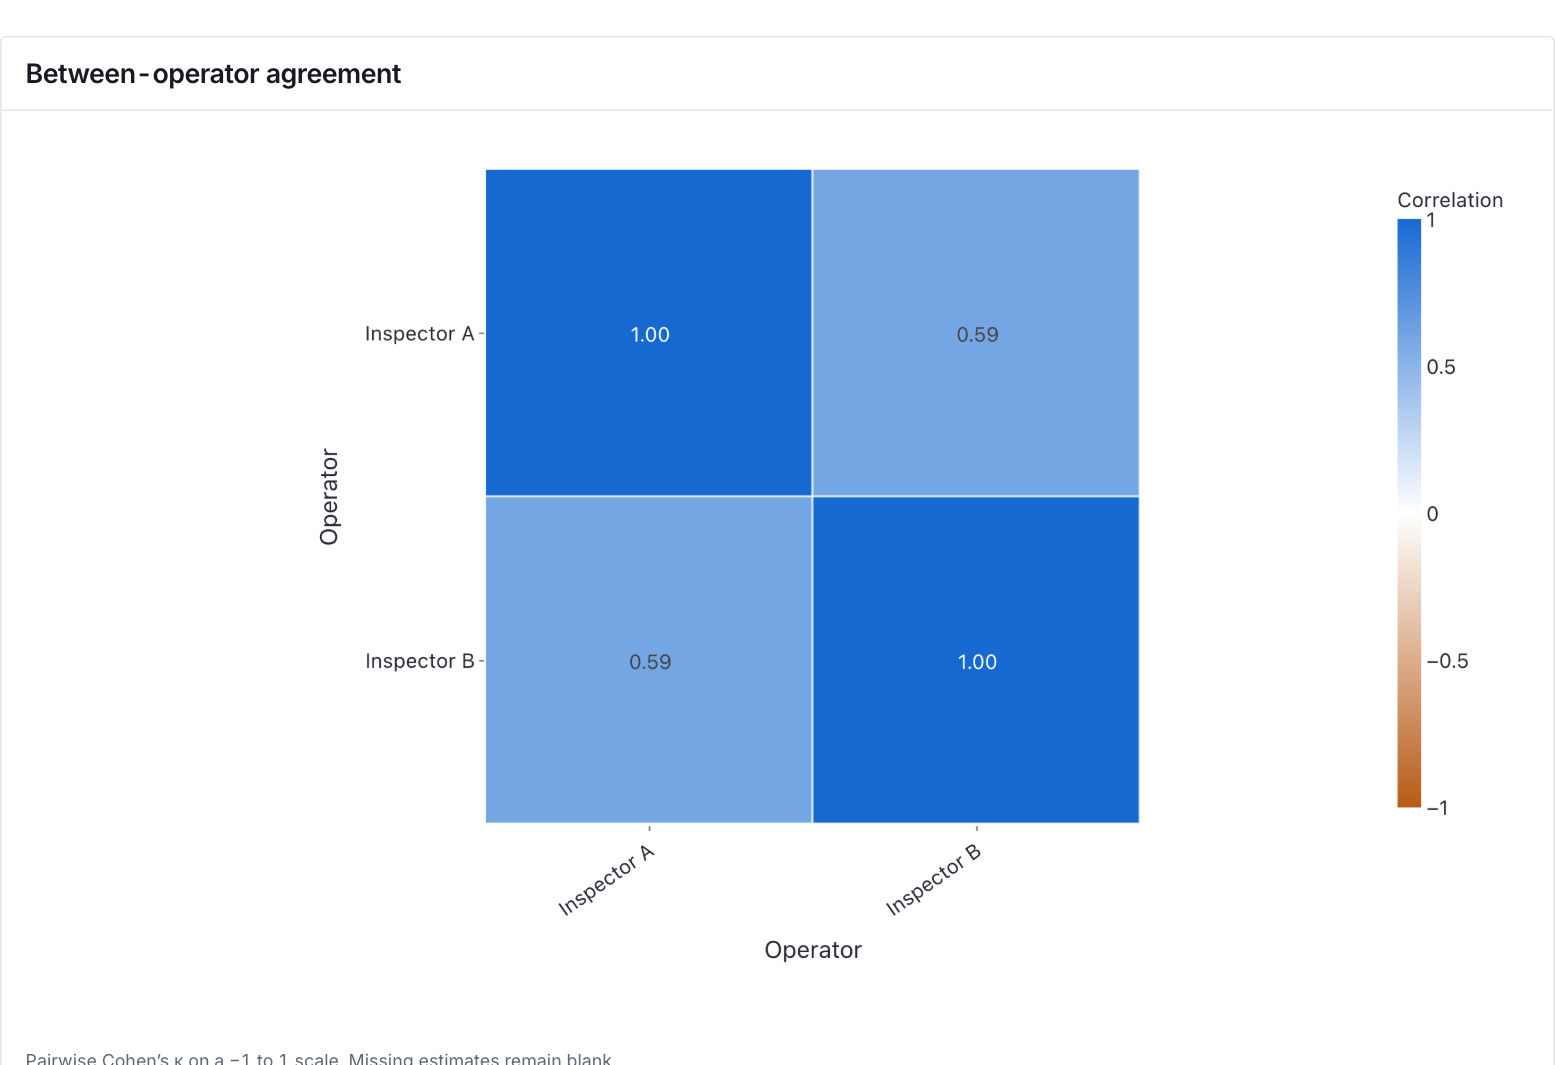
κ de Cohen entre os dois inspetores. É concordância ajustada ao acaso, não uma percentagem de classificações corretas. Ver gráfico no tamanho original (abre num novo separador) Compare com a referência
Ambos os inspetores coincidem com 52 de 60 decisões de referência. O inspetor A não deteta quatro rejeições de referência e rejeita quatro aceitações de referência. O inspetor B não deteta duas rejeições de referência e rejeita seis aceitações de referência. A mesma taxa global de coincidência oculta tipos de erro diferentes.
Leia as tabelas de erros
A seta lê-se decisão do inspetor → decisão de referência. Accept→Reject é uma rejeição de referência não detetada; Reject→Accept é um falso alarme. As taxas de não deteção utilizam as 24 rejeições de referência. As taxas de falso alarme utilizam as 36 aceitações de referência.
Tenha presente o plano do estudo
O estudo contém 60% de aceitações de referência e 40% de rejeições de referência. Esta composição afeta κ e não é a taxa de rejeição da produção. Cada inspetor classifica cada carcaça uma vez, pelo que o estudo não permite verificar se um inspetor repete a mesma decisão de forma fiável.
Decida o que rever
Reveja as carcaças em que houve discordância face aos critérios escritos de inspeção. Considere separadamente as rejeições não detetadas e os falsos alarmes. Repita o estudo com outro ensaio se necessitar de avaliar a consistência dentro de cada inspetor.
Mais detalhes: leia cada secção de resultados
As tabelas completas de resultados usam seis algarismos significativos, como na Ajuda.
Entre operadores (κ entre pares)
Os inspetores concordam em 48 de 60 carcaças (80%). A concordância esperada a partir das margens das suas categorias é 50.67%, dando κ de Cohen = 0.5946. O intervalo bootstrap de 95% com semente é cerca de 0.3667–0.7966. κ não é uma percentagem de classificações corretas, e a concordância entre inspetores não estabelece que as decisões estejam corretas face à referência.
| Primeiro observador / ensaio | Segundo observador / ensaio | Comparações | Concordância observada P₀ | Concordância esperada Pₑ | κ | Intervalo de confiança de 95% — inferior | Intervalo de confiança de 95% — superior |
|---|---|---|---|---|---|---|---|
| Inspector A | Inspector B | 60 | 0.8 | 0.506667 | 0.594595 | 0.366667 | 0.79661 |
Operador face à referência (exatidão)
Ambos os inspetores coincidem com 52 de 60 decisões de referência (86.67%). Os seus valores κ diferem ligeiramente: 0.7222 para A e 0.7297 para B, porque as margens das suas categorias diferem. Reject é tratado como a categoria de defeito. As taxas de não deteção são 16.67% para A e 8.33% para B; as taxas de falso alarme são 11.11% e 16.67%, respetivamente. Estas taxas utilizam denominadores distintos, correspondentes às diferentes categorias de referência.
κ face à referência utiliza um coeficiente de Cohen a partir das classificações agregadas dos ensaios. As concordâncias observada e esperada são proporções agregadas. As taxas de eficiência, não deteção e falso alarme são proporções (0–1).
| Operador | Comparações | Concordância observada P₀ | Concordância esperada Pₑ | κ | Intervalo de confiança de 95% — inferior | Intervalo de confiança de 95% — superior | Eficiência (todos) | Eficiência (qualquer) | Taxa de não deteção | Taxa de falso alarme |
|---|---|---|---|---|---|---|---|---|---|---|
| Inspector A | 60 | 0.866667 | 0.52 | 0.722222 | 0.507042 | 0.893365 | 0.866667 | — | 0.166667 | 0.111111 |
| Inspector B | 60 | 0.866667 | 0.506667 | 0.72973 | 0.533333 | 0.897727 | 0.866667 | — | 0.0833333 | 0.166667 |
Contagens de confusão — Inspetor A face à referência
A seta lê-se decisão do inspetor → decisão de referência. Accept→Reject representa quatro rejeições não detetadas entre 24 rejeições de referência. Reject→Accept representa quatro falsos alarmes entre 36 aceitações de referência. As restantes 52 decisões coincidem com a referência.
| Decisão → referência | Contagem |
|---|---|
| Accept→Accept | 32 |
| Accept→Reject | 4 |
| Reject→Accept | 4 |
| Reject→Reject | 20 |
Contagens de confusão — Inspetor B face à referência
O inspetor B não deteta duas das 24 rejeições de referência e rejeita falsamente seis das 36 aceitações de referência. O mesmo total de concordância do inspetor A oculta, assim, um equilíbrio diferente dos tipos de erro.
| Decisão → referência | Contagem |
|---|---|
| Accept→Accept | 30 |
| Accept→Reject | 2 |
| Reject→Accept | 6 |
| Reject→Reject | 22 |
Prevalência das categorias
A composição de referência é 60% Accept e 40% Reject: 36 e 24 carcaças. É a composição do estudo, não uma estimativa da taxa de rejeição da produção. A prevalência das categorias afeta a concordância ajustada ao acaso, pelo que deve comparar valores κ apenas com o contexto adequado.
| Categoria | Proporção |
|---|---|
| Accept | 0.6 |
| Reject | 0.4 |
Kappa — resumo do estudo
Existem 60 amostras, dois inspetores e nenhuma comparação excluída. Cada inspetor classifica cada amostra uma vez, pelo que não é possível avaliar a repetibilidade dentro de cada inspetor. A semente 42 com 1,000 reamostragens reproduz estes intervalos bootstrap para os mesmos dados, definições e versão do cálculo. Deixe a semente em branco para amostragem aleatorizada.
| Estatística | Valor |
|---|---|
| Peças | 60 |
| Operadores | Inspector A, Inspector B |
| Categorias | Accept, Reject |
| Método entre/dentro dos avaliadores | κ de Cohen |
| Método das repetições face ao padrão | Classificações agregadas |
| Comparações excluídas | 0 |
| Semente do bootstrap | 42 |
Contagens de contingência — Inspetor A / Inspetor B
As contagens de contingência comparam diretamente o inspetor A com o inspetor B. Explicam a sua concordância observada; utilize as tabelas de confusão face à referência para avaliar as rejeições não detetadas e os falsos alarmes.
| Primeira categoria | Segunda categoria | Contagem |
|---|---|---|
| Accept | Accept | 28 |
| Accept | Reject | 8 |
| Reject | Accept | 4 |
| Reject | Reject | 20 |
7. Criar um relatório
Conserve Between operators (pairwise κ), Operator vs standard (accuracy), ambas as tabelas de contagens de confusão face à referência, Category prevalence, Kappa — study summary, as contagens de contingência entre inspetores e o mapa de calor da concordância. Registe que cada inspetor classificou cada carcaça uma vez.
Selecione Add to report da execução concluída. Abra Choose individual items and advanced options para selecionar tabelas e gráficos e, em seguida, selecione Add to draft. Os elementos ocultos permanecem na análise guardada.
Dê um nome ao relatório e acrescente o objetivo do estudo e a sua interpretação. Selecione Save, reveja Preview e, em seguida, use Export → Download HTML. O exemplo abaixo contém todo o conteúdo selecionado, incluindo resultados que não cabem num único ecrã.