

ऐप के कमांड, वर्कशीट के पहचानकर्ता और उदाहरण डेटा के मान अपने मूल रूप में हैं। स्क्रीनशॉट, चार्ट और डाउनलोड अंग्रेज़ी में हैं। वैज्ञानिक उदाहरणों में मूल दशमलव बिंदु और हज़ारों के लिए अल्पविराम सुरक्षित हैं; वेबसाइट की कीमतें और गिनती स्थानीय स्वरूप में दिखाई जाती हैं।
उदाहरण: बाहरी रूप का निरीक्षण
दो निरीक्षक उन्हीं 60 पेंट किए गए आवरणों को Accept या Reject वर्ग देते हैं। गुणवत्ता पैनल का संदर्भ निर्णय उनसे छिपा है। अध्ययन में स्पष्ट और सीमारेखा के मामले शामिल हैं तथा कुल 120 रेटिंग हैं।
बाहरी रूप के निरीक्षण का उदाहरण डाउनलोड करें (CSV)यह Help में इस्तेमाल किया गया वही उदाहरण है। sample_id आवरण की पहचान करता है, operator_id निरीक्षक की, trial का मान 1 है, decision में निरीक्षक की रेटिंग और reference_decision में पैनल की संदर्भ रेटिंग है।
1. विश्लेषण बनाएँ
साइडबार में Measurement systems खोलें, Kappa (Attributes) चुनें और विश्लेषण को नाम दें। New blank worksheet और Create analysis चुनें।
2. डेटा आयात करें
Worksheet में Import चुनें। डाउनलोड की गई फ़ाइल चुनें या उसकी सामग्री चिपकाएँ। विभाजक Comma रखें, Decimal dot इस्तेमाल करें और First row contains column names चुनें। आयात का पूर्वावलोकन देखें, फिर Import into worksheet चुनें। हर पंक्ति उसके मूल क्रम में रखें।
3. इनपुट कॉलम चुनें
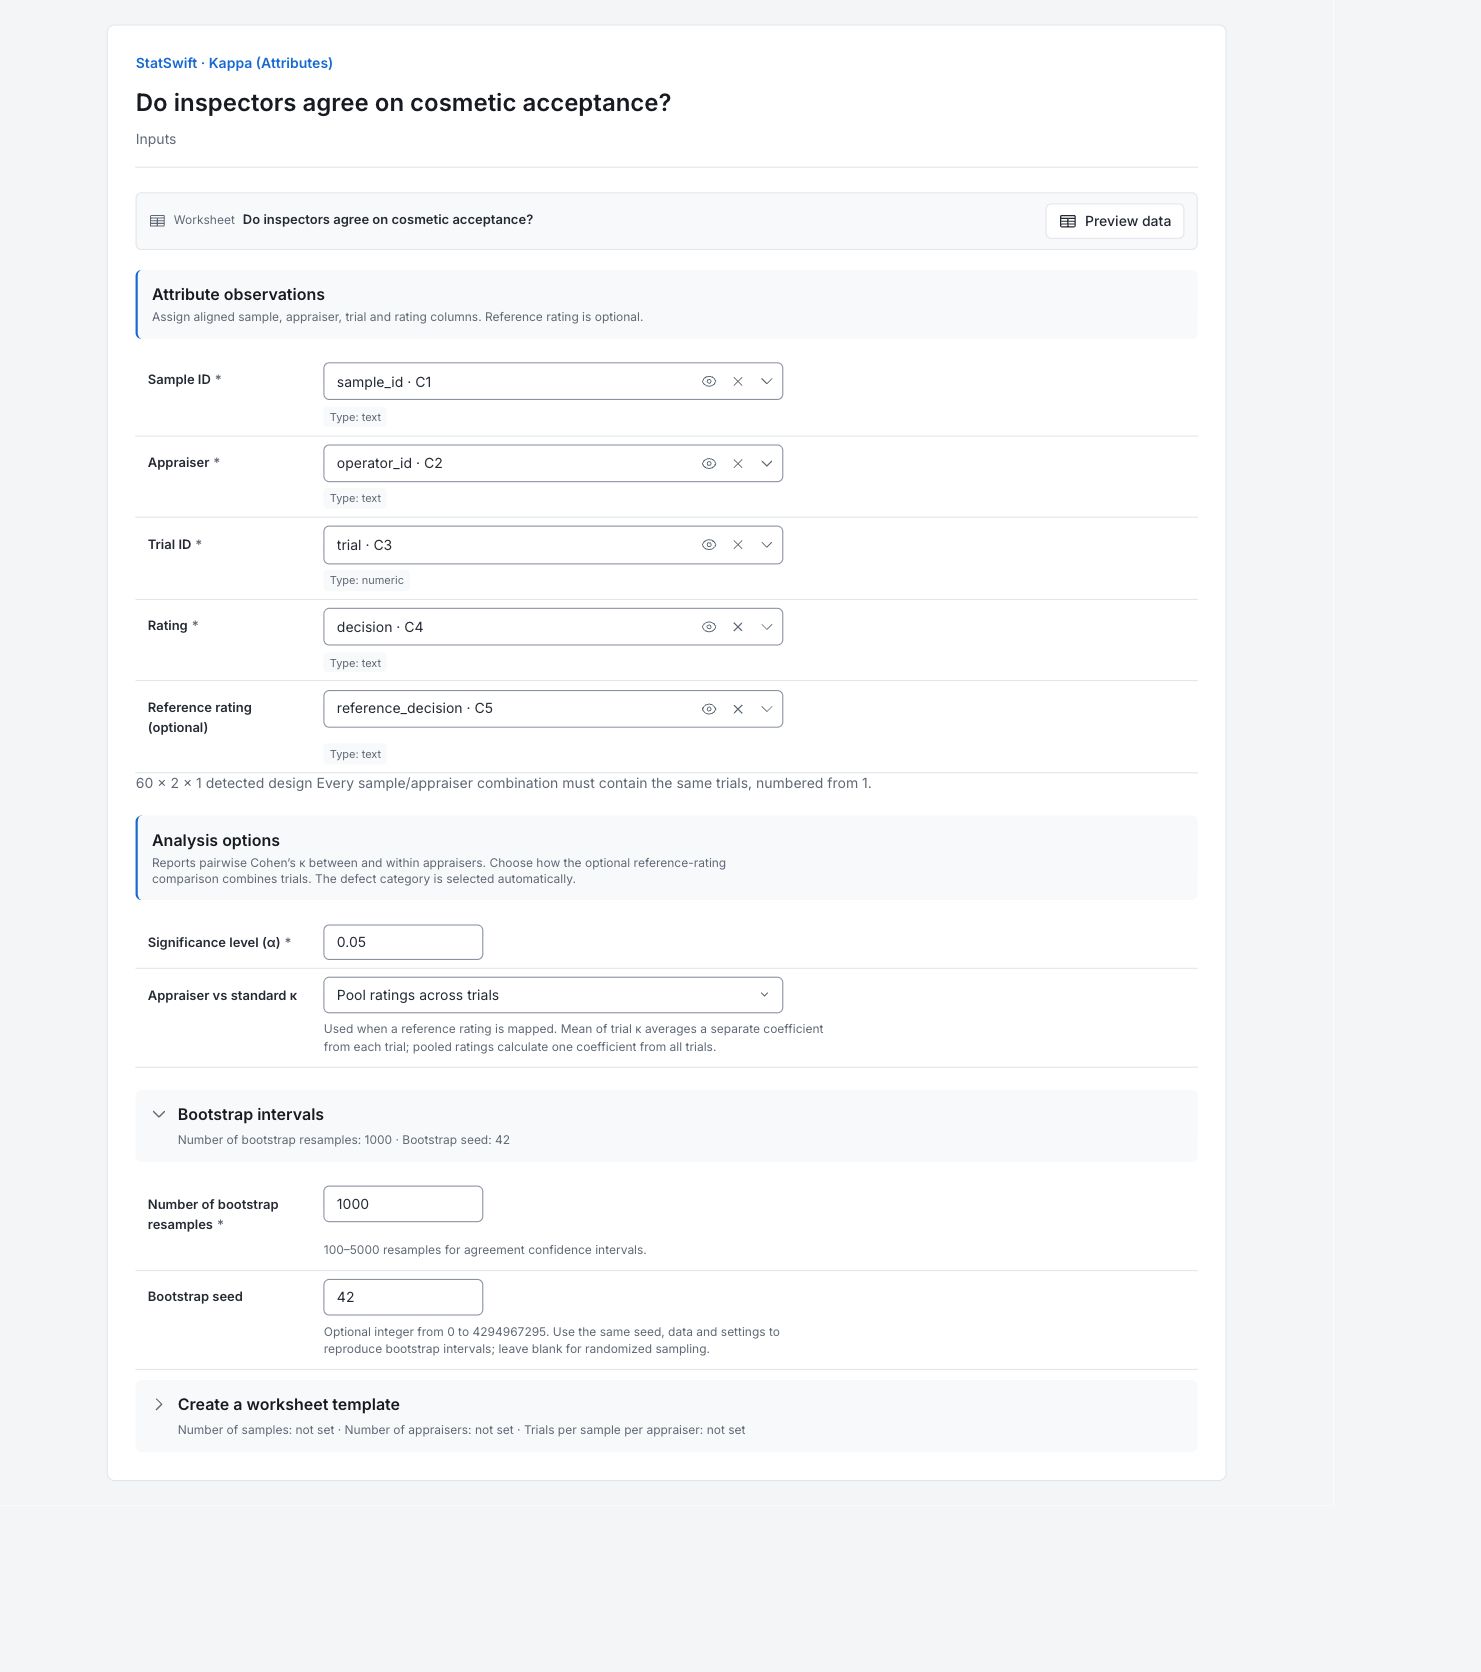
Inputs में कॉलम चयनकर्ता से sample_id को Sample ID, operator_id को Appraiser, trial को Trial ID, decision को Rating और reference_decision को Reference rating (optional) से जोड़ें।
जाँचें कि ऐप 60 × 2 × 1 पहचानता है: 60 आवरण, दो निरीक्षक और एक ट्रायल।
4. अध्ययन के विकल्प सेट करें
Significance level (α) में 0.05 दर्ज करें। Appraiser vs standard κ में Pool ratings across trials चुनें।
Bootstrap intervals खोलें। Number of bootstrap resamples में 1000 और Bootstrap seed में 42 दर्ज करें। अंतराल फिर पाने के लिए वही डेटा क्रम और सीड इस्तेमाल करें। इस आयातित अध्ययन के लिए Create a worksheet template आवश्यक नहीं है। बूटस्ट्रैप पुनर्नमूनाकरण अंतराल की अनिश्चितता आँकने के लिए अध्ययन के आवरणों को प्रतिस्थापन सहित बार-बार नमूने में चुनता है। सीड नमूना चयन का क्रम तय करता है ताकि अंतराल फिर पाए जा सकें; वह उन्हें अधिक सटीक नहीं बनाता है।
5. विश्लेषण चलाएँ
Run analysis चुनें, फिर Results खोलें।
6। परिणामों की व्याख्या करें
निरीक्षकों की तुलना करें
निरीक्षक 60 में से 48 आवरणों, यानी 80% पर सहमत हैं। हीटमैप Cohen का κ = 0.5946 दिखाता है, जो उनकी कुल श्रेणीगत रेटिंग से संयोगवश होने वाली सहमति के लिए समायोजन करता है। 95% अंतराल लगभग 0.3667–0.7966 है। κ सटीकता का प्रतिशत नहीं है।
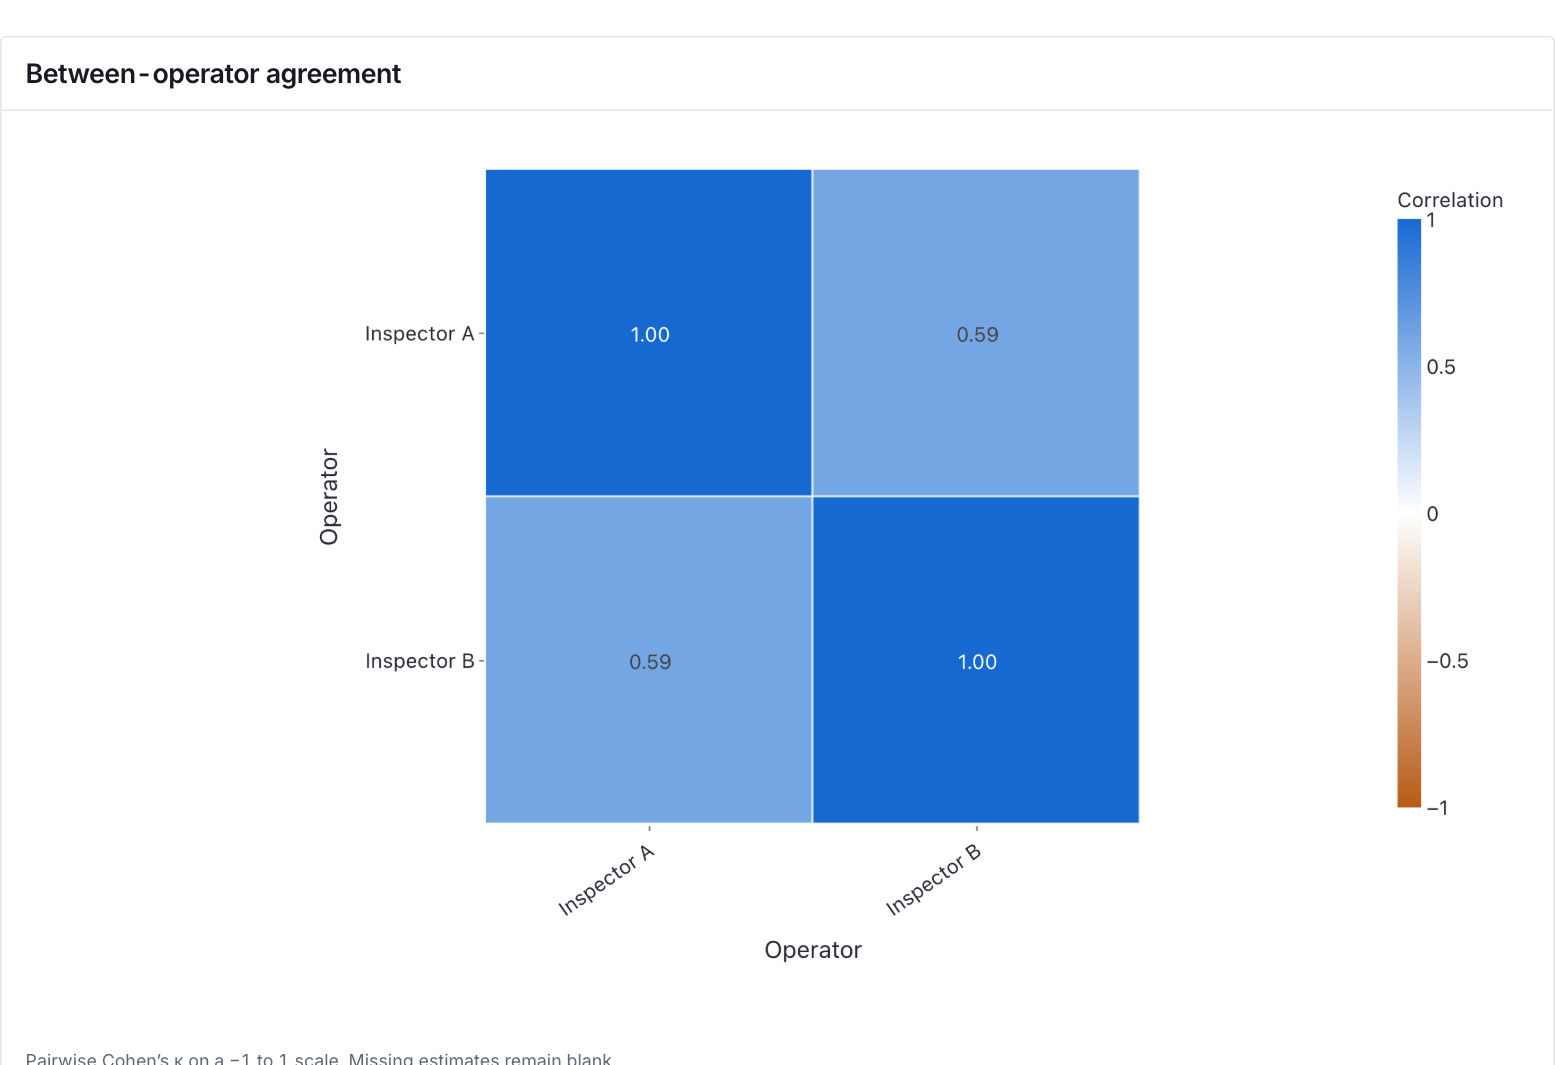
दो निरीक्षकों के बीच Cohen का κ। यह संयोग के लिए समायोजित सहमति है, सटीकता का प्रतिशत नहीं। पूरे आकार का चार्ट देखें (नए टैब में खुलेगा) संदर्भ से तुलना करें
दोनों निरीक्षक 60 में से 52 संदर्भ निर्णयों से मेल खाते हैं। निरीक्षक A चार संदर्भ अस्वीकृतियाँ चूकता है और चार संदर्भ स्वीकृतियाँ अस्वीकार करता है। निरीक्षक B दो संदर्भ अस्वीकृतियाँ चूकता है और छह संदर्भ स्वीकृतियाँ अस्वीकार करता है। समान कुल मिलान दर अलग त्रुटि प्रकार छिपाती है।
त्रुटि तालिकाएँ पढ़ें
तीर का अर्थ निरीक्षक का निर्णय → संदर्भ निर्णय है। Accept→Reject छूटी हुई अस्वीकृति है; Reject→Accept गलत चेतावनी है। चूक की दरें 24 संदर्भ अस्वीकृतियों को हर बनाती हैं। गलत चेतावनी की दरें 36 संदर्भ स्वीकृतियों को हर बनाती हैं।
अध्ययन योजना ध्यान में रखें
अध्ययन में 60% संदर्भ स्वीकृतियाँ और 40% संदर्भ अस्वीकृतियाँ हैं। यह मिश्रण κ को प्रभावित करता है और उत्पादन की अस्वीकृति दर नहीं है। हर निरीक्षक हर आवरण को एक बार रेटिंग देता है, इसलिए अध्ययन नहीं जाँच सकता कि निरीक्षक भरोसेमंद ढंग से वही निर्णय दोहराता है या नहीं।
तय करें कि किसकी समीक्षा करनी है
विवादित आवरणों को लिखित निरीक्षण मानदंडों के सापेक्ष पढ़ें। छूटी अस्वीकृतियों और गलत चेतावनियों पर अलग-अलग विचार करें। हर निरीक्षक के भीतर की सुसंगतता आँकनी हो तो दूसरे ट्रायल के साथ अध्ययन दोहराएँ।
और जानकारी: परिणाम का हर खंड पढ़ें
परिणामों की पूरी तालिकाओं में Help की तरह छह सार्थक अंक हैं।
ऑपरेटरों के बीच (जोड़ीवार κ)
निरीक्षक 60 में से 48 आवरणों (80%) पर सहमत हैं। उनकी श्रेणीगत सीमांत गिनतियों से अपेक्षित सहमति 50.67% है, जिससे Cohen का κ = 0.5946 मिलता है। सीड वाला 95% बूटस्ट्रैप अंतराल लगभग 0.3667–0.7966 है। κ सटीकता का प्रतिशत नहीं है और निरीक्षकों की आपसी सहमति संदर्भ के सापेक्ष सही होना स्थापित नहीं करती है।
| पहला प्रेक्षक / ट्रायल | दूसरा प्रेक्षक / ट्रायल | तुलनाएँ | प्रेक्षित सहमति P₀ | अपेक्षित सहमति Pₑ | κ | 95% विश्वास अंतराल — निचली सीमा | 95% विश्वास अंतराल — ऊपरी सीमा |
|---|---|---|---|---|---|---|---|
| Inspector A | Inspector B | 60 | 0.8 | 0.506667 | 0.594595 | 0.366667 | 0.79661 |
ऑपरेटर बनाम मानक (सटीकता)
दोनों निरीक्षक 60 में से 52 संदर्भ निर्णयों (86.67%) से मेल खाते हैं। उनके κ थोड़े अलग हैं: A के लिए 0.7222 और B के लिए 0.7297, क्योंकि उनकी श्रेणीगत सीमांत गिनतियाँ अलग हैं। Reject को दोष श्रेणी माना जाता है। चूक की दर A के लिए 16.67% और B के लिए 8.33% है; गलत चेतावनी की दरें क्रमशः 11.11% और 16.67% हैं। ये दरें अलग-अलग संदर्भ श्रेणियों की गिनतियों से भाग देकर निकलती हैं।
मानक के सापेक्ष κ, ट्रायल की एकत्रित रेटिंग से एक Cohen गुणांक इस्तेमाल करता है। प्रेक्षित और अपेक्षित सहमति एकत्रित अनुपात हैं। दक्षता, चूक और गलत चेतावनी की दरें अनुपात (0–1) हैं।
| ऑपरेटर | तुलनाएँ | प्रेक्षित सहमति P₀ | अपेक्षित सहमति Pₑ | κ | 95% विश्वास अंतराल — निचली सीमा | 95% विश्वास अंतराल — ऊपरी सीमा | दक्षता (सभी) | दक्षता (कोई भी) | चूक की दर | गलत चेतावनी की दर |
|---|---|---|---|---|---|---|---|---|---|---|
| Inspector A | 60 | 0.866667 | 0.52 | 0.722222 | 0.507042 | 0.893365 | 0.866667 | — | 0.166667 | 0.111111 |
| Inspector B | 60 | 0.866667 | 0.506667 | 0.72973 | 0.533333 | 0.897727 | 0.866667 | — | 0.0833333 | 0.166667 |
भ्रम गिनतियाँ — निरीक्षक A बनाम मानक
तीर का अर्थ निरीक्षक का निर्णय → संदर्भ निर्णय है। Accept→Reject, 24 संदर्भ अस्वीकृतियों में से चार छूटी अस्वीकृतियाँ दर्शाता है। Reject→Accept, 36 संदर्भ स्वीकृतियों में से चार गलत चेतावनियाँ दर्शाता है। बाकी 52 निर्णय संदर्भ से मेल खाते हैं।
| निर्णय → मानक | गिनती |
|---|---|
| Accept→Accept | 32 |
| Accept→Reject | 4 |
| Reject→Accept | 4 |
| Reject→Reject | 20 |
भ्रम गिनतियाँ — निरीक्षक B बनाम मानक
निरीक्षक B, 24 संदर्भ अस्वीकृतियों में से दो चूकता है और 36 संदर्भ स्वीकृतियों में से छह को गलत अस्वीकार करता है। इसलिए निरीक्षक A के समान कुल सहमति त्रुटि प्रकारों का अलग संतुलन छिपाती है।
| निर्णय → मानक | गिनती |
|---|---|
| Accept→Accept | 30 |
| Accept→Reject | 2 |
| Reject→Accept | 6 |
| Reject→Reject | 22 |
श्रेणियों की व्यापकता
संदर्भ मिश्रण 60% Accept और 40% Reject है: 36 और 24 आवरण। यह अध्ययन का मिश्रण है, उत्पादन की अस्वीकृति दर का अनुमान नहीं। श्रेणी व्यापकता संयोग-समायोजित सहमति को प्रभावित करती है, इसलिए κ मानों की तुलना उपयुक्त संदर्भ में ही करें।
| श्रेणी | अनुपात |
|---|---|
| Accept | 0.6 |
| Reject | 0.4 |
कप्पा — अध्ययन सारांश
60 नमूने, दो निरीक्षक हैं और कोई तुलना हटाई नहीं गई है। हर निरीक्षक हर नमूने को एक बार रेटिंग देता है, इसलिए निरीक्षक के भीतर पुनरावृत्तता नहीं आँकी जा सकती है। सीड 42 और 1,000 पुनर्नमूने समान डेटा, सेटिंग और गणना संस्करण के लिए ये बूटस्ट्रैप अंतराल फिर देते हैं। यादृच्छिक नमूना चयन के लिए सीड रिक्त रखें।
| सांख्यिक | मान |
|---|---|
| पार्ट | 60 |
| ऑपरेटर | Inspector A, Inspector B |
| श्रेणियाँ | Accept, Reject |
| बीच/भीतर की विधि | Cohen का κ |
| मानक से तुलना की ट्रायल विधि | एक साथ ली गई रेटिंग |
| हटाई गई तुलनाएँ | 0 |
| बूटस्ट्रैप बीज | 42 |
आकस्मिकता गिनतियाँ — निरीक्षक A / निरीक्षक B
आकस्मिकता गिनतियाँ निरीक्षक A और निरीक्षक B की सीधी तुलना करती हैं। वे उनकी प्रेक्षित सहमति समझाती हैं; छूटी अस्वीकृतियाँ और गलत चेतावनियाँ आँकने के लिए संदर्भ भ्रम तालिकाएँ इस्तेमाल करें।
| पहली श्रेणी | दूसरी श्रेणी | गिनती |
|---|---|---|
| Accept | Accept | 28 |
| Accept | Reject | 8 |
| Reject | Accept | 4 |
| Reject | Reject | 20 |
7। रिपोर्ट बनाएँ
Between operators (pairwise κ), Operator vs standard (accuracy), दोनों संदर्भ भ्रम-गिनती तालिकाएँ, Category prevalence, Kappa — study summary, निरीक्षकों के बीच की आकस्मिकता गिनतियाँ और सहमति हीटमैप रखें। दर्ज करें कि हर निरीक्षक ने हर आवरण को एक बार रेटिंग दी।
चुनें: Add to report पूरे हो चुके विश्लेषण से। खोलें: Choose individual items and advanced options —तालिकाएँ और चार्ट चुनने के लिए; फिर चुनें: Add to draft। छिपाए गए आइटम सहेजे गए विश्लेषण में बने रहते हैं।
रिपोर्ट को नाम दें और अध्ययन का उद्देश्य तथा अपनी व्याख्या जोड़ें। चुनें: Save, फिर देखें: Preview, और फिर इस्तेमाल करें: Export → Download HTML। नीचे दिए गए उदाहरण में चुनी गई पूरी सामग्री है, जिसमें एक स्क्रीन से आगे के परिणाम भी शामिल हैं।