

Les commandes de l’application, les identifiants des feuilles de données et les valeurs des données d’exemple conservent leur forme d’origine. Les captures d’écran, graphiques et fichiers à télécharger sont en anglais. Les exemples conservent les conventions numériques anglaises : point décimal et virgule de séparation des milliers.
Exemple : inspection esthétique
Deux inspecteurs classent chacun les mêmes 60 boîtiers peints en Accept ou Reject. La décision de référence d’un comité qualité leur est cachée. L’étude comprend des cas nets et des cas limites, avec 120 décisions au total.
Télécharger l’exemple d’inspection esthétique (CSV)C’est le même exemple que dans Help. sample_id identifie le boîtier, operator_id l’inspecteur, trial vaut 1, decision contient la décision de l’inspecteur et reference_decision celle du comité de référence.
1. Créer l’analyse
Dans la barre latérale, ouvrez Measurement systems, choisissez Kappa (Attributes) et nommez l’analyse. Sélectionnez New blank worksheet et Create analysis.
2. Importer les données
Dans Worksheet, choisissez Import. Sélectionnez le fichier téléchargé ou collez son contenu. Réglez le délimiteur sur Comma, utilisez Decimal dot et cochez First row contains column names. Prévisualisez l’importation, puis choisissez Import into worksheet. Conservez chaque ligne dans son ordre d’origine.
3. Affecter les colonnes d’entrée
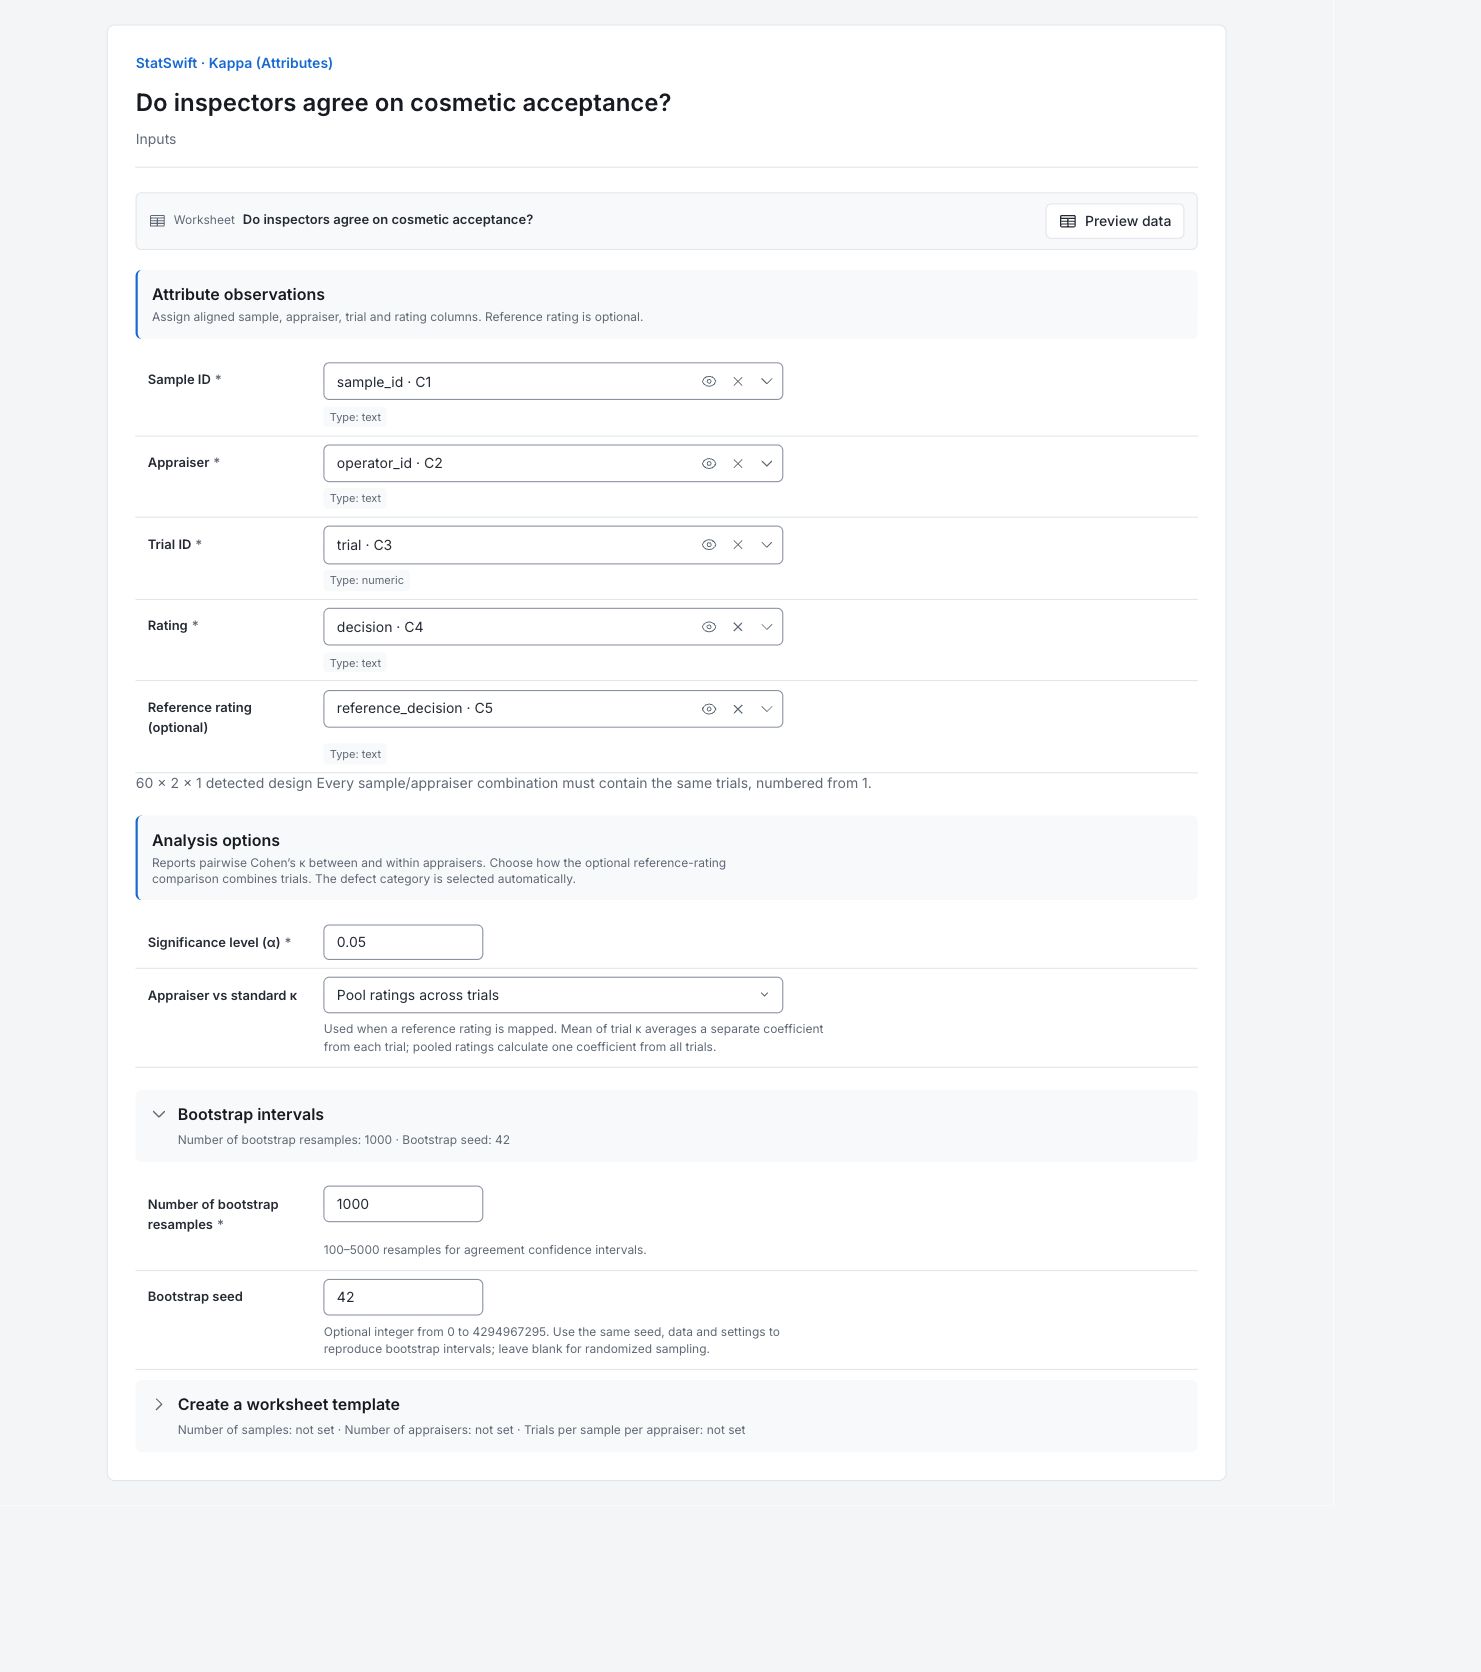
Dans Inputs, affectez sample_id à Sample ID, operator_id à Appraiser, trial à Trial ID, decision à Rating et reference_decision à Reference rating (optional), en les sélectionnant dans chaque sélecteur de colonne.
Vérifiez que l’application détecte 60 × 2 × 1 : 60 boîtiers, deux inspecteurs et un essai.
4. Définir les options de l’étude
Saisissez 0.05 dans Significance level (α). Dans Appraiser vs standard κ, choisissez Pool ratings across trials.
Ouvrez Bootstrap intervals. Saisissez 1000 dans Number of bootstrap resamples et 42 dans Bootstrap seed. Utilisez le même ordre des données et la même graine pour reproduire les intervalles. Create a worksheet template n’est pas nécessaire pour cette étude importée. Le rééchantillonnage bootstrap tire à répétition les boîtiers de l’étude avec remise pour estimer l’incertitude des intervalles. La graine fixe cette séquence de tirages afin de reproduire les intervalles ; elle ne les rend pas plus exacts.
5. Exécuter l’analyse
Choisissez Run analysis, puis ouvrez Results.
6. Interpréter les résultats
Comparer les inspecteurs
Les inspecteurs s’accordent sur 48 des 60 boîtiers, soit 80%. La carte de chaleur montre le κ de Cohen = 0.5946, qui ajuste l’accord pour ce que leurs totaux de catégories produiraient par hasard. L’intervalle à 95% est d’environ 0.3667–0.7966. κ n’est pas un pourcentage d’exactitude.
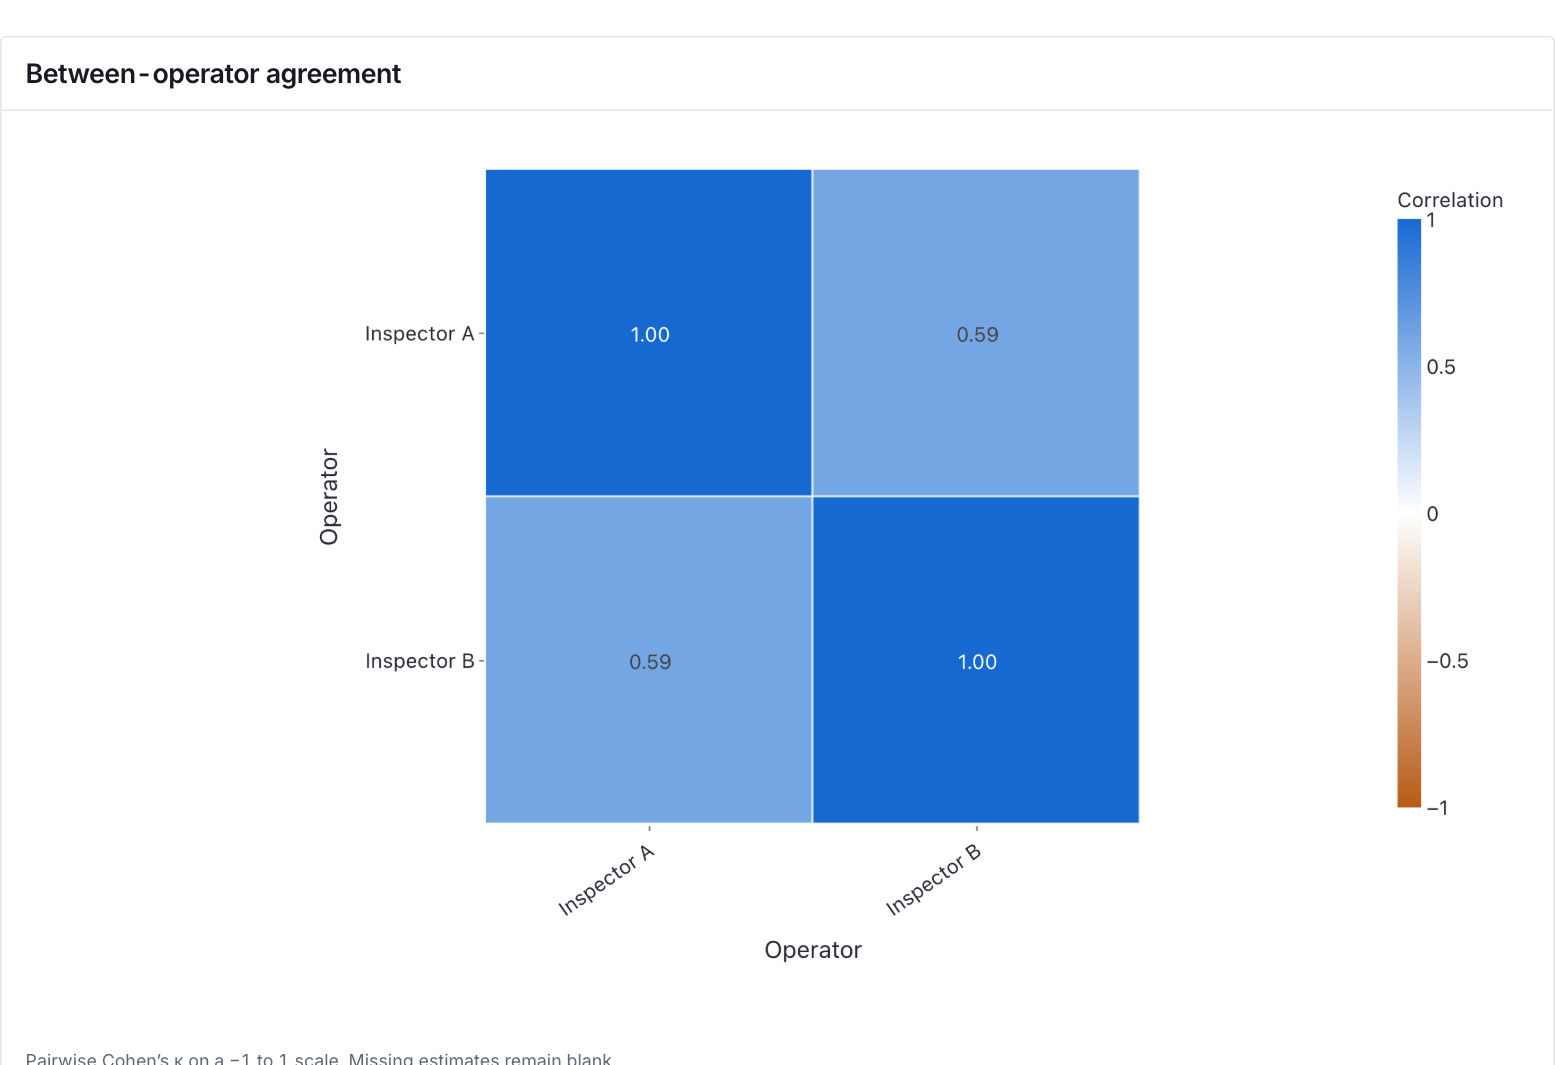
κ de Cohen entre les deux inspecteurs. C’est un accord ajusté pour le hasard, et non un pourcentage d’exactitude. Voir le graphique en taille réelle (s’ouvre dans un nouvel onglet) Comparer à la référence
Les deux inspecteurs concordent avec 52 des 60 décisions de référence. L’inspecteur A manque quatre rejets de référence et rejette quatre acceptations de référence. L’inspecteur B manque deux rejets de référence et rejette six acceptations de référence. Un même taux global de concordance masque des types d’erreurs différents.
Lire les tableaux d’erreurs
La flèche se lit décision de l’inspecteur → décision de référence. Accept→Reject est un rejet non détecté ; Reject→Accept est une fausse alerte. Les taux de non-détection utilisent les 24 rejets de référence. Les taux de fausse alerte utilisent les 36 acceptations de référence.
Garder à l’esprit le plan de l’étude
L’étude contient 60% d’acceptations de référence et 40% de rejets de référence. Cette composition affecte κ et n’est pas le taux de rejet de production. Chaque inspecteur classe chaque boîtier une seule fois ; l’étude ne peut donc pas vérifier si un inspecteur répète fidèlement la même décision.
Décider des éléments à réexaminer
Examinez les boîtiers faisant l’objet d’un désaccord par rapport aux critères écrits d’inspection. Considérez séparément les rejets non détectés et les fausses alertes. Répétez l’étude avec un autre essai pour évaluer la constance de chaque inspecteur.
Plus de détails : lire chaque section des résultats
Les tableaux complets de résultats utilisent six chiffres significatifs, comme dans Help.
Entre opérateurs (κ par paire)
Les inspecteurs s’accordent sur 48 des 60 boîtiers (80%). L’accord attendu à partir des marges de leurs catégories est de 50.67%, donnant le κ de Cohen = 0.5946. L’intervalle bootstrap à 95% avec graine est d’environ 0.3667–0.7966. κ n’est pas un pourcentage d’exactitude, et l’accord entre inspecteurs n’établit pas la justesse par rapport à la référence.
| Premier observateur / essai | Second observateur / essai | Comparaisons | Accord observé P₀ | Accord attendu Pₑ | κ | Intervalle de confiance à 95% — borne inférieure | Intervalle de confiance à 95% — borne supérieure |
|---|---|---|---|---|---|---|---|
| Inspector A | Inspector B | 60 | 0.8 | 0.506667 | 0.594595 | 0.366667 | 0.79661 |
Opérateur par rapport à la référence (exactitude)
Les deux inspecteurs concordent avec 52 des 60 décisions de référence (86.67%). Leurs valeurs de κ diffèrent légèrement : 0.7222 pour A et 0.7297 pour B, car les marges de leurs catégories diffèrent. Reject est traité comme la catégorie défectueuse. Les taux de non-détection sont de 16.67% pour A et de 8.33% pour B ; les taux de fausse alerte sont de 11.11% et 16.67%, respectivement. Ces taux utilisent des dénominateurs de catégories de référence différents.
Le κ par rapport à la référence utilise un seul coefficient de Cohen à partir des décisions regroupées des essais. Les accords observé et attendu sont des proportions regroupées. Les taux d’efficacité, de non-détection et de fausse alerte sont des proportions (0–1).
| Opérateur | Comparaisons | Accord observé P₀ | Accord attendu Pₑ | κ | Intervalle de confiance à 95% — borne inférieure | Intervalle de confiance à 95% — borne supérieure | Efficacité (tous) | Efficacité (au moins un) | Taux de non-détection | Taux de fausse alerte |
|---|---|---|---|---|---|---|---|---|---|---|
| Inspector A | 60 | 0.866667 | 0.52 | 0.722222 | 0.507042 | 0.893365 | 0.866667 | — | 0.166667 | 0.111111 |
| Inspector B | 60 | 0.866667 | 0.506667 | 0.72973 | 0.533333 | 0.897727 | 0.866667 | — | 0.0833333 | 0.166667 |
Effectifs de confusion — Inspecteur A par rapport à la référence
La flèche se lit décision de l’inspecteur → décision de référence. Accept→Reject représente quatre rejets non détectés sur 24 rejets de référence. Reject→Accept représente quatre fausses alertes sur 36 acceptations de référence. Les 52 autres décisions concordent avec la référence.
| Décision → référence | Effectif |
|---|---|
| Accept→Accept | 32 |
| Accept→Reject | 4 |
| Reject→Accept | 4 |
| Reject→Reject | 20 |
Effectifs de confusion — Inspecteur B par rapport à la référence
L’inspecteur B manque deux des 24 rejets de référence et rejette à tort six des 36 acceptations de référence. Le même accord total que l’inspecteur A masque donc un équilibre différent entre les types d’erreurs.
| Décision → référence | Effectif |
|---|---|
| Accept→Accept | 30 |
| Accept→Reject | 2 |
| Reject→Accept | 6 |
| Reject→Reject | 22 |
Prévalence des catégories
La composition de référence est de 60% Accept et 40% Reject : 36 et 24 boîtiers. C’est la composition de l’étude, et non une estimation du taux de rejet de production. La prévalence des catégories affecte l’accord ajusté pour le hasard ; comparez donc les valeurs de κ uniquement avec un contexte approprié.
| Catégorie | Proportion |
|---|---|
| Accept | 0.6 |
| Reject | 0.4 |
Kappa — résumé de l’étude
Il y a 60 échantillons, deux inspecteurs et aucune comparaison écartée. Chaque inspecteur classe chaque échantillon une seule fois ; la répétabilité intra-inspecteur ne peut donc pas être évaluée. La graine 42 avec 1,000 rééchantillonnages reproduit ces intervalles bootstrap pour les mêmes données, réglages et version de calcul. Laissez la graine vide pour un tirage aléatoire.
| Statistique | Valeur |
|---|---|
| Pièces | 60 |
| Opérateurs | Inspector A, Inspector B |
| Catégories | Accept, Reject |
| Méthode inter-évaluateurs/intra-évaluateur | κ de Cohen |
| Méthode par essai pour la comparaison à la référence | Évaluations regroupées |
| Comparaisons exclues | 0 |
| Graine du bootstrap | 42 |
Effectifs de contingence — Inspecteur A / Inspecteur B
Les effectifs de contingence comparent directement l’inspecteur A et l’inspecteur B. Ils expliquent leur accord observé ; utilisez les tableaux de confusion avec la référence pour évaluer les rejets non détectés et les fausses alertes.
| Première catégorie | Seconde catégorie | Effectif |
|---|---|---|
| Accept | Accept | 28 |
| Accept | Reject | 8 |
| Reject | Accept | 4 |
| Reject | Reject | 20 |
7. Créer un rapport
Conservez Between operators (pairwise κ), Operator vs standard (accuracy), les deux tableaux d’effectifs de confusion avec la référence, Category prevalence, Kappa — study summary, les effectifs de contingence entre inspecteurs et la carte de chaleur d’accord. Notez que chaque inspecteur a classé chaque boîtier une seule fois.
Sélectionnez Add to report dans l’exécution terminée. Ouvrez Choose individual items and advanced options pour sélectionner les tableaux et graphiques, puis choisissez Add to draft. Les éléments masqués restent dans l’analyse enregistrée.
Nommez le rapport et ajoutez l’objectif de l’étude ainsi que votre interprétation. Sélectionnez Save, vérifiez Preview, puis utilisez Export → Download HTML. L’exemple ci-dessous contient l’intégralité du contenu sélectionné, y compris les résultats au-delà d’un seul écran.