

Nazwy poleceń aplikacji, identyfikatory kolumn i wartości danych przykładowych zachowano w oryginale. Zrzuty ekranu, wykresy i pliki do pobrania są w języku angielskim.
Przykład: czas pakowania według strefy
90 zamówień: po 30 z każdej z trzech stref pakowania; trzy pomiary liczbowe na zamówienie.
Pobierz przykładowe dane (CSV, angielskie nagłówki)To ten sam przykład, który znajduje się w Help. Zaimportuj CSV, aby wykonać kolejne kroki, lub użyj Open example in a practice copy w Help, aby wstępnie wypełnić dane wejściowe.
1. Utwórz obszar roboczy
Na pasku bocznym otwórz Basic Statistics i wybierz Display Descriptive Statistics. Utwórz analizę, nadaj jej nazwę, wybierz New blank worksheet, a następnie Create analysis.
2. Zaimportuj przykładowe dane
Pobierz powyższy plik CSV i zaimportuj go do arkusza. Wybierz Comma jako separator pól, Dot jako separator dziesiętny oraz First row contains column names.
3. Przypisz kolumny wejściowe
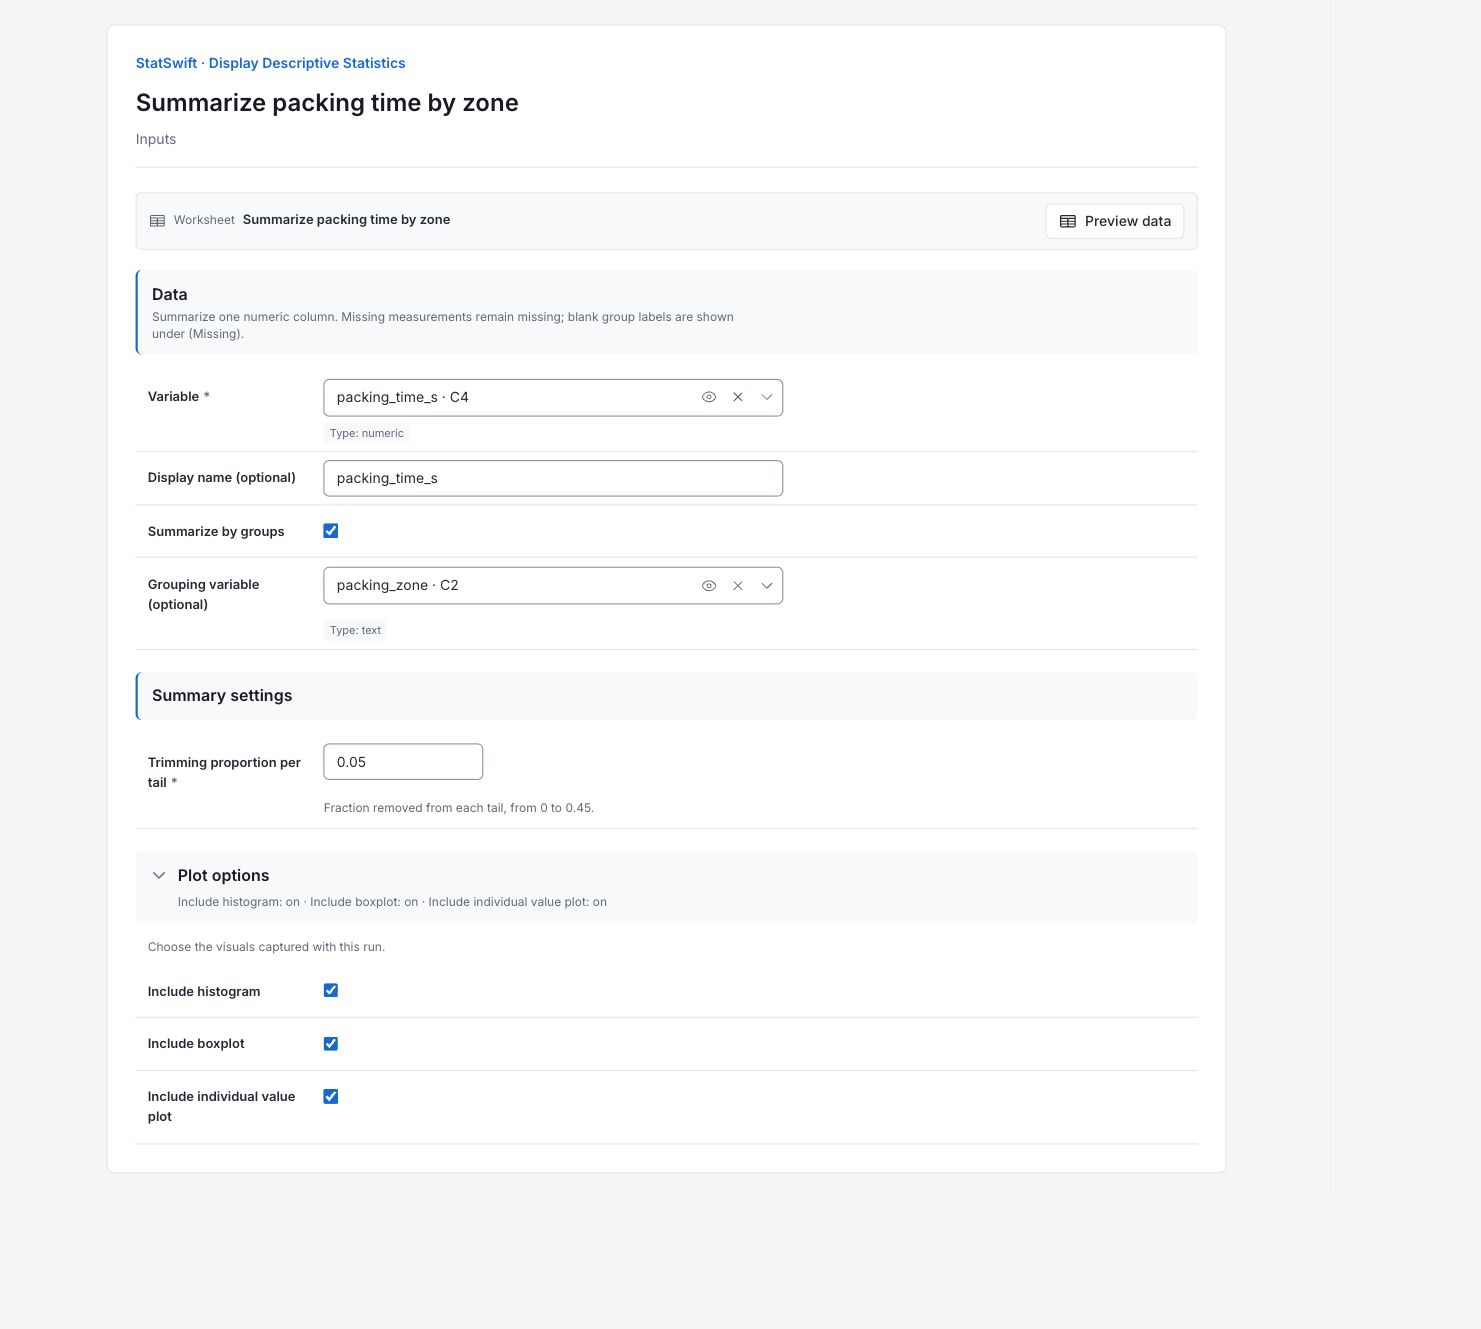
Na karcie Inputs otwórz Variable i wybierz packing_time_s. Wpisz packing_time_s w Display name (optional). Zaznacz Summarize by groups, a następnie przypisz packing_zone do Grouping variable (optional).
4. Ustaw podsumowania i wykresy
Wpisz 0.05 w Trimming proportion per tail. Oznacza to odcięcie 5% z każdego końca rozkładu. Otwórz Plot options i zaznacz Include histogram, Include boxplot oraz Include individual value plot.
5. Uruchom analizę
Wybierz Run analysis, a następnie otwórz Results.
6. Zinterpretuj wyniki
Sprawdź zakres podsumowania
Dane zawierają 90 zamówień: po 30 z każdej z trzech stref pakowania, bez brakujących pomiarów. Tabela grup rozdziela strefy. Wszystkie trzy wykresy łączą 90 zamówień.
Odczytaj miary położenia
Średnia ogólna wynosi 150.57 s, a mediana 152.90 s. Średnia to średnia arytmetyczna; mediana dzieli uporządkowane wartości na połowy.
Odczytaj rozrzut
Odchylenie standardowe wynosi 45.24 s. Opisuje zróżnicowanie zamówień, a nie niepewność średniej. Przed porównaniem stref odczytaj również rozstęp i kwartyle.
Porównaj strefy
Średnie dla stref wynoszą:
Mixed_orders147.40 s,Accessories163.90 s iSmall_parts140.42 s. Każda obejmuje 30 zamówień. Średnia łączna obejmuje te różne struktury zamówień.Odczytaj histogram
Każdy słupek zlicza zamówienia w przedziale wartości. Odczytaj oś poziomą w jednostce pomiaru i oceń ogólny kształt oraz rozrzut. Są to zaobserwowane liczebności; nie podają prawdopodobieństwa dla przyszłego zamówienia.

Czas pakowania (sekundy) dla wszystkich 90 zamówień; trzy strefy pakowania połączono. Wykres pozostaje w języku angielskim. Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Odczytaj wykres pudełkowy
Pudełko obejmuje środkową połowę pomiarów, a linia oznacza medianę. Zaobserwowane wartości mieszczą się w zakresie 59.90–252.50 s; żadna nie przekracza granic 1.5 × IQR. Granice opisują tę próbę, a nie wymagania akceptacji klienta.

Czas pakowania (sekundy) dla wszystkich 90 zamówień; trzy strefy pakowania połączono. Wykres pozostaje w języku angielskim. Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Obejrzyj poszczególne wartości
Każdy punkt przedstawia jedno zamówienie. Wartości są uporządkowane wzdłuż osi pomiaru; odstępy pionowe je rozdzielają. Wykres nie pokazuje kolejności zbierania danych ani oddzielnych rozkładów stref.

Czas pakowania (sekundy) dla wszystkich 90 zamówień; trzy strefy pakowania połączono. Wykres pozostaje w języku angielskim. Otwórz wykres w pełnym rozmiarze (otwiera się w nowej karcie) Wybierz kolejne porównanie
Porównaj wielkość zamówień i wymagania pakowania, zanim przypiszesz dłuższy średni czas strefy jej pracownikom.
Więcej szczegółów: omówienie poszczególnych wyników
Pełne tabele wyników zachowują sześć cyfr znaczących, tak jak w sekcji Help.
packing_time_s — statystyki opisowe
Liczebności i położenie: liczby wartości obecnych, brakujących i wszystkich opisują dostępne dane. Średnia to średnia arytmetyczna; mediana to środkowa uporządkowana wartość. Średnia obcięta pomija 5% z każdego ogona zgodnie z konwencją aplikacji.
Rozrzut i niepewność: SD opisuje rozrzut w jednostce pomiaru; wariancja to kwadrat SD. Minimum, maksimum i rozstęp opisują wartości skrajne. Q1 i Q3 ograniczają środkową połowę; IQR to ich różnica. Błąd standardowy opisuje niepewność średniej, a nie rozrzut między zamówieniami. Pozostałe definicje znajdziesz w dodatkowych miarach opisowych.
| Statystyka | Wartość |
|---|---|
| Liczba niebrakujących wartości | 90 |
| Liczba brakujących wartości | 0 |
| Łączna liczebność | 90 |
| Średnia | 150.572 |
| Mediana | 152.9 |
| Średnia obcięta | 150.44 |
| Odchylenie standardowe | 45.2425 |
| Wariancja | 2046.89 |
| Błąd standardowy | 4.76898 |
| Współczynnik zmienności (%) | 30.0471 |
| Minimum | 59.9 |
| Q1 | 113.775 |
| Q3 | 185.275 |
| Rozstęp międzykwartylowy | 71.5 |
| Maksimum | 252.5 |
| Rozstęp | 192.6 |
| Suma | 13551.5 |
| Suma kwadratów | 2222650 |
| Skośność | 0.041393 |
| Kurtoza | -0.917575 |
| Średnia kwadratów kolejnych różnic | 2325.34 |
packing_time_s — podsumowania grup
Grupa to etykieta strefy pakowania; n i liczba braków zliczają dostępne i brakujące pomiary. Średnia i SD opisują każdą strefę oddzielnie. Procent i procent skumulowany opisują udziały uwzględnionych obserwacji w wyświetlanej kolejności grup; nie są wskaźnikami wydajności.
Procenty odnoszą się do niebrakujących pomiarów; kolejność grup odpowiada pierwszemu wystąpieniu.
| Grupa | n | Braki | Średnia | SD | Procent | Procent skumulowany |
|---|---|---|---|---|---|---|
| Mixed_orders | 30 | 0 | 147.403 | 46.8407 | 33.3333 | 33.3333 |
| Informacje pomocnicze | 30 | 0 | 163.897 | 40.4056 | 33.3333 | 66.6667 |
| Small_parts | 30 | 0 | 140.417 | 46.4157 | 33.3333 | 100 |
Metody obliczeń statystyk opisowych
Wiersze te określają konwencje kwartylowe, skośności i kurtozy nadmiarowej. Zachowaj je w raporcie przy porównywaniu podsumowań z różnych programów. Kwartyle wykorzystują interpolację w (n + 1)p z ograniczeniem do wartości krańcowych.
| Statystyka | Wartość |
|---|---|
| Kwartyle | Interpolacja w (n + 1)p z ograniczeniem do punktów końcowych |
| Skośność | Skorygowana Fishera–Pearsona |
| Kurtoza | Kurtoza nadmiarowa skorygowana o obciążenie |
packing_time_s — dominanty
Każdy wiersz przedstawia wartość o największej zarejestrowanej częstości, również przy remisie. Zaokrąglanie może tworzyć powtarzające się wartości; dominanta nie jest ustawieniem docelowym.
| Dominanta |
|---|
| 144.7 |
| 157.8 |
| 174.1 |
packing_time_s — podsumowanie histogramu
Liczba przedziałów określa ich liczbę; szerokość przedziału jest wyrażona w jednostce pomiaru. Skala oznacza częstość, więc wysokości słupków zliczają zamówienia. Zachowaj te ustawienia z wykresem, ponieważ zmiana przedziałów zmienia jego wygląd.
| Statystyka | Wartość |
|---|---|
| Przedziały | 12 |
| Szerokość przedziału | 20 |
| Skala | Częstość |
packing_time_s — podsumowanie wykresu pudełkowego
Q1, mediana i Q3 opisują uporządkowane wartości. IQR to Q3 minus Q1. Granice wynoszą Q1 minus 1.5 × IQR i Q3 plus 1.5 × IQR; wąsy kończą się na najbardziej skrajnych obserwacjach wewnątrz nich. Granice mogą wykraczać poza fizyczny zakres danych. Nie są granicami akceptacji.
| Statystyka | Wartość |
|---|---|
| Dolny wąs | 59.9 |
| Q1 | 113.775 |
| Mediana | 152.9 |
| Q3 | 185.275 |
| Górny wąs | 252.5 |
| IQR | 71.5 |
| Dolna granica identyfikacji wartości odstających | 6.525 |
| Górna granica identyfikacji wartości odstających | 292.525 |
Dodatkowe miary opisowe
Współczynnik zmienności to SD jako procent średniej. Suma i suma kwadratów są sumami arytmetycznymi. Skośność opisuje asymetrię, a kurtoza nadmiarowa — kształt ogonów. Średni kwadrat kolejnych różnic wykorzystuje sąsiednie wartości arkusza, więc zależy od kolejności wierszy. Konwencje kwartylowe i obcinania używane przez aplikację znajdują się w metodach obliczeń statystyk opisowych.
7. Utwórz raport
Zachowaj ogólne Descriptive statistics, Group summaries, Modes, metody obliczeń, ustawienia histogramu, podsumowanie wykresu pudełkowego i wszystkie trzy wykresy. Podaj jednostki i wyjaśnij, że wykresy łączą strefy. Raport pozostaje w języku angielskim.
Wybierz Add to report z zakończonego przebiegu. Otwórz Choose individual items and advanced options aby wybrać tabele i wykresy, a następnie wybierz Add to draft. Ukryte elementy pozostają w zapisanej analizie.
Nadaj raportowi nazwę, dodaj cel badania i swoją interpretację. Wybierz Save, sprawdź Preview, a następnie użyj Export → Download HTML. Poniższy przykład zawiera całą wybraną treść, w tym wyniki wykraczające poza jeden ekran.